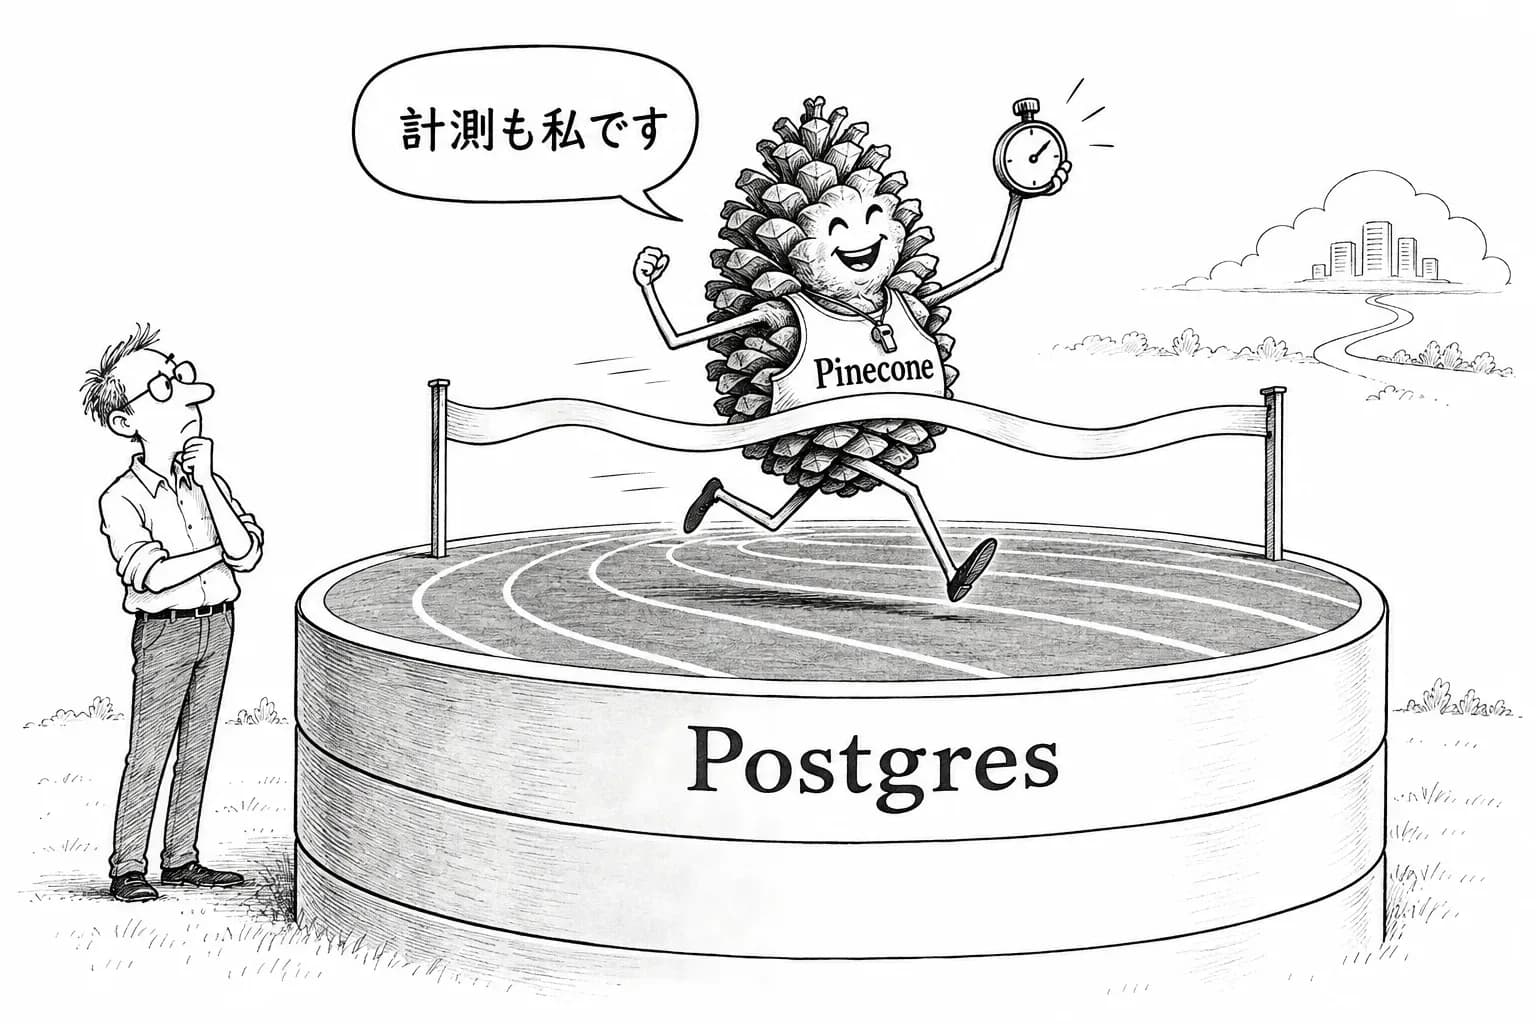
ベクトルデータベースの Pinecone が、自社の検索エンジンを Postgres の拡張「pg_pinecone」として公開した。ライセンスは Apache 2.0 である。Pinecone のアカウントを作らなくても、すでに動いている Postgres の中で RAG の検索を動かせる。データが増えれば、Pinecone のクラウドへ移る道も用意した。Pinecone は、索引の大きさが pgvector の約30分の1で、検索も速いと説明する。ただし、この比較の数字はすべて Pinecone 自身が測ったものだ。
出典は Pinecone の発表ブログ(Introducing pg_pinecone)と製品の文書(pg_pinecone overview)、Pinecone のニュースルームで、いずれも一次情報である。欧州の IT 媒体 Techzine も報じた。
何を出したのか:自社の検索エンジンを Postgres の中へ
pg_pinecone は、Pinecone がクラウドで売ってきた検索エンジンを、Postgres の拡張の形にしたものだ。使う側から見れば、新しいデータベースを立てたり、外のサービスと契約したりせずに、いまある Postgres の表の上でベクトル検索をかけられる。
Postgres のベクトル検索では、これまでオープンソースの pgvector が事実上の標準だった。Pinecone は、その pgvector と同じ場所に、自社の検索の仕組みを持ち込んだことになる。しかも Apache 2.0 なので、手を加えることも、自社の製品に組み込むことも、ライセンスの上では自由である。
検索の結果を引いてモデルに渡す RAG の部分は、いまやどのアプリにも入る前提の技術になった。その検索を、アプリのデータと同じ Postgres の中に置きたいという要望は強い。データを2か所に分けると、同期の手間と、権限を二重に管理する手間がかかるからだ。pg_pinecone は、この要望に正面から応える製品である。
ねらい:入り口は無料で開き、出口を自社クラウドにつなぐ
この発表でいちばん大事なのは、Postgres の中で始めた利用者が、規模が大きくなれば Pinecone のクラウドへ移れるようにした点だ。
ここからは筆者の見立てだが、構図ははっきりしている。ベクトル検索の専用のデータベースは、「Postgres に pgvector を足せば足りる」という声に押されてきた。Pinecone は、その Postgres を敵に回すのをやめ、Postgres の中に自社の技術を置いた。小さいうちは無料で、利用者がふだん使う場所で動く。大きくなって索引の運用が重くなったときに、移る先として自社の有料のクラウドが最初に見える。オープンソースを、自社の商売への入り口にするやり方である。
使う側にとっては、最初から Pinecone と契約するかどうかを決めなくてよくなる。その一方で、pg_pinecone で作った索引やクエリの書き方が Pinecone のクラウドと地続きであるほど、移るときの手間は小さくなるが、ほかの選択肢に乗り換えるときの手間は相対的に大きくなる。Apache 2.0 のコードは手元に残るので、閉じ込められるわけではない。それでも、「移りやすい先」が1つの会社に決まっていることは、知っておいてよい。
数字はすべて Pinecone の測定である
Pinecone は、pg_pinecone の索引が pgvector の約30分の1の大きさで、検索も速いとする。索引が小さければ、同じメモリにより多くのベクトルが載り、Postgres のサーバーを大きくしなくて済む。数字どおりなら、効果は大きい。
ただし、この比較はすべて Pinecone 自身が行ったものだ。発表の時点で、第三者が同じ条件で測った結果は見当たらない。ベクトル検索の比べ方は、条件で答えが大きく変わる。少なくとも次の点は、自分のデータで確かめる必要がある。
確かめるべき条件
1つ目は、再現率(本当に近いものをどれだけ拾えるか)をそろえて比べたかどうかだ。索引を小さくしたり、検索を速くしたりするのは、再現率を少し下げれば難しくない。速さと大きさは、再現率と一緒に見なければ意味がない。
2つ目は、pgvector の側をどう設定したかである。pgvector にも索引の種類と調整の値があり、それによって大きさも速さも変わる。比べる相手を最もよい設定にしたのか、標準の設定のままにしたのかで、「30分の1」の重みは違ってくる。
3つ目は、使ったデータの規模と種類、それに索引を作る時間と、データを足したり消したりしたときのふるまいだ。本番の RAG では、文書は毎日入れ替わる。検索の速さだけでなく、書き込みが続く中で索引がどう保たれるかも効いてくる。
ベンチマークを出す会社が、自社に有利な条件を選ぶのは珍しくない。それ自体は不正ではないが、数字は「Pinecone の測定では」という但し書きをつけて読むべきである。
使う側にとっての意味
これまで、Postgres でベクトル検索をするなら pgvector、専用のサービスを使うなら Pinecone のような会社、という2つの道があった。pg_pinecone は、その間に3つ目の道を作った。Postgres に置いたまま、専用のサービスの会社が作った検索の仕組みを使えるという道だ。
Apache 2.0 で公開したことで、誰でも中身を読み、自分のベンチマークで確かめられる。Pinecone の数字が本当かどうかは、利用者と第三者の測定がこれから決めることになる。いま言えるのは、検索をアカウントなしで既存の Postgres の中で試せるようになったこと、大きくなれば Pinecone のクラウドへの道が開いていること、そして pgvector より小さく速いという話は、今のところ Pinecone の自己申告だということである。