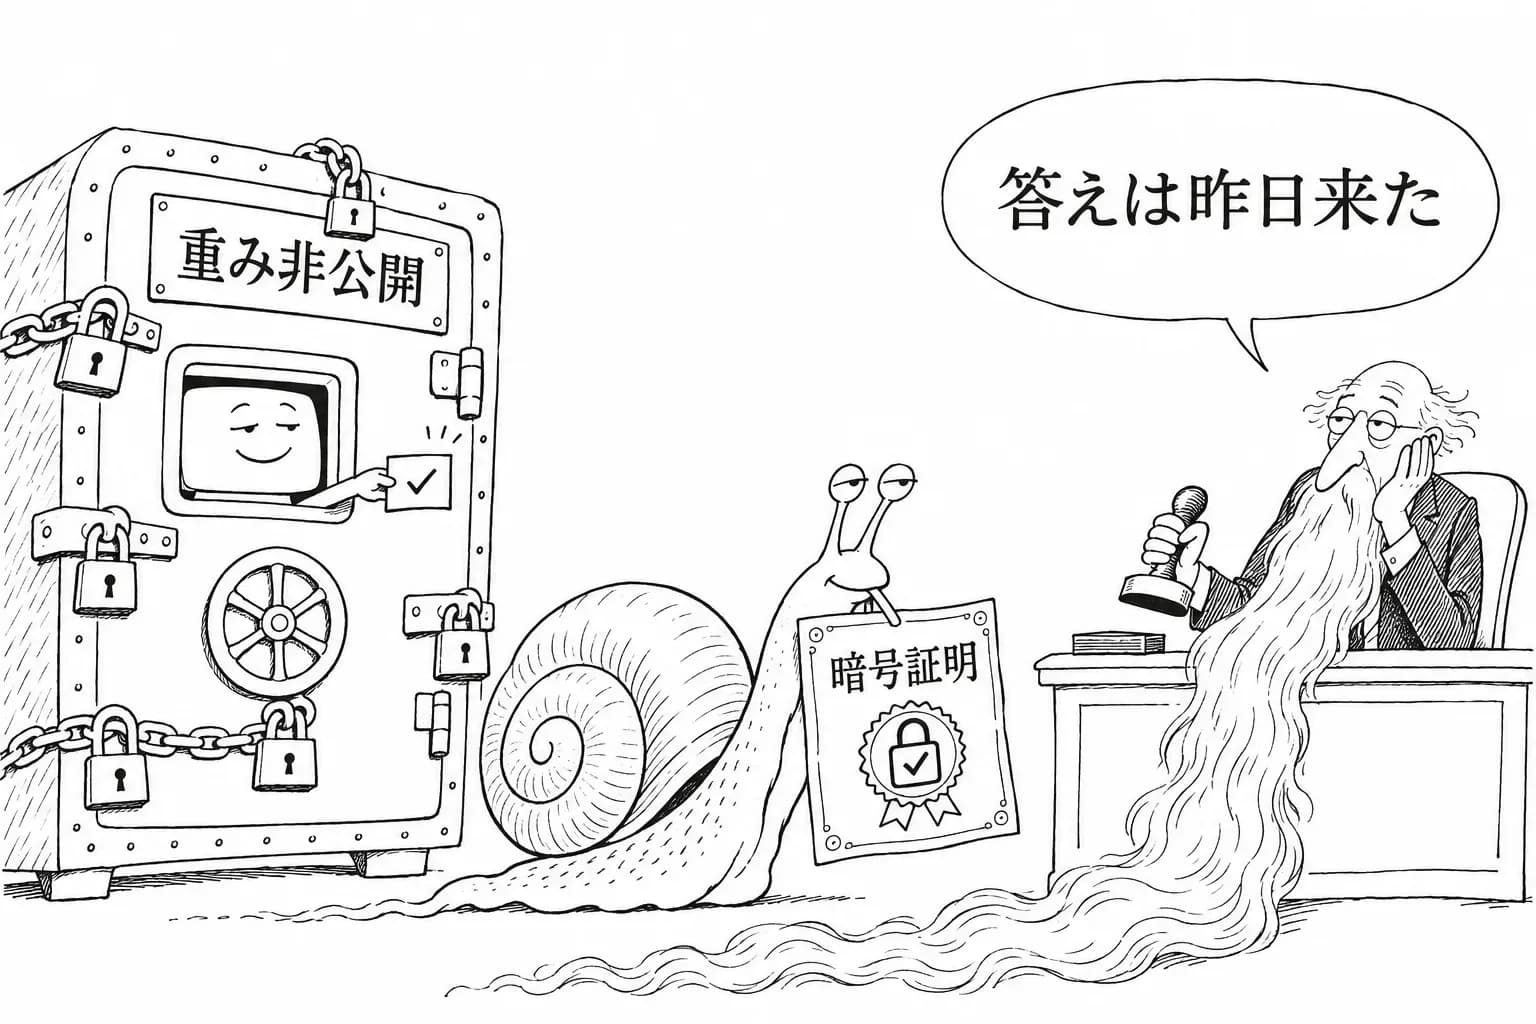
Anthropic が、研究のページに『FlashProve』を公開した。AI のモデルの中身である重み(学習で決まった数値の束)を外に見せないまま、ある答えを本当に『承認されたモデル』が出したことを、暗号の証明で確かめられるようにする仕組みである。確かめる側として想定するのは、外部の評価者や当局だ。Anthropic によれば、速さは実用に近づいた。ただし、ふつうに答えを出すときより、まだ約70〜95倍遅い。
日本の会社にとって:いま使っている Claude の値段や使い方が、すぐ変わるわけではない。関係してくるのは、金融や医療のように、AI の使い方を当局や監査人に説明しなければならない会社である。将来、『契約したモデルで、本当にこの答えを出したのか』を取引先に証拠つきで示せるようになるかもしれない。
何を確かめられるようになったのか
AI の会社が外の評価者に『このモデルを試験し、承認を受けた』と言っても、これまで外の側は、実際にそのモデルが答えを出したのかを自分で確かめられなかった。重みを渡せば確かめられるが、重みは会社のいちばんの財産であり、盗まれれば悪用もされうる。
FlashProve は、この2つを両立させようとする。重みは伏せたまま、『承認されたモデルで、この入力から、この答えが出た』ことだけを、暗号で外に示す。確かめる側は、モデルの中身を知らなくても、証明が正しいかどうかを調べられる。
なお、この記事では、どのモデルで試したか、証明を確かめるのにどれだけの計算が要るか、仕組みやコードを外に出すかといった細部は確かめられていない。
なぜ外の評価者と当局に効くのか
この秋、フロンティアのラボ(最先端のモデルを作る会社)と外の評価者の間では、『どこまで信じてよいか』が繰り返し問われてきた。Anthropic は10月15日、外部の評価機関 METR の職員6人に、社内のリスク評価のチームとほぼ同じアクセスを与えると発表した。その直前には、Anthropic と OpenAI が、評価者が何を公表できるかについて強い編集権を求めていたと Reuters が報じていた(Anthropic は報道を不正確だとした)。
こうした取り決めは、評価者が会社の中に入り、会社の説明を信じることを前提にしている。FlashProve の考え方は、その一部を、信頼ではなく証明に置き換えるものだ。評価者や当局が試験して認めたモデルと、実際に利用者に答えを返しているモデルが同じかどうかを、外から確かめられるようになる。
重みを伏せたままにできる点も大きい。Anthropic は上場の書類で、重みを盗まれないための守りを固めるため、新しいモデルの事前学習を1か月以上遅らせたと書いている。重みを外に渡さずに済む確かめ方は、そうした守りとぶつからない。
まだ毎日には使えない:約70〜95倍の遅さ
弱点は速さである。Anthropic は実用に近づいたとするが、証明を付けて答えを出すと、ふつうの推論より約70〜95倍の時間がかかる。ふつうなら1秒で返る答えが、1〜2分かかる計算になる。
この遅さでは、すべての問い合わせに証明を付けるのは現実的ではない。当面の使い道は、監査のときや、当局が抜き取りで調べるときのように、数を絞った確認になるとみられる。
読みどころ
AI の規制や監査は、これまで『会社がそう言っている』ことに大きく頼ってきた。FlashProve は、その足場を、暗号で確かめられる事実に少しずつ移す試みである。遅さがどこまで縮むか、ほかのラボや当局が同じやり方を採るかが、次の焦点になる。