半導体とAIのインフラを調べる米国の調査会社SemiAnalysisが、AIエージェントの力を測る第三者のベンチマーク「GDPx」を出した。11の専門分野の課題を用意し、1つの課題に最長8時間かけさせる。首位のClaude Opus 5.5(Anthropic)でも、解けたのは12.0%だけだった。もう1つ大事な点がある。サイバー、生物、アラインメント(AIを人の意図どおりに動かす研究)の3分野では、モデルに付いた安全の分類器が働き、そのせいで点が下がった。つまり「どのモデルがいちばん強いか」の答えは、どの分野で測るか、安全策をどう設定するかで変わる。
日本の会社にとって:社内で使うAIを選ぶとき、ニュースに出る総合の順位だけで決めると外れることがある。とくにセキュリティの点検や研究開発でAIを使う会社は、安全の仕組みに作業を止められて、思ったほど働かない場合がある。自社の実際の業務で試してから決めるほうが確かだ。
8時間かけても1割強しか解けない
GDPxは、短い質問に答えさせる試験ではない。専門家が何時間もかけてこなす種類の仕事を、エージェントに最後までやらせる。1つの課題にかけられる時間は最長8時間だ。名前の「GDP」が示すとおり、経済の中で実際に価値を生む仕事に近い課題を集めたものとみられる。
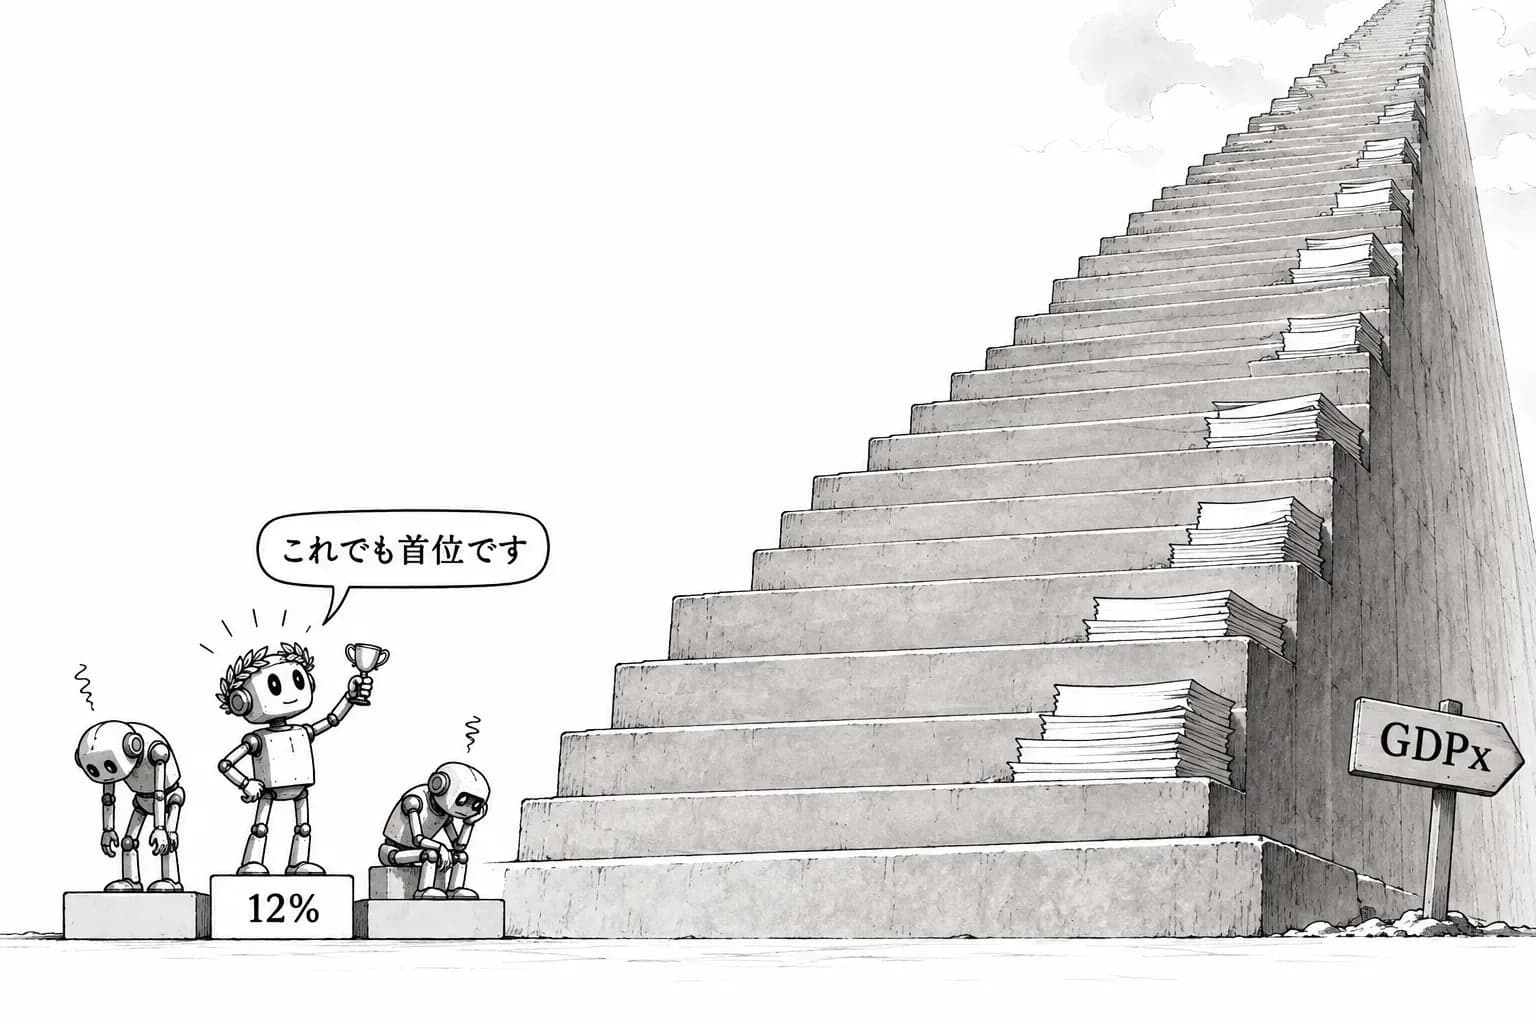
結果は厳しかった。首位はOpus 5.5で、それでも正答は12.0%だった。言いかえれば、いちばん強いモデルでも、8割8分の課題は最後までやり切れていない。ほかの指標では、上位のモデルが軒並み高い点を取り、差がつきにくくなっている。GDPxは課題を長く難しくして、まだ伸びしろが大きいことを数字で見せた形だ。
出したのはSemiAnalysisで、モデルを作る会社ではない。各社が自分で出す数字ではなく、外から同じ条件で測った数字という点に意味がある。
安全の仕組みが点を下げた3つの分野
この試験でいちばん目を引くのは、サイバー、生物、アラインメントの3分野の結果だ。ここではモデルの力が足りなかったのではなく、安全の分類器のせいで点が下がった。安全の分類器とは、攻撃のコードや危険な生物の情報など、悪用されうる依頼を自動で見分けて止める仕組みのことだ。
課題そのものは正当な仕事でも、中身が攻撃の手口や病原体の性質に触れると、分類器は危ない依頼と見分けがつかずに止めてしまう。その結果、そのモデルは本来の力より低く採点される。アラインメントの研究も、AIのずれたふるまいを再現する作業を含むので、同じことが起きやすい。
これは欠点というより、各社が意図して選んだ取引だ。悪用を防ぐ代わりに、正当な専門の仕事でも一部は断る。GDPxは、その代償を点数として外から見えるようにした。
順位は「何で測るか」で入れ替わる
同じことは、ほかの第三者の評価でもすでに起きている。Artificial Analysis(AIモデルを比べる第三者の評価会社)の総合の指数では、10月末にOpus 5.5が58点で首位に立ち、翌日にGoogleのGemini 4 Carbonが59点で抜いた。一方で、端末の操作を測るTerminal-Bench 4.0では、Carbonが65.2%で、Opus 5.5の59.6%を上回っている。物差しを変えれば、首位はすぐに入れ替わる。
安全策の設定でも順位は動く。Artificial Analysisのサイバーの指数では、審査を通った組織だけが使えるOpenAIの版が、安全策で止められないぶん、一般向けの同じ系統のモデルより32点高かった。OpenAIは10月30日、生物向けのGPT-Rosalind-6を出した。これはGPT-6 Astraと同じ重みで、追加の学習はせず、危険になりうる生物の質問を断る回数を減らしただけだ。それで専門の試験の点が大きく上がった。Anthropicも、審査を通ったセキュリティの担当者に、制限の少ない版を出す仕組みを持っている。
GDPxの結果は、こうした流れと合う。いまのモデルの「強さ」は、重みそのものの力だけでは決まらない。誰に、どの安全策の設定で出すかで、使える力が変わる。
道具を選ぶ側が見るべきこと
読み取れることは3つある。
1つ目に、総合の順位は目安にすぎない。営業の資料づくり、経理の点検、コードの修正、セキュリティの診断では、向いているモデルが違いうる。
2つ目に、長い仕事を丸ごと任せるには、まだ早い。8時間の課題で首位でも1割強という数字は、エージェントに任せるにしても、途中で人が確かめる段取りが要ることを示している。
3つ目に、セキュリティや研究開発の部署は、安全の仕組みに止められる前提で考えたほうがいい。必要なら、各社が用意している審査つきの提供の窓口を調べる価値がある。安全策が強いモデルほど、正当な専門の仕事でつまずきやすい。それを知ったうえで選ぶことが、2026年の「評価の年」に求められている。