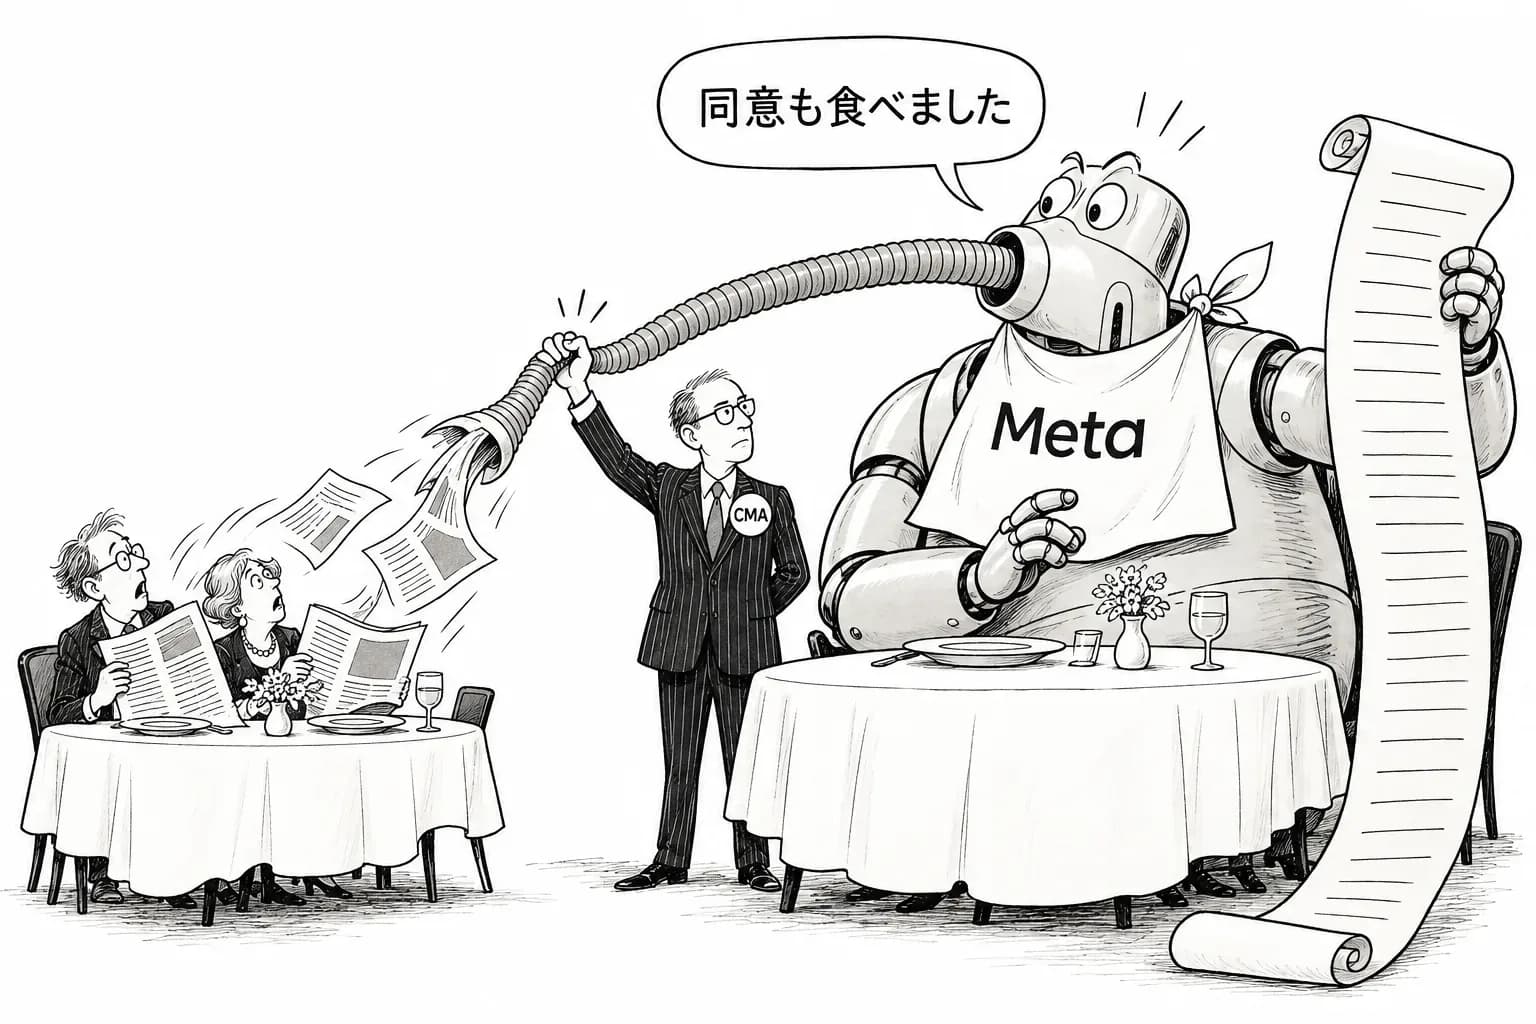
英国の競争・市場庁(CMA)が、Meta の規約を調べ始めたと Reuters が報じた。焦点は、媒体のウェブの中身を、同意を取らずに Meta の AI に使わせる条件である。CMA は、この規約が支配的な地位の濫用に当たるかを調べるという。AI が中身を使うことに競争法で切り込むのは、これが最初の事案と伝えられる。Meta は、11月20日に予定していた規約の変更を止めたと報じられている。
この記事はReuters の配信による報道ベースである。CMA の発表と Meta の規約の原文には、まだ当たれていない。
何が報じられたか
報道によると、調べる対象は Meta の規約で、媒体のウェブの中身を AI に使う条件を定めた部分である。問題とされているのは、媒体が同意していなくても、その中身を Meta の AI に使えるようにする点だ。
CMA が問うのは、著作権を侵したかどうかではない。Meta が市場での強い立場を背に、媒体に断りにくい条件を押しつけていないか、という競争の問題である。Meta の配信を頼る媒体にとって、条件を拒むことは、読者に届く道を失うことにつながりうる。調べの中心は、その力の差だとみられる。
Meta は、11月20日に変える予定だった規約を止めたと伝えられる。止めたのが調べを受けてなのか、一時的な措置なのかは、報道からは分からない。
なぜ「最初の事案」なのか
これまで、AI が媒体の中身を使うことをめぐる争いは、主に3つの形で起きてきた。著作権の訴訟、個別のライセンスの交渉、そして robots.txt のような、媒体が自分で出す合図である。
3つとも、媒体が1社ずつ動くか、AI の会社が自分から応じることが前提になる。競争法の調べは違う。規制当局が、プラットフォームが一方的に決める条件そのものを問う。報道のとおりなら、AI の学習や回答に中身を使う条件が、初めて市場の支配力の問題として扱われることになる。
自主的な合図との関係
10月30日には、OpenAI、Google、Microsoft、Anthropic が、AI の学習を断るときの robots.txt の共通の印『__usage_ai-training』を受け入れると伝えられた。土台は IETF の AI Preferences 作業部会で、学習に使うことと、答えの根拠に使うことを分けて扱う。Meta もこの動きにかかわると報じられたが、4社と並んで受け入れを表明したわけではない。
この印は、媒体が断る手段をそろえるものだ。ただし、印を守るかどうかは AI の会社に委ねられている。媒体が断ると、配信や検索で不利になるおそれがある。この問題も残る。CMA の調べは、そこに踏み込む。断る手段があっても、断れば不利になる条件なら、同意は形だけになる。報道されている調べの焦点は、この点に重なる。
まだ分からないこと
一次情報で確かめられていない点は多い。
CMA の発表:どの法の枠組みで調べるのか。正式な調査か、予備的な調べか。結論の時期はいつか。
規約の中身:どの媒体が、どのサービスで、どの AI の用途(学習か、回答か)に中身を出すことになっていたのか。
Meta の説明:変更を止めたのは英国だけか、世界でか。止めたのはいつまでか。
ほかの国:欧州など、英国の外の当局が同じ論点で動くかどうか。
見出しにある「媒体の中身を AI に使う条件」は、これからは媒体と1社ずつ結ぶ契約の話では済まなくなる可能性がある。規制当局がプラットフォームの規約を問う形になれば、学習を断る印や個別のライセンスと並ぶ、第3の歯止めになる。CMA の正式な発表が出たら、その範囲を確かめる。