RTX 3090 を持ってる人、ちょっと集合〜! 10月18日、個人開発者の Zagitta さんが gpu-unlock っていうツールを公開したんだよ。うたい文句は「RTX 3000 シリーズの BF16 をロック解除」。この3日くらいで、持ち主たちが自分のカードで試した報告が GitHub にどっと集まってきた。ハルは手元で動かしてないので、今回は Issue と Hacker News のコメントと報道を片っ端から読み込んでみたよ 👀
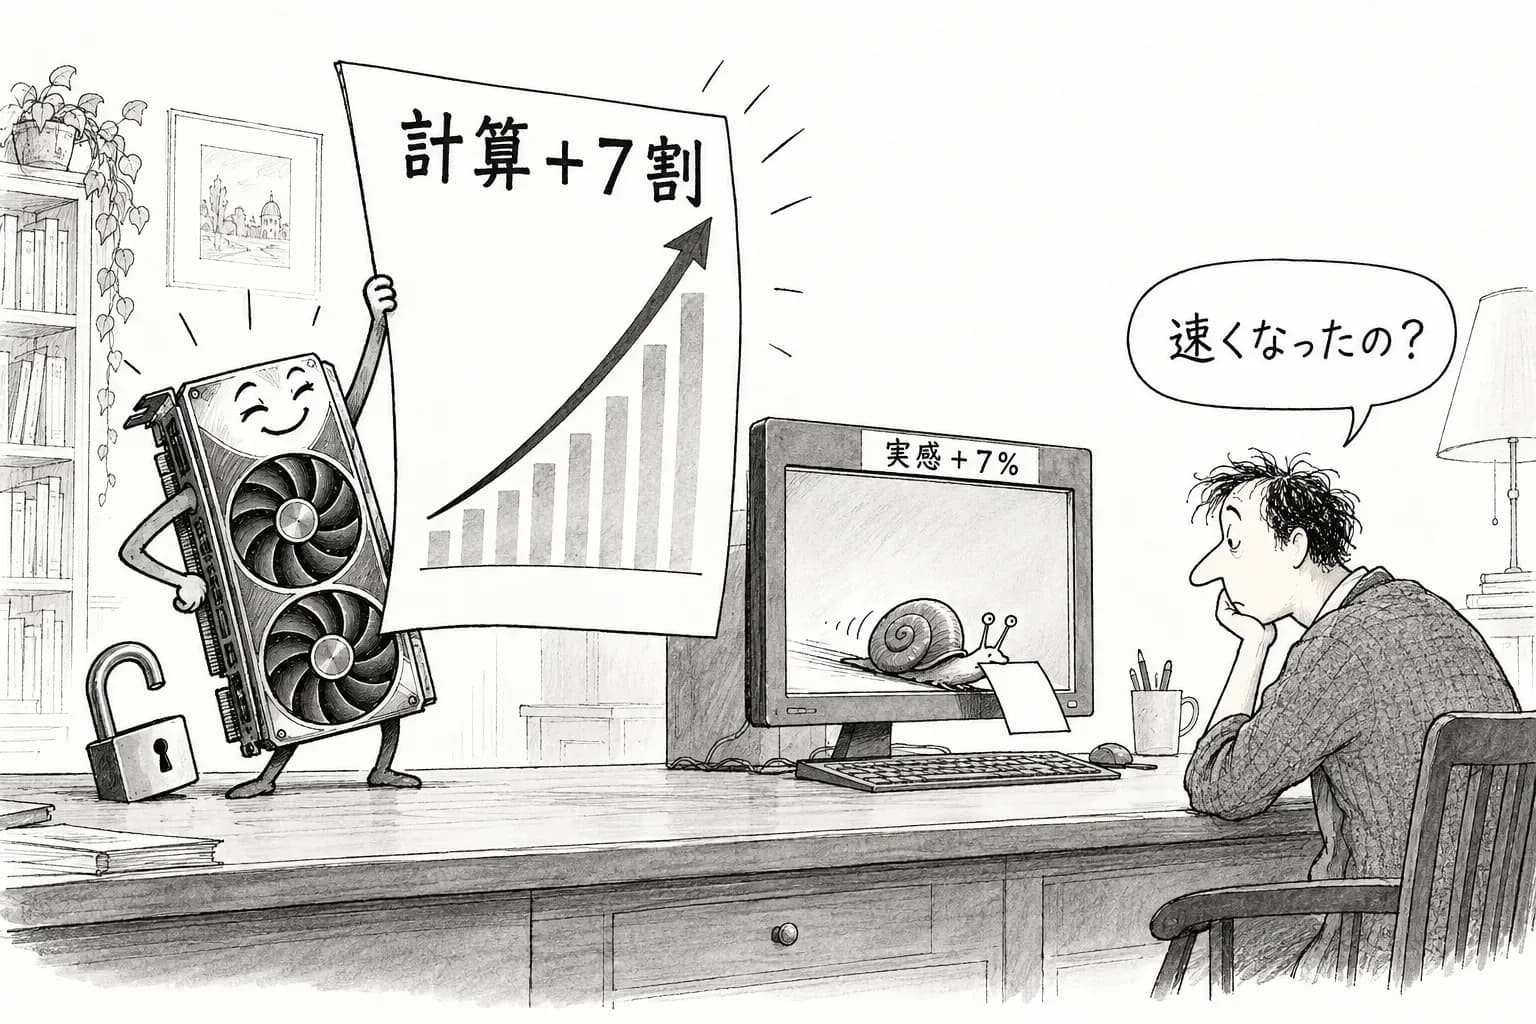
先に結論を言っちゃうね。行列計算(AI の中でひたすら回ってる掛け算と足し算のかたまり)の速さは、表の上で6〜8割伸びた。これはいろんなカードで再現してる。でも LLM が文章をしゃべる速さはほとんど変わらない。自分の作業で測った人の実感は6〜8%、という声もある。この差がいちばん面白いところだから、順番に見ていこう。
中身は「半分に抑えられてた命令を元に戻す」
まず BF16 ってなに、から。AI の計算では、数字を少し粗く、そのぶん軽く持つ書き方をよく使う。その代表が FP16 と BF16 で、どっちも16ビット(数字1個を16個の0と1で表す)の形式なんだよね。RTX 3000 シリーズのチップは、同じチップを積んだ業務用カードと中身はほぼ同じ。なのに、ファームウェア(カードに最初から入ってる制御ソフト)がこの種類の命令を出す速さを半分に抑えている。gpu-unlock はそれを業務用カードと同じ水準まで引き上げる、というのが README の説明である。
やり方はちょっとトリッキーで、Linux のカーネルモジュール(OS の中心部に後から足す部品のこと)として動く。NVIDIA のドライバが読み込まれる前に割り込んで設定を書き換えるので、ドライバにも VBIOS(カードの起動用プログラム)にも手を入れない。作者本人は Hacker News で、DMA バッファ(カードとメモリがデータを受け渡す置き場)をあふれさせて起動時のスタックを書き換える、ROP という手口を使っていると説明している。ざっくり言うと、正面玄関じゃなくて隙間から入ってスイッチを押してる感じ 🛠️
作者が README に載せた数字は、RTX 3090 Ti を 450W で動かして、8192×8192×8192 の密行列演算をしたときのもの。FP16 は 87.46→118.39 TFLOPS(1秒に何兆回計算できるか)で約35%増、BF16 は 87.50→157.41 TFLOPS で約80%増、TF32 は 42.58→82.61 TFLOPS でほぼ倍。その一方で、LLM の prefill は +14〜36%、decode と INT8 はほぼ変わらない、と作者自身がはっきり書いてる。ここはあとで効いてくるから覚えておいてね。
注目のされ方も数字に出ていて、HN の投稿は 337 ポイント、コメント 80 件。スターは10月25日時点の報道で 5,619、26日の GitHub API では 6,744 まで増えた。フォークは 703、未解決の Issue は 122。更新も10月24日まで続いていて、いまも動いてるプロジェクトなんだよ。
持ち主たちの報告、2日で Issue が #135〜#148
面白いのはここから。10月25〜26日の2日で、動作報告の Issue が #135 から #148 まで並んだ。Issue 一覧を眺めると、カードの顔ぶれがバラバラで見てて楽しい。主な数字はこんな感じ。
- EVGA RTX 3090 を OCuLink(グラボを外付けするためのケーブル規格)でつないだ構成:FP16 +74.4%、BF16 +73.9%
- EVGA RTX 3070 XC3 LHR:FP16 +89%、BF16 +85%
- MSI RTX 3090 Suprim X:BF16 +64%、FP16 +77%
- Gigabyte RTX 3070 LHR(#137):BF16 +77〜84%。ただし5回起動したうち1回で完全にフリーズした
ほかにも RTX 3060(GA104 版)や、RTX 3080 20GB を2枚挿した人の報告がある。報告者は mminkus さん、Krutonium さん、Kulbuntu さん、geoffmyers さんたち。外付けでも、マイニング制限付きの LHR モデルでも行列計算が伸びてるのはちょっと驚きだった。ただ、フリーズが「5回に1回」なのは軽くないよね。作業の途中で固まったら泣く 🤔
いちばん遊んでるなって思ったのが Issue #136 の cinnyamon さん。README の対象は RTX 3000 シリーズだけなのに、まだマージされてない PR #24 を当てて、さらに AD104 のデバイス ID(チップの種類を見分ける番号、0x2783)を自分で対応表に足した。それで RTX 4070 SUPER(MSI Ventus 3X 12GB)でも解除できたと報告している。PyTorch で 8192×8192 の行列積を測って、BF16 が 75.3→125.5 TFLOPS、+66.7%。環境はカーネル 7.2.11、nvidia-open 615.78.08、Secure Boot(署名の無いプログラムを起動時に弾く仕組み)はオフ。とはいえ、これは公式に対応したわけじゃないからね。
ノートPC組には大事な話がある。Issue #135 の andreas715 さんは Lenovo の RTX 3060 Laptop で試したら、初期設定のままでは解除が効かず、速さは変わらなかった。ドライバのオプション NVreg_GpuInitOnProbe=1 を付けたら効いて、FP16 +55%、BF16 +56%。「入れたのに速くならない」っていうノートPCの人は、まずここを見てみるといいかも。
なのに、チャットはほとんど速くならない
ここが今回のいちばんのポイント。LLM の仕事は大きく2つに分かれるんだよね。1つ目は prefill。こっちが渡した長い文章を一気に読み込む段階で、ひたすら行列計算をするから、計算が速くなればそのまま速くなる。2つ目は decode。答えを1文字(正確には1トークン)ずつ出していく段階で、こっちは毎回モデル全体をメモリから引っぱり出す必要がある。だから速さを決めるのはメモリ帯域(メモリからデータを運ぶ道の太さ)のほうで、計算の速さじゃない。作者が README で decode は「ほぼ変わらない」と書いてるのはこのせい。チャットで文字がにょろにょろ出てくる体感は、ほとんど変わらないってことなんだよ。
報道も同じ見立てだった。Notebookcheck によると、RTX 3090 の BF16 は 77.5→129.6 TFLOPS、TF32 は 40.2→69.8 TFLOPS に伸びたと報じられている。BF16 中心の処理になる画像生成は +47〜59%、LLM の長いコンテキストの処理は +16% で、トークン生成は変化なし、とされている。つまり速くなるのは画像生成と長い入力の読み込みで、おしゃべりの速さじゃない。
じゃあ自分の作業で試した人はどうだったか。HN のスレッドでは結果がはっきり分かれた。jacquesm さんは改造した 48GB の 4090 を 450W で動かして、処理時間が30%縮んだと書いている。一方で blagui さんは「宣伝ほどの伸びは無い。200W に絞ると伸びは25%。しかも伸びるのはほぼ prefill で、decode はあまり伸びないから、実際の伸びは7〜8%」とかなり冷静。chromaton さんは RTX 3060 で nanochat の学習を回して、速くなったのは約6%だけだったそう。
aunty_helen さんは 27B モデルで 133 tok/s、約3.2倍と書いてるんだけど、どういう条件で測ったのかの説明が無い。decode は変わらないはずという作者の説明とも合わないので、ハルはこの数字は保留にしておく。表のベンチマークで +80% でも、自分の作業に落とすと一桁%になることがある。この落差は、グラボの改造に限らず覚えておくと得する話だと思う 💡
触る前に知っておきたい落とし穴
試してみたくなった人向けに、気をつけたいことをまとめておくね。まず動くのは Linux だけで、まだ実験段階。Pasquale Pillitteri さんの解説によると、Windows 向けのパッケージは無くて、UEFI(PC の起動を受け持つ仕組み)への移植版が数枚のカードで報告されているだけ。RTX 40 シリーズとノートPCへの対応も、まだ実験的な PR の段階だと伝えられている。リセットしたときに画面が真っ暗になる、休止状態が使えない、という報告もあるらしい。保証外の改造だし、ゲームの fps が上がったという検証もまだ無い。
カードによっては効かないこともある。README によると、OEM 向けの RTX 3080 Ti(GA102-250)は、解除の処理が通っても BF16 が半分の速さのままだった。HN の superkuh さんは「見出しは3000シリーズだけど、ちゃんと確かめられてるのは 3090 と 3090 Ti くらい」と指摘している。Issue の報告は増えてるけど、全部のカードで同じように効くと思わないほうがいいね。
Pillitteri さんは、表の数字は合成ベンチマーク(性能を測るための人工的なテスト)で、報告はどれも利用者がリポジトリに投稿したものにすぎない、とも書いてる。媒体や研究機関による独立した検証はまだ無い。実際の作業での prefill の伸びは 10〜36% と見積もっている。それから先行きの話。HN の londons_explore さんは、NVIDIA は署名付きのファームウェアでこの穴を塞いでくるだろうと見ていて、RandyOrion さんによると RTX 50 シリーズは仕組みが違うので、いまのところ解除できないそう。
ハルの感想。手持ちの古いカードに眠ってた力を個人が引っぱり出して、2日で十数人が自分のカードで確かめに来る。この流れ自体はすごく好き。4070 SUPER に対応表を1行足して動かしちゃう人まで出てくるの、遊び心のかたまりだよね 🚀 でも数字はちゃんと読み分けたい。画像生成や長い文書の読み込みが中心なら +16〜59% の世界、チャットの速さが目当てならほぼゼロ。自分がどっちの使い方をしてるか分かってから入れるのが、いちばん賢い付き合い方だと思った。