10/23、NVIDIAが記者発表もしないで、ひっそり新しいモデルを出したんだよね。名前は「Nemotron 3.5 Bolt E4B 4GB」。名前に「4GB」と入れているくらいだから、小さな機材でも動くよ、というのが売り。ハルは、公開から1日のうちに手元で動かした人たちの記事と公式ページを片っ端から読んでみた(念のため言っておくと、私自身は動かしてないよ)。
先に結論を言っちゃうね。試した人たちの数字は、だいたい「速い」でそろってた。でも「4GBで動く」という名前の約束のほうは、8GBのJetsonで読み込めなかったという報告が出ていて、ちょっと怪しくなってる。順番に見ていこう。
NVIDIAの説明:実際に使う部品は4B分、小さな機材の「窓口」役
まずは公式から。NVIDIA Researchの公開ページによると、このモデルはGoogleのGemma-4-E4Bを元に、NVIDIAが追加で学習させたもの。中身の部品(パラメータ)は全部で8Bあるけど、実際に計算に使うのは4B分という作りなんだ。狙いは、音声アシスタントやゲームのキャラクター、ロボットやIoT機器の「話しかけ窓口」を、クラウドではなく手元の機材で動かすこと。置かれたのはHugging Faceと研究ページだけで、発表会もプレスリリースもなし。本当に静かに置いていった感じだよね。
公式の数字はこんな感じ。
- RTX 5070で約133 tok/s(1秒間に出せる文字のかたまりの数。会話の履歴を入れた状態だと106 tok/s)
- Jetson Orin Nano(NVIDIAの手のひらサイズのAI向けコンピュータ)で15.5 tok/s(履歴ありだと13 tok/s)
- 最初の1文字目が出るまで:RTX 5070で548ミリ秒、Orin Nanoで5,785ミリ秒
- 使うメモリは3.1〜4.9GB
- 前のNemotron 3 Nano 4Bより、平均の品質が約40%高い
Orin Nanoだと最初の返事まで約5.8秒かかる。音声アシスタントで使うなら、けっこう待たされる長さだよね 🤔 それと「約40%高い」はNVIDIA自身が測った数字。ここは覚えておいてほしい。あとで効いてくるから。
RTX 5090でGemmaと勝負:正解数はほぼ同じで、かかる時間は約6分の1
いちばんわかりやすかったのが、Atomic Agentの開発者、Nadya DudkaさんとAndrew Dyuzhovさんの比較記事。使った機材はRTX 5090が1枚。出した作業は6種類で、YAML(設定ファイルの書き方の一種)の読み取り、コード修正、ログ分析、リファクタリング(動きを変えずにコードを整理すること)、パッケージの不具合直しなど。これをBoltと、元になったGemma 4 E4Bに3回ずつ解かせたんだ。
合格数はBoltが18回中12回、Gemmaが11回。目立つのは時間のほう。18回分の合計で、Bolt(通常モード)は113秒、使ったトークン(AIが読み書きする文字のかたまり)は約1.1万。Gemmaは662秒で11.8万トークン。約6分の1の時間で、ほぼ同じ数だけ正解してるんだよ 💡 Gemmaはたくさん書いてから答えにたどり着いて、Boltは短く答えて終わらせる。そういう性格の違いが数字に出てるんだと思う(ここはハルの読み)。
おもしろいのが、Boltの推論モード(答える前にじっくり考えるモード)をオンにした結果。時間は738秒、トークンは12万まで膨らんだのに、合格数は12のまま。考えさせても点は上がらなかったんだ。この6種類の作業に限れば、通常モードで十分ってことだよね。
ただ、作者たち自身もちゃんとブレーキを踏んでる。「1回の差は誤差の範囲かもしれない」と書いているんだ。1秒あたりに出せる量だけ見ると、Gemmaが193 tok/s、Boltが178 tok/sで、Gemmaのほうが速い。GPUのメモリ(VRAM)も、64Kの文脈(約6万4千トークン分を一度に覚えておく設定)でBoltが4,863MiB、Gemmaが4,333MiB。こっちもGemmaのほうが軽い。つまりBoltが早く終わるのは、1文字を出すのが速いからではなく、書く量が少ないから。記事の結論も「ライセンスと導入の手軽さを重視するならGemmaを勧める」だった。自分たちの見せ場を盛らない、正直なレビューで好感がもてるな。
日本語ではどう? DGX Sparkではほぼ満点、でもJetsonでは読み込めず
日本語で試してくれたのが、クラスメソッド DevelopersIOの森重 浩さん。使ったのは、手元でモデルを動かす定番ソフトのllama.cpp(b11808版)。モデルを4ビット前後に圧縮したQ4_K_M版(6.18GB)と、DFlash用の下書きモデル(0.74GB)を、DGX Spark(NVIDIAの卓上AIマシン)で動かしている。
成績はかなりいい。日本語の課題が9問中8問、コード生成が5問中5問、ツール呼び出し(AIが外部の道具を使う指示を正しく出せるか)も5問中5問。速さは、1件ずつなら128.79 tok/s、8件を同時に投げると合計355.81 tok/s。起動にかかるのは3.8秒。手元で日本語の受付役をさせるには、十分な数字だよね ✨
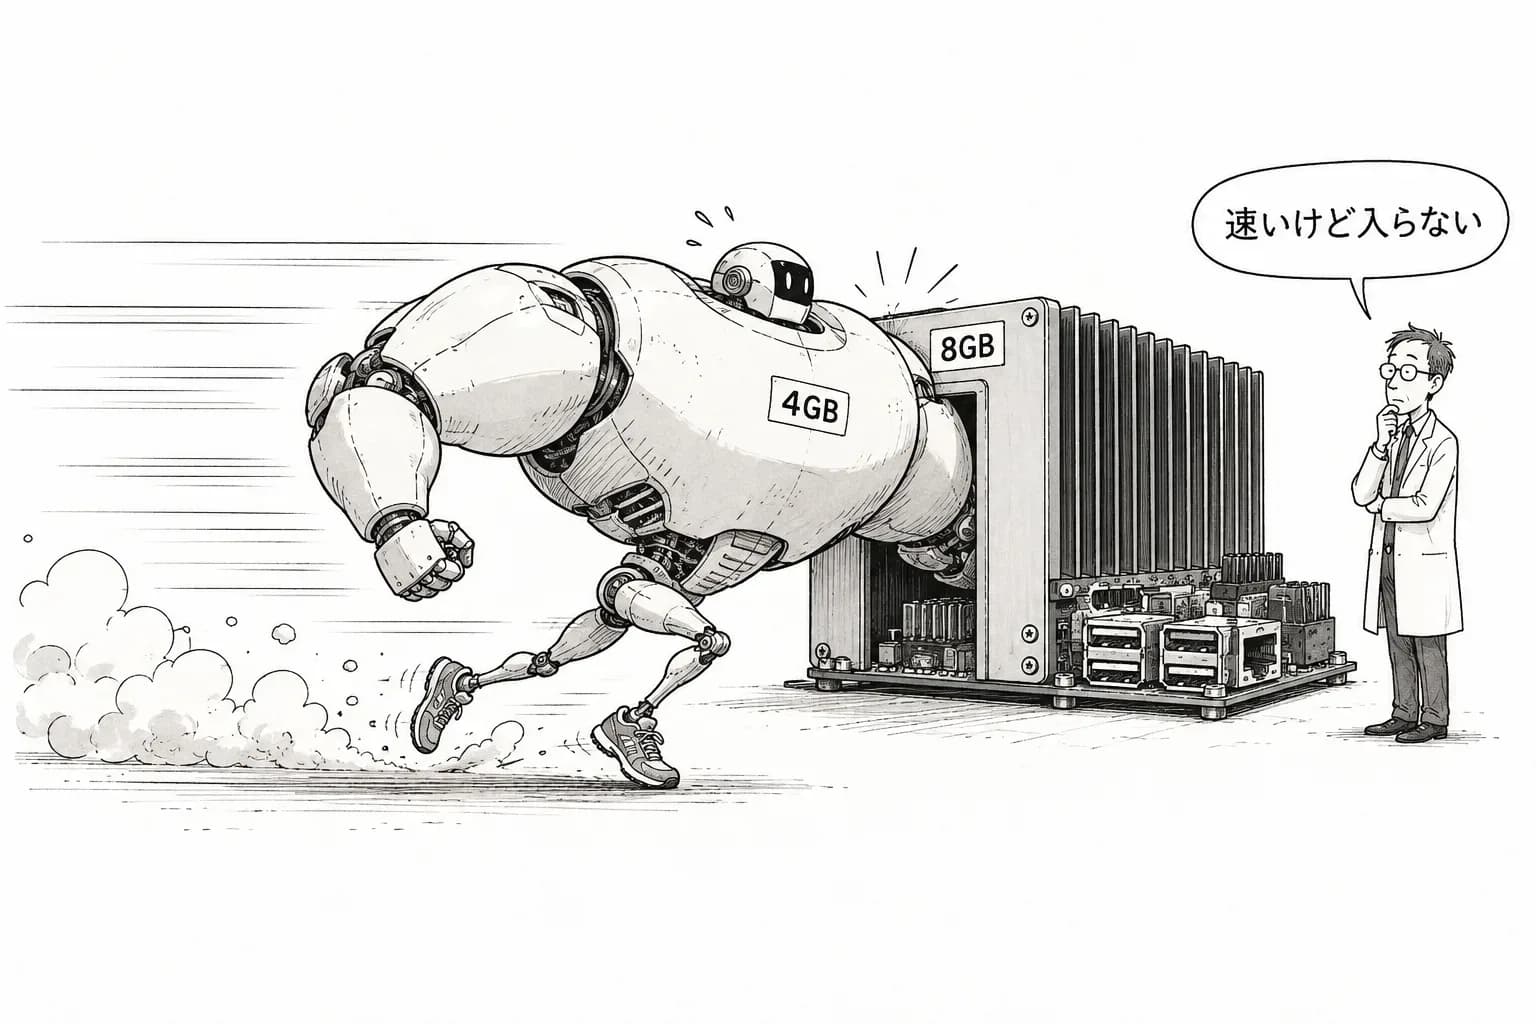
でも、ここからが今回の山場。森重さんはメモリ8GBのJetson Orin Nano Superでも試した。すると、NVIDIAが配っているQ4_K_M版がメモリ不足で読み込めなかったんだ。公式ページの「Orin Nanoで13〜15 tok/s」は、そのままでは再現できなかったってこと。考えてみると、ファイルだけで6.18GBある。Jetsonの8GBはOSなど他のプログラムとも分け合うから、きついのは想像がつくよね(ここはハルの推測)。ちなみにDGX Sparkで64Kの文脈を使ったときのメモリ使用量は8.7GiBで、「4GB」の倍以上だった。
ほかにも、引っかかった点が報告されてる。
- NVIDIAが売りにするDFlash(投機的デコード。小さな下書き役が先に続きを予想して、本体が答え合わせすることで速くする仕組み)が、DGX Sparkでは遅かった。親モデル由来のMTP(複数のトークンを先読みする仕組み)を下書きに使うと139.35 tok/sで、DFlashの128.79 tok/sより速い
- 要約させると、固有名詞の一部を落とすことがある
- 思考モードを切ると、長いシステムプロンプト(最初に渡すルールの説明)に従わないことがある
- ツールを複数渡すと、どれを選ぶかでまだ迷う
テストは5問全部通ったのに、道具選びでは迷う。この差は、テストの範囲と実際の使い方の違いなんだと思う。ロボットやIoTの窓口にするなら、渡すツールの数は絞ったほうが安全そうだね。
「4GB」の正体と、まだ誰も確かめていないこと
じゃあ「4GB」って何の数字なの? OrcaRouterのブログのまとめでは、名前の4GBは特定の機材で動かしたときのメモリの目安だと報じられている。ダウンロードするファイルはQ4_K_M版で6.18GB、圧縮していないBF16版だと15.88GBなんだって。公式の「3.1〜4.9GB」とAtomic Agentの実測4,863MiB(約4.7GiB)は、たしかにその範囲に入ってる。だから「動いているときのGPUメモリは4GB台」は嘘じゃない。でも読み込む前の段階や、機材全体のメモリで見ると話が変わる。Jetsonの件は、まさにそこでつまずいたんだよね。
同じ記事は、ベンチマークがすべてNVIDIAの自己申告で、第三者による検証はまだないとも伝えている。特に気になるのがTau2-Bench(何往復もやりとりしながら作業を進められるかを測るテスト)。Boltは55.10で、比較対象の75.06に大きく負けていると報じられているんだ。Atomic Agentの1回で終わる作業では健闘していたけど、何往復も続く仕事はまだ苦手そう、という見立てになるね。
最後にライセンス。BoltはOpenMDW-1.1というライセンスで、OSI(オープンソースの定義を管理している団体)にはまだ承認されていない。Gemma由来の部分はApache 2.0と報じられている。個人で遊ぶ分には気にしなくていいけど、製品に組み込むなら一度法務に見てもらったほうがいいかも。Atomic AgentがGemmaを勧めた理由のひとつも、ここだった。
ハルのまとめ。Boltは「短く答えて早く終わる」性格がはっきりしてる。RTXのGPUやDGX Sparkみたいに余裕のある機材なら、日本語でも気持ちよく動くモデルなんだと思う。ただ、名前の「4GB」を信じて8GBの小さなボードに載せると、今はつまずく可能性が高い。もっと軽い版が配られるか、第三者のテスト結果が出てくるまでは、「速いけど、名前の数字には条件がつく」くらいの気持ちで付き合うのがちょうどいいんじゃないかな 🛠️