OpenAI が9月22日、GPT-6 系列に Sol と Luna を追加した(一次情報)。告知を読んで最初に気づくのは、書かれていることではなく書かれていないことのほうである。新しいベンチマークの自己申告がない。context 長の拡張もない。新しいモダリティもない。エージェント能力の改善を示す社内スコアの一覧も出てこない。更新されたのは価格表だけだ。そして Luna の入力100万トークンあたり0.10ドルという一行が、今週の AI 産業で最も重い数字になった。
これは能力の発表ではなく、値付けの発表である
この業界の発表文には定型がある。まず自社ベンチマークの棒グラフが並び、次に「前世代比で何倍」という見出しが来て、価格は最後の表に小さく載る。今回はその順序が逆転しているというより、前半が丸ごと存在しない。Sol は既存の中位帯を置き換える位置にあり、Luna はその下に新しく敷かれた床である。OpenAI はこの2つについて、何かが賢くなったとは言っていない。安くなったと言っている。
そして、この種の値下げに対して市場がまず疑うこと — 新規獲得のための期間限定の出血 — を、OpenAI は先回りして潰している。
These are our standard prices, not promotional pricing.
訳: これらは暫定価格ではなく既定の価格である。
この一文が入っていることの意味は大きい。暫定価格であれば、エージェント製品の事業計画は「半年後に3倍に戻る前提」で原価を積まなければならず、実際にはフロンティア API を本番の主系統に据えられない。既定の価格だと明言された瞬間に、その留保が外れる。値下げを販促費として会計処理できないということは、OpenAI 自身がこの原価で回るという主張をしたに等しい。
0.10ドルは、どこの下を潜ったのか
比較対象はもはや同業のフロンティア API ではない。エージェント製品を作っている企業がこの数か月で実際に逃げ込んでいた先、つまりオープンウェイトの実勢価格である。
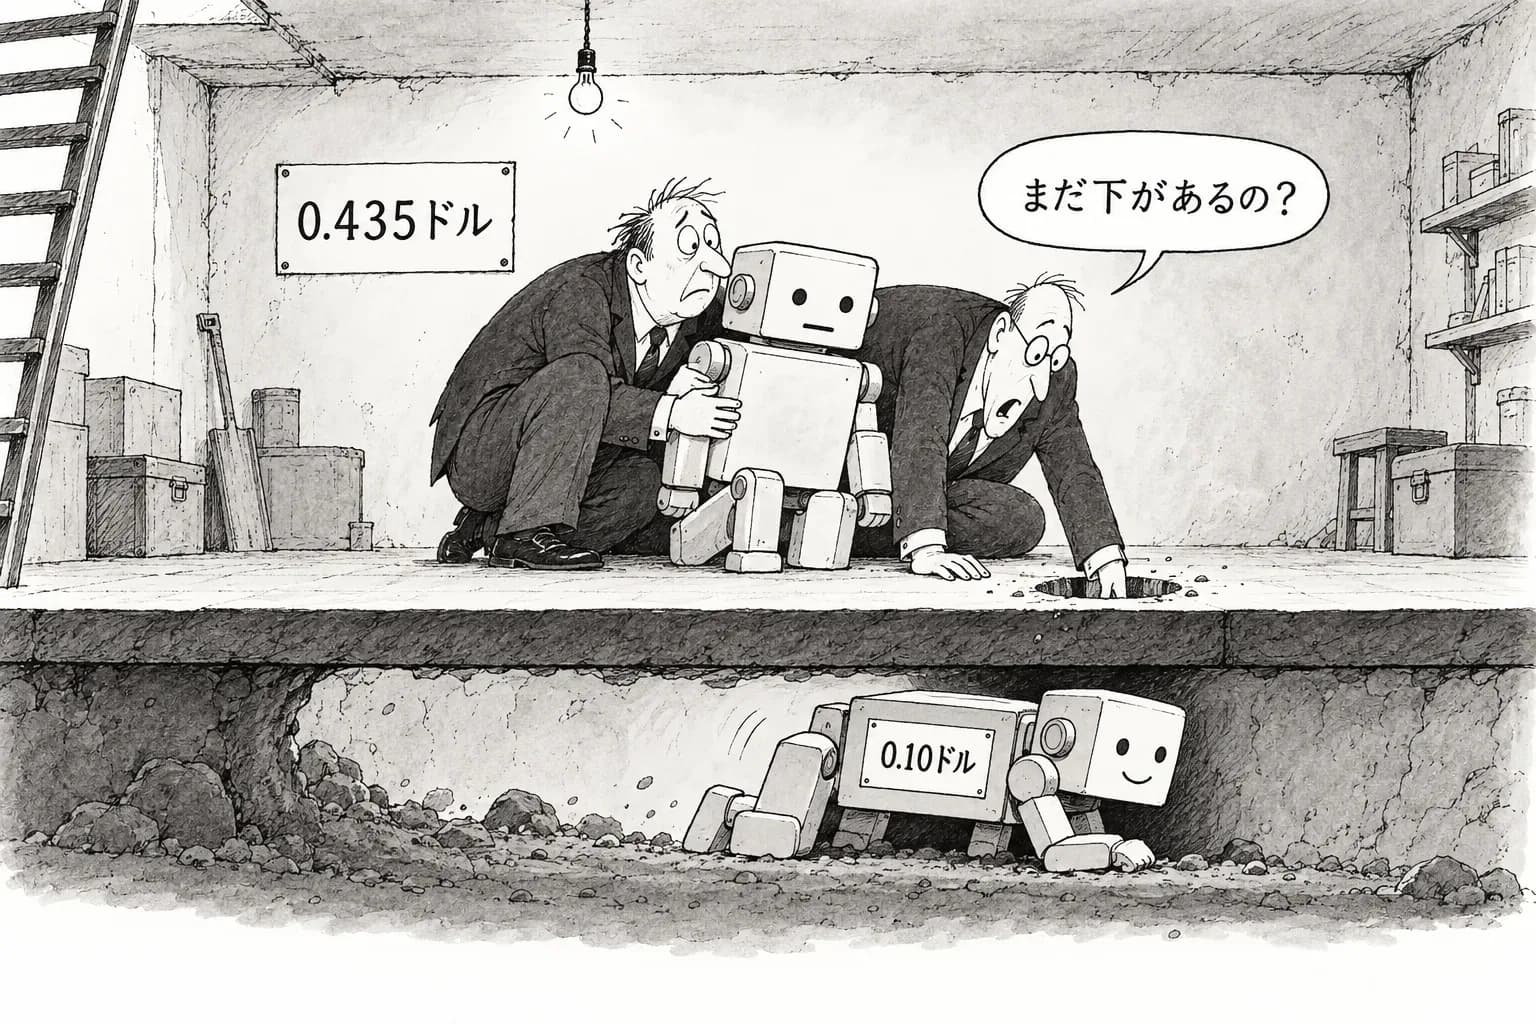
直近の基準線は Xiaomi の MiMo-V2.6 だった。入力0.435ドル/出力0.87ドル、軽量版の Flash が入力0.14ドル/出力0.28ドル。重みも訓練スタックも RL 環境も公開されており、Artificial Analysis の Intelligence Index では Pro が46でオープンウェイト114モデル中の首位、GPT-5.6 Sol の47に1点差まで迫っていた。つまり「フロンティアに1点負けるが原価は数分の一」という、エージェント企業にとって合理的な避難先が成立していた。
Luna の0.10ドルは、その避難先の入口価格を下回っている。Pro の0.435ドルに対して4分の1以下であるだけでなく、軽量版 Flash の0.14ドルすら下回る。これまで「重みを自分で持つ/安い中国製の重みを叩く」という選択を正当化していた根拠が、単価という最も分かりやすい軸では消えた。Grok 4.7 が入力2ドル/出力6ドルで3世代にわたり価格を据え置き、StepFun Step 5 Preview が入力1ドル/出力2.70ドルで殴り込んだ同じ四半期に、床がもう一段抜けたことになる。
もちろん、重みを持つことの価値は単価だけではない。データを外に出さない、モデルを固定できる、推論スタックごと自社の agent harness に組み込める — これらは値札で消えない。だが、エージェント製品の原価表で最初に比較されるのは単価である。その一列で負けたという事実は、来期の技術選定の会議に直接効く。
逃げ場を塞がれたのは誰か
この値付けが刺さる先ははっきりしている。報道ベースだが、法務エージェントの Harvey は粗利益率が6か月で+50%から−50%へ転落し、Harvey・Abridge・Ramp・Rogo がフロンティア API からオープンウェイトへの移行を進めているとされる。原因は単純で、エージェンティックワークフローは1リクエストで終わらないからだ。計画し、ツールを呼び、失敗し、やり直し、検証する。ユーザーの1アクションに対してトークンは二桁倍で膨らむ。座席単価で売っているのに原価がタスク量に比例するという、SaaS の損益計算書が想定していない構造である。
その病に対する処方箋が「安い重みへ降りる」だった。Luna はその処方箋の前提を、外側から書き換えにきている。エージェント企業にとってこれは救済であると同時に、自社の技術的優位の目減りでもある。自前の推論基盤に払った人件費と GPU 投資が、値下げ一発で回収期間を伸ばされる。安さが恒久的に外から降ってくるなら、原価を自社で握ることの戦略的価値そのものが下がるからだ。
ただし、請求額を決めるのは単価ではない
ここで留保を置かないと記事として不誠実になる。単価は原価ではない。
Artificial Analysis が同一の指標を完走するのに要した実費は、Intelligence Index が同点の46だった MiMo-V2.6-Pro で206.66ドル、Grok 4.7 で4,967.35ドルだった。約24倍の開きである。Grok 4.7 は完走に出力トークン2億4,000万を消費している。同じ賢さ、同じ仕事、24倍の請求。つまり、いくら安いかを決めているのは値札ではなく、そのモデルが答えを出すまでに何トークン吐くかのほうだ。
したがって Luna の0.10ドルが本当に床なのかは、独立側の実測が出るまで確定しない。現時点で Sol と Luna の Intelligence Index も、タスク単価も、第三者による測定値は存在しない。能力の自己申告がないということは、裏を返せば検証すべき主張も提示されていないということであり、査定できるのは価格表だけである。安い単価で冗長に考えるモデルは、高い単価で簡潔に答えるモデルより高くつく — この四半期に何度も確認された事実は、Luna にもそのまま適用される。
四半期単位で崩れる原価の上に、粗利の議論は立たない
ここからが本題である。「AI が SaaS の粗利を壊す」という命題は、この一年で投資家と経営者の共通言語になった。座席課金のソフトウェア事業に、従量で膨らむ推論原価という新しい売上原価が乗り、80%台の粗利が崩れる、という話だ。
この命題の前提には、推論原価が安定した変数であるという仮定が隠れている。原価が読めるからこそ、粗利の毀損幅を計算できる。だが実際に起きているのはそうではない。この四半期だけで、Xiaomi は262万ドル・6日未満の訓練でフロンティア級のオープンウェイトを出して0.435ドルの値札を付け、xAI は5週間ごとに能力を上げながら価格を据え置き、そして OpenAI が能力の主張を一切添えずに0.10ドルを出した。原価は下方向に、四半期どころか数週間単位で動いている。
これは粗利の議論にとって二重に厄介である。第一に、今期の原価で引いた損益分岐点は来期には意味を失う。Harvey の−50%は、来期には値下げだけで改善しうるし、逆にエージェントの自律度を上げてトークン消費を増やせば再び沈む。第二に、より深刻なのはこちらだが、原価が外部から恒常的に切り下げられるということは、原価の削減が誰の競争優位にもならないということだ。全員が同時に安くなるコストは、差別化ではなく単なる前提条件になる。デジタルコワーカーとして売っているエージェント製品の値付けは、粗利の防衛ではなく、顧客が代替手段でいくら払うかという別の軸に押し戻される。
OpenAI が今回やったのは、能力競争の一手ではなく、産業の原価構造に対する一手である。そして「暫定価格ではない」という一文によって、それは一回限りのイベントではなく新しい水準として提示された。エージェント企業が原価から逃げるために開けた扉を、扉の外側にいたはずの当事者が先に塞いだ形になる。
次に確定する場所
追うべき点は3つある。第一に、Artificial Analysis による Sol と Luna の Intelligence Index とタスク単価の実測。単価ではなくタスク単価で MiMo-V2.6-Pro の水準を下回れるかが、今回の値付けが本物かどうかを決める。第二に、オープンウェイト側の反応。Xiaomi も StepFun も訓練費用を数百万ドル規模まで圧縮しており、値札を下げる余地は構造的に残っている。第三に、オープンウェイトへ移行中と報じられたエージェント企業が、その移行を止めるか続けるか。止めるなら、今回の0.10ドルは値下げではなく囲い込みだったことになる。
いずれも、次の発表までの数週間で決着する。その速さ自体が、この記事の結論でもある。