Anthropic が9月22日、Claude Opus 5.5 を公開した。性能の数字より先に読むべきなのは、リリース本文が自分について書いた一行のほうである。
Claude Opus 5.5 is the first model we have released since we called for pacing the frontier.
訳: Claude Opus 5.5 は、我々がフロンティアのペース配分を呼びかけて以降で最初のリリースである。
Dario Amodei の『We Must Pace the Frontier』が9月12日。そこから10日である。この一文は弁解ではなく、自己申告された日付の刻印だ。同社は、自分が呼びかけた減速の直後に何を出したかを、他人に数えさせる前に自分で数えた。
10日という数字を、最初に数えたのは Anthropic 自身だった
もっとも、外から数えた側の表現はもっと乾いている。
10 days after its CEO called for slowing down, Anthropic is back with another AI model
訳: CEO が減速を呼びかけて10日後、Anthropic は別の AI モデルを引っ提げて戻ってきた
Gizmodo の見出しは、リリース本文の自己言及をそのまま皮肉の形に折り返したものだ。ただし「言ったそばから出した」という指摘は、この件のいちばん浅い層でしかない。重要なのは、出したモデルが何を安くしたかである。
値下げは一律ではない — キャッシュ読み出しだけに6割引の係数が当たる
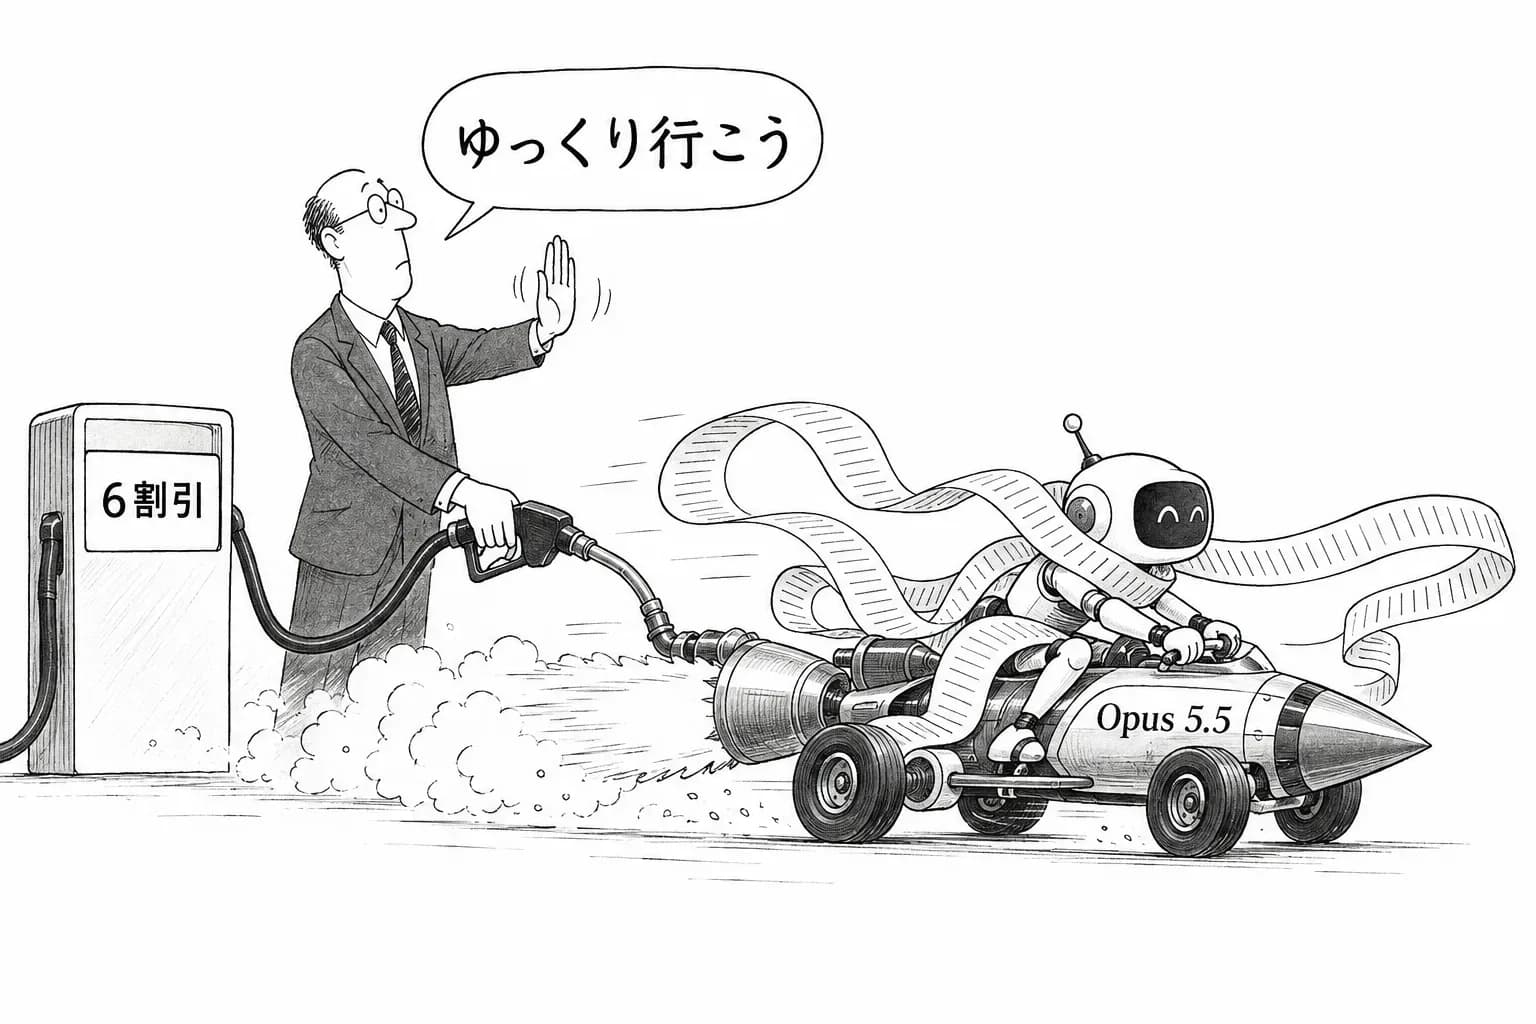
Opus 5.5 の価格構造で新しいのは、キャッシュ読み出しに専用の係数が入り、従来から6割引かれた点である。入力でも出力でもなく、キャッシュ読み出しだ。この一行が誰に効くかは、値引き率よりも対象の選び方に出ている。
単発の対話では、キャッシュ読み出しはほとんど発生しない。効くのは、同じ前置き — システムプロンプト、ハーネスの実行規約、リポジトリの文脈、直前までの数十ターン — を毎ターン読み直しながら回り続けるループのほうである。コーディングエージェントが1本のタスクを最後まで走らせるとき、課金の大半は新しく考えた分ではなく、すでに考えた分をもう一度読む分で積み上がる。Opus 5.5 の係数は、その積み上がりだけを狙って削りにいっている。
つまりこれは汎用の値下げではなく、エージェンティックワークフローという特定の使われ方への補助金である。長文脈を何十周も舐め直す使い方をする顧客ほど得をし、一問一答で終える顧客には何も起きない。価格表は、誰に使ってほしいかを性能表よりはっきり書く。
METR の「約1.5倍」を、自ら記録に残した
同じリリースには、もう一つ自分で刻んだ数字がある。METR による外部評価で、このモデルが AI 研究をおよそ1.5倍加速させる、というものだ。Anthropic はこれを控えめに埋めるのではなく、安全性の節の根拠として置いた。
More capable models that could fully automate the work of AI research itself will require even higher safety standards.
訳: AI研究それ自体の作業を完全に自動化できるような、より大きな能力を持つモデルには、さらに高い安全基準が要る。
ここで言われているのは「まだその段階ではない」であり、同時に「その段階への距離を我々は測っている」でもある。1.5倍は、完全自動化ではないと主張するための数字であると同時に、完全自動化への進捗をベンダー自身が公開値として残した最初期の例になる。
この記録の置かれた週が何だったかを思い出しておく価値はある。OpenAI が再帰的自己改善(RSI)の進捗を測る標準的な評価手法を提案し、Ezra Klein が NYT で RSI の規制的禁止を主張し、Alibaba が Qwen3.8-Max の「人間の関与ゼロで33ラウンドの自己反復」を自社の達成として語った、その同じ週である。RSI をめぐる議論が「測れるのか」で止まっているあいだに、Anthropic は自社モデルの加速倍率を一次情報として記録に入れた。論争の材料を、論争の当事者が供給した形になる。
補助金の行き先は、原価で溶けかけているエージェント製品である
キャッシュ読み出しの6割引が誰に届くかを考えると、この10日間の文脈が一本につながる。
エージェント製品の粗利は、モデルの賢さではなくトークンの消費量で決まる段階に入っている。Harvey の粗利益率が6か月で +50% から −50% へ転落し、Harvey・Abridge・Ramp・Rogo がフロンティア API からオープンウェイトへ移りつつあると報じられているのは、その最も具体的な症状だ。既に報じたとおり、Artificial Analysis が同じ指標を測るのに要した費用は Xiaomi MiMo-V2.6-Pro が206.66ドル、Grok 4.7 が4,967.35ドルで、ほぼ同点のモデル間に約24倍の開きがある。Grok 4.7 は指標を完走するのに出力トークン2億4,000万を使った。賢さが同じなら、残る差は原価だけである。
中国勢がこの半月やってきたのは、まさにその締め上げだった。StepFun はタスク単価0.71ドルを掲げ(Artificial Analysis の実測は0.72ドル)、Xiaomi は訓練費用ごと開示して入力0.435ドル/出力0.87ドルを出し、Z.ai・Qwen・DeepSeek は重みではなくハーネスを開けて流通そのものを取りにいった。規模ではなくタスク単価を最適化する、という一貫した方向である。
Opus 5.5 のキャッシュ係数は、この戦線への直接の応答と読むのが自然だ。フロンティア側は重みを開けないし、タスク単価をオープンウェイトの水準まで落とすこともできない。できるのは、エージェントの原価で最も太い科目 — 同じ文脈の読み直し — をピンポイントで削ることである。顧客を安いモデルへ逃がさないための、科目指定の補助金だ。
減速の単位が、モデルからループへ移った
ここに、この件のほんとうの居心地の悪さがある。
ペース配分の議論は、暗黙に「モデルのリリース間隔」を単位にしてきた。何か月おきに次の世代を出すか、どの能力閾値で止まるか。だが Opus 5.5 が安くしたのはモデルの単価ではなく、1本のエージェントが自律的に回り続ける時間の単価である。同じモデルを、同じ価格表のまま、これまでの2倍長く走らせても請求額が増えない設計に近づいたとき、フロンティアで実際に動いている計算量は、リリース間隔とは無関係に増える。
減速を説いた側が、減速の計測単位を自分で無効化しにいった — というほど意図的な話ではないだろう。だが結果として、Anthropic は同じ月に三つのものを記録に残した。フロンティアのペース配分の呼びかけ、その10日後の最初のモデル、そしてそのモデルが AI 研究を約1.5倍加速させるという外部評価である。三つ目を自ら公開したことは、少なくとも誠実だ。ただしそれは、一つ目が何を意味するのかを、これまでより難しくしている。