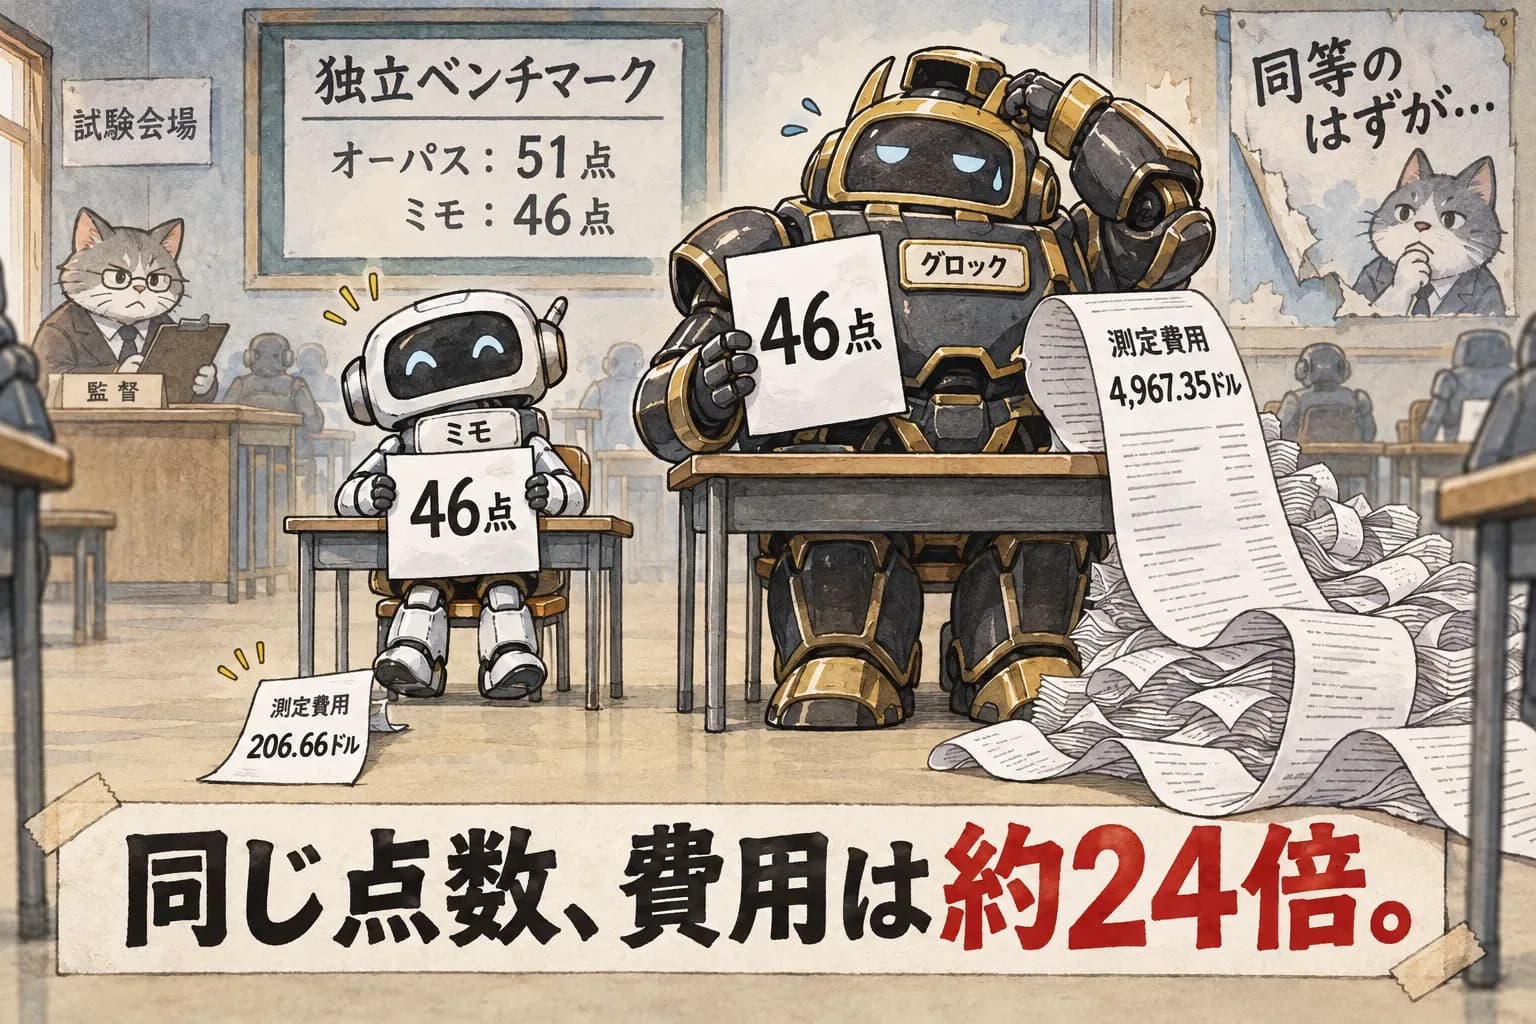
第三者検証待ちだった数字が、ようやく届いた。Artificial Analysis の独立測定で、Xiaomi の MiMo-V2.6-Pro は46点を記録した。Claude Opus 5 には5点届いていない。9月22日の公開時に Xiaomi が掲げた「大半のエージェント系ベンチマークで Claude Opus 5 および GPT-5.6 Sol と同等」という主張は、少なくともこの指標の上では裏付けられなかった。
ここで記事を終えるのが、ベンチマーク報道の通例である。主張があり、検証があり、5点足りなかった。だが同じ測定結果の別の列に、はるかに大きな数字が載っている。同じ46点を出したモデルの、測定にかかった費用だ。MiMo-V2.6-Pro が206.66ドル。Grok 4.7 が4,967.35ドル。約24倍である。
5点の差と、4,760.69ドルの差
並べ方を変えるとよくわかる。スコアの側で議論になっているのは、46対51という5点の開きだ。同じ表のコストの側で起きているのは、206.66ドル対4,967.35ドル、差額にして4,760.69ドルの開きである。1点あたりに換算すれば、MiMo-V2.6-Pro が約4.5ドル、Grok 4.7 が約108ドル。知能指数はほぼ並び、そこへ到達するための単価は24倍離れている。
どちらが「重要な差」かは、読者がその数字で何を決めるかによる。モデル選定会議で5点を根拠に意思決定する人はあまりいない。5,000ドル近い差を根拠に意思決定する人は、いくらでもいる。
単価は据え置かれ、消費量が跳ねた
誤解を避けておくと、Grok 4.7 のトークン単価は高くない。xAI は4.5(7月28日)、4.6(8月14日)、4.7(9月21日)と約5週間サイクルで更新しながら、入力2ドル・キャッシュ0.50ドル・出力6ドルという価格を据え置いてきた。これはコーディングエージェント領域での価格性能の締め上げとして、意図的に設計された値付けである。
それでも請求額は4,967.35ドルになる。単価が据え置かれていても、消費量が据え置かれていないからだ。Grok 4.7 は数時間規模のタスクに対する強化学習、自己検証、文脈管理を強化したモデルとして出荷された。自己検証とは、同じ問題を何度も見直すことである。文脈管理とは、50万トークンの窓を実際に使うことである。この設計思想は、そのままトークン消費量の設計思想でもある。公開直後に VentureBeat が「トークン消費量が実運用のROIを脅かす」と指摘し、The New Stack が「数時間動くよう作られているが大半は失敗する」と書いたのは、独立測定の請求書が出る前の観測だった。請求書はその観測を追認した。
つまり、モデルの公表価格表はもはや請求額の予測に使えない。エージェントハーネスの中で何回ループが回り、何回自己検証が走るかを掛け合わせて初めて金額が出る。ベンダーが公開しているのは掛け算の片方の数字だけである。
スコア表は単価表とセットでしか読めない
この構図は、今月の中国勢の動きを一本の線でつなぐ。StepFun は Step 5 Preview について、総600B・アクティブ27B というスパース構成で Artificial Analysis Intelligence Index 44 に到達し、タスク当たり0.71ドル(Kimi K3 Max は2.00ドル)と主張した。Xiaomi の MiMo-V2.6-Pro も、総1.02兆・アクティブ42B のスパースMoE でありながら、オープンウェイトで技術報告とRL環境と訓練コードまで同時に開けている。規模ではなくタスク単価を最適化している、という仮説を、今回の206.66ドルは外部の測定として裏づけた形だ。
そして、オープンウェイトであることの意味も変わる。ローカルLLM の議論はこれまで主にプライバシーと可用性の話だった。1点あたり108ドル対4.5ドルという数字が公開された後では、単純に会計の話になる。重みが手元にあるモデルは、24倍の掛け算の外側に立てる。
それでも同等ではない、という事実は残る
コストの話が大きいからといって、5点が消えるわけではない。Xiaomi の同等性の主張は、独立測定では通らなかった。自己申告値として公表されていた DeepSWE v1.1 71.9、Toolathlon-Verified 76.9、CyberGym 94.0 という数字と、外部の総合指標での46点は、別々に扱う必要がある。同様に、Grok 4.7 の CursorBench 4.0 46.3%、DeepSWE v1.1 71.0%、Terminal-Bench 4.0 38.0% も、StepFun の44も、依然としてベンダー申告である。今回コストの列まで含めて外から測られたのは、この2モデルの組み合わせだけだ。
本紙が次に追うのは、この「コストの列」が定着するかどうかである。スコアだけを載せた比較表は、今日から片肺の資料になった。同じ点数を取るのにいくらかかったかを書かない表は、読者に24倍を隠していることになる。