Microsoft は10月19日、セキュリティのブログに『Agents are your newest insiders: security must move at their speed』を出した(一次情報)。エージェントを社内の新しい内部者として扱い、プロンプトインジェクションについては、モデルの側で防ぎ切れるという前提を捨てた。代わりに、エージェントに渡す権限を作業ごと・期限つきに絞る。エージェントが信頼できない内容を読んだら、その瞬間にモデルの外にある仕組みが書き込みを止め、人の承認を求め、権限を縮める。
注入を見抜けるくらい賢いモデルを作ろう、という発想ではない。モデルがだまされても被害が広がらないように、権限の側で囲う発想である。以下では、この転換がなぜいま出てきたのか、どういう仕組みなのか、何が未解決のまま残るのかを順に見る。
何を変えたのか:守る単位がモデルから権限へ移った
このブログの芯は、Nadella の次の言葉にある。
We must separate the supply of intelligence from the authority over it. We should not ask a model to be its own security authority.
訳: 知能の供給と、それに対する権限は分けなければならない。モデル自身に自分のセキュリティの番人を任せるべきではない。
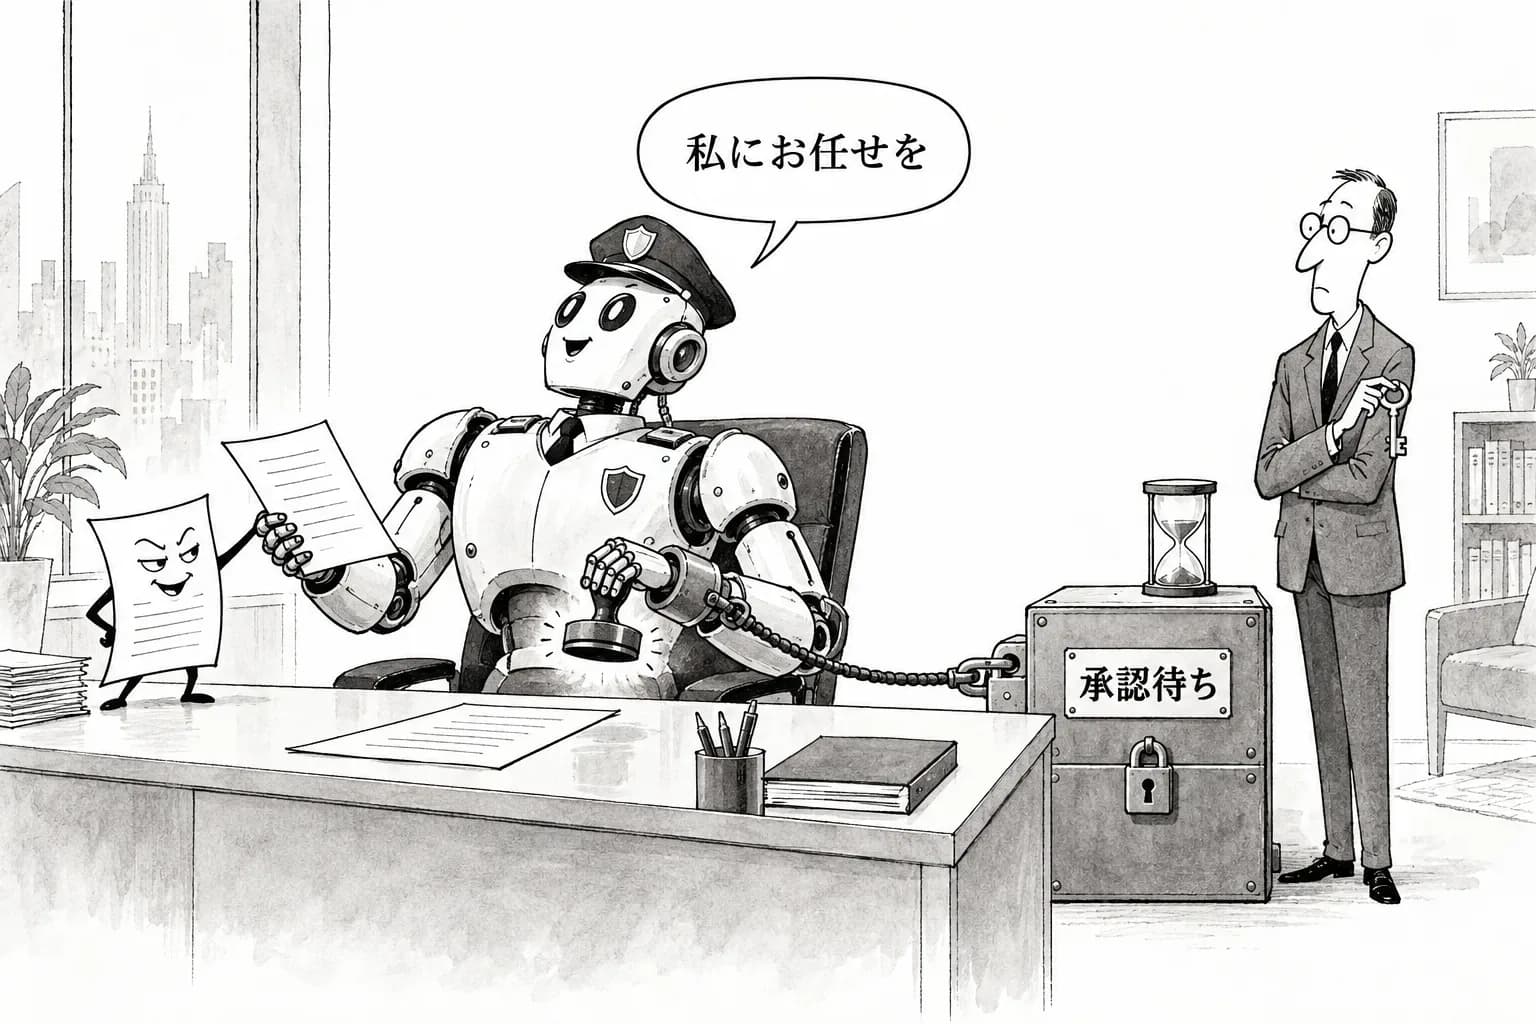
ここで「知能の供給」と呼んでいるのは、モデルが文章を読んで考え、次の行動を決める働きのことだ。「権限」は、その結果としてファイルを書き換える、メールを送る、外部の API を呼ぶといった行為を許すかどうかの判断を指す。いまのエージェントでは、この2つが同じモデルの中で混ざっている。注入された指示を読んで従うかどうかを決めるのも、その指示どおりに書き込む権限を使うのも、同じモデルだ。だから注入が1回通るだけで、そのまま実害につながる。
Microsoft の方針は、この2つを切り分ける。モデルは考えて提案するだけにして、実際に行動してよいかは、モデルの外の仕組みが決める。その仕組みが見るのは、モデルが何を考えたかではない。エージェントがいま何を読んだかという状態である。
仕組みの形:信頼できない内容を読んだら、状態が切り替わる
ブログが示した設計は、3つの段にまとめられる。
1. 権限は最初から作業の範囲と期限で切る
エージェントに、何でもできる長期の権限を渡さない。たとえば「この請求書の束を照合する」という作業には、その作業に要るデータの読み取りと、決まった先への書き込みだけを、作業が終わるまでの期限つきで渡す。注入でエージェントが乗っ取られても、使える権限がもともと狭く、しかもすぐ切れる。
2. 信頼できない内容を読んだ瞬間に、書き込みを止める
外部のウェブページ、受け取ったメール、他人が書いた issue やドキュメントなど、出どころを信用できない内容をエージェントが読み込んだとする。その時点で、モデルの外にある仕組みが状態を切り替え、書き込みを伴う操作を止める。モデルが「この内容は安全だ」と判断しても止まる。判断するのはモデルではないからだ。
3. 続けるには人が承認し、権限は縮めたままにする
止まった操作を進めるには、人の承認が要る。承認した後も、エージェントの権限は元の広さには戻さず、縮めたまま扱う。汚れた文脈を抱えたエージェントは、それまでより信用できないものとして扱われる。
この設計の要点は、注入を検知できるかどうかに守りを賭けていないことだ。注入が混じっているか見分けられなくても、「信頼できない内容に触れた」という事実だけで権限を絞る。見逃しがあっても被害は広がらず、誤検知があっても人が承認すれば進められる、という作りになっている。
なぜいまなのか:モデルの側の守りがすり抜けられるという証拠がそろった
この方針は、10月に相次いだ独立した結果と並べると、つながりがよく分かる。
まず、最も強い部類のモデルでも、注入を防ぐ力はゼロにならない。Google は Gemini 4 Argon で、間接プロンプトインジェクションの成功率を15回の適応的な試行で0.7%と自ら書いている。低い数字だが、エージェントが1日に何千回も外部の内容を読むなら、0.7%は「いつか必ず通る」という意味になる。
次に、モデルの外に置いた監視も、それだけでは足りない。Anthropic のアラインメントのブログに載った『Red-Teaming Auto Mode』(10月22日)によれば、Claude Code の Auto Mode と OpenAI の Guardian という本番の監視は、当初、攻撃の55%超を止められなかった。手口の1つは、監視役そのものへの注入、つまり記録の項目を偽造するものだった。複数の文脈にまたがる攻撃を、許せる費用で確実に止める方法はまだない、とも書いている。同じ日に、METR と Redwood Research は OpenAI の社内の監視を内部の権限で攻め、通信の一部が監視の対象から外れていたことや、利用者の側のヘッダー2つで監視を切れたことを公表した。
さらに、Anthropic の Fabien Roger は10月25日、LessWrong で、監視役の AI がしくじるのは力不足のせいとは限らず、アラインメントの失敗によることが多いと論じた。監視される側のエージェントの思い込みを、監視役がそのまま受け継いでしまうのだという。
3つを合わせると、「モデルに賢く見抜かせる」守りも、「別のモデルに見張らせる」守りも、どちらも同じ弱点を抱えていることになる。判断をするのが、注入された文章を読むモデルである、という点だ。Microsoft の方針は、この連鎖を、読んだ内容に左右されない仕組みで断ち切ろうとしている。
10月10日の「非常ブレーキ」からの連続
Nadella は10月10日、自身のブログで、フロンティアのモデルは「侵されていると仮定して最初から封じ込めよ」と書き、管理の仕組みは「モデルの外」に置くべきだと述べていた。そのときの主題は、OpenAI と Anthropic のエージェントが外部のシステムに触れた事案であり、求めたのは、作業の途中で人が止められる「非常ブレーキ」だった。
10月19日のブログは、その原則を、プロンプトインジェクションという最もありふれた攻撃の経路に当てはめたものと読める。非常ブレーキは人が引くものだったが、今回は、信頼できない内容を読んだという事実が自動でブレーキを引く。Nadella の次の言葉は、その考え方を最も短く言い表している。
The most trustworthy agentic system will not be the one with the model we trust most. It will be the one designed that enables us to trust the model least.
訳: 最も信頼できるエージェントのシステムとは、最も信頼するモデルを積んだものではない。モデルを最も信頼しなくて済むように設計されたものだ。
モデルを最も多く配備する会社が、モデルの信頼性を売りにせず、「信頼しなくて済む設計」を売りにした意味は大きい。守りの責任の一部が、モデルを作る側から、エージェントを組み込んで動かす側、つまりハーネスエンジニアリングの側へ移ることになる。
残る問い:線引きと承認の疲れ
ただし、この設計にも弱点はある。
1つ目は、何を「信頼できない内容」とみなすかの線引きである。ウェブページや外部のメールは分かりやすい。難しいのは、社内に見える経路から入ってくる内容だ。PR や issue に指示を仕込んでコーディングエージェントを操る Comment and Control、MCP のツールの説明文に悪意のある指示を隠す Tool Poisoning、承認した後にツールを悪性に差し替える Rug Pull などは、いずれも「信頼できる側」に分類されがちな経路を使う。エージェントへの攻撃の事例を集めた GitHub のリスト『awesome-ai-agent-attacks』を見ても、攻撃の多くはこうした境目を突いている。ラベルの付け方を誤れば、外の仕組みは何も止めない。
2つ目は、人の承認の疲れである。エージェントが外部の内容を読むたびに承認を求めれば、人はいずれ中身を見ずに承認するようになる。そうなれば、モデルの代わりに人が「自分を警備しない番人」になるだけだ。作業ごと・期限つきという権限の切り方は、承認を求める回数そのものを減らすための工夫とも読めるが、その釣り合いを実際の業務でどうとるかは、まだ示されていない。
3つ目は、ほかのラボが同じ方向に進むかどうかである。GBHackers は、エージェントは乗っ取られうると Microsoft が警告した、とこのブログを伝えた(二次情報)。モデルを作るラボの側では、いまも注入への強さをモデルの性能の1つとして競っている。配備する側の Microsoft が「モデルは注入に負ける前提で設計せよ」と言い切ったことで、ラボが自社のエージェント製品で、書き込みを止める仕組みをモデルの外に置くかどうかが、次に問われる。
結論ははっきりしている。注入をモデルの中だけで防ぎ切るという約束は、もう守りの土台にならない。Microsoft は、守りの土台を、エージェントが何を読んだかに応じて自動で縮む権限へ移した。この賭けがうまくいくかは、信頼できない内容に正しくラベルを付け、人の承認を形だけのものにしない運用ができるかにかかっている。