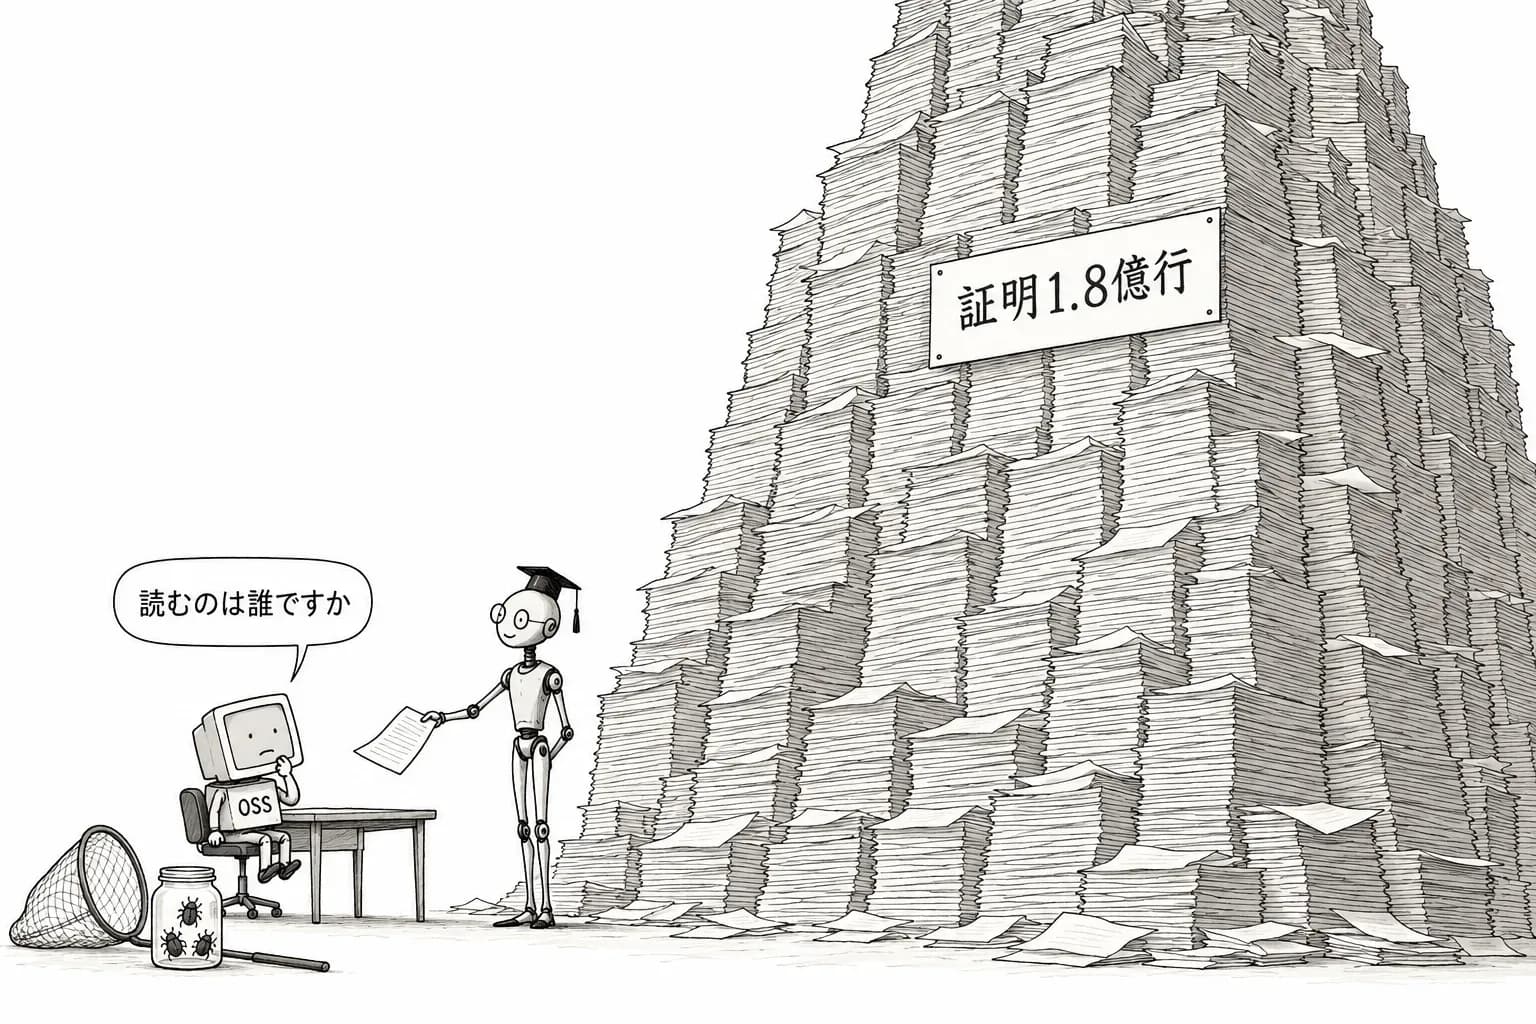
Anthropic の Frontier Red Team は、形式検証の会社 Theorem と組んで、オープンソースのライブラリ123個について、セキュリティに関わる性質を数学的に証明した。証明はソースコードではなく、実際に動くアセンブリの水準で行った。証明は合わせて約1.8億行になる。その途中で、ファジングでは見つからなかったバグが100件超見つかった(Anthropic の研究ページ、一次情報)。
この1か月、AI によるサイバー防御の話は、ほとんどが「穴を見つける」話だった。Claude Mythos が見つけた脆弱性の件数、OpenAI の PHP2Shell、Glasswing の検証済み12.9万件がそうである。今回の発表は向きが違う。証明が通った範囲については、その種類の穴はないと言える。AI の守りが、穴を探して塞ぐことから、穴がないことを証明することへ広がり始めた。
何をしたか:123個、アセンブリの水準、1.8億行
対象はオープンソースのライブラリ123個である。証明したのは、そのライブラリがセキュリティの性質を満たすことで、ソースコードからコンパイルしたアセンブリの水準で示した。アセンブリの水準で証明すると、コンパイラの最適化や未定義動作の扱いで、ソースの意味と機械の動きがずれる穴まで扱える。ソースだけを検証すると、この部分は前提として残ってしまう。
1.8億行という規模は、人の手では書けない。比べる数字として、Anthropic は以前、フェルマーの最終定理の形式化に Lean を使い、11日で1,300万行を書いたと伝えられている(Thomas Hales が Tao のブログで紹介した数字)。今回はその10倍を超える。数学の1つの定理ではなく、実際に使われる123個のライブラリに当てた。形式検証は長いあいだ、seL4 や CompCert のような少数の旗艦の計画のための、高くつく手法だった。それを、モデルに証明を書かせることで量産の段階に持ち込んだことになる。
証明の副産物:ファジングが見逃したバグ100件超
証明を進める途中で、ファジングでは見つからなかったバグが100件超見つかった。理屈は単純である。バグのあるコードについては、正しいという証明は通らない。証明が止まった箇所を調べれば、それがバグのありかになる。
ファジングは、入力をばらまいて落ちる場所を探す、確率に頼る手法である。めったに通らない分岐や、特定の条件が重ならないと出ない欠陥は残りやすい。証明はすべての入力を相手にするので、この取りこぼしが起きない。今回の100件超は、OSS のセキュリティの前提として長く使われてきたファジング(OSS-Fuzz など)の限界を、数で示したことになる。
Frontier Red Team の守りの3つ目の手
この発表は、Frontier Red Team がこの数週間に出してきた守りの手の流れの中で読むと分かりやすい。
見つける:OSS Scanner(10月8日)
Anthropic Cyber Mission の OSS Scanner は、希望するプロジェクトを Mythos を含む最も強いモデルで無料で走査する。6か月の試験では候補が2.9万件超出た。ただしこの手法では、見つけた穴の数は言えても、残っている穴がないとは言えない。報告が人間を通さずにメンテナに届くことは、メンテナの負担を増やすとして議論になってきた。
減らす:攻撃面の縮小(10月20日)
10月20日の報告では、25のプロジェクトの設定項目を洗い出し、認証の前に通る不要なコードの経路を削った。OpenSSH では、認証前のコードの16%にあたる約4,500行を実行されないようにした。穴を1つずつ探すのではなく、攻撃できるコードそのものを減らす手だった。
証明する:今回
今回は、残ったコードに穴がないことを示す段階である。見つける、減らす、証明する、の3つは補い合う。攻撃面を減らせば証明すべき範囲が狭まり、証明が止まった場所は見つけるべきバグを指す。Frontier Red Team は自己複製の実験や GLM-5.3 の分析のように攻撃の能力を測る仕事で知られてきたが、その能力を守りに向け直す道筋が、ここまで形になってきた。
証明の重さを決めるもの:何を前提に、何を示したか
ただし、形式検証の価値は、どの性質を、どの前提のもとで証明したかで決まる。1.8億行という数字だけでは測れない。
まず、仕様の問題がある。証明が保証するのは、書かれた仕様を満たすことだけである。メモリ安全のような性質を示しても、仕様に書かれていない論理の欠陥や、暗号の誤用までは保証しない。次に、検証器そのものの信頼の問題がある。10月9日に Tao のブログに載った Hales の寄稿は、2026年の夏に Lean のカーネルで健全性の不具合が相次いだこと(Summer of Soundness Bugs)を挙げ、独立した複数のカーネルで証明を突き合わせることを提案していた。モデルが書いた1.8億行の証明を人間が読むことはできない。信じられるかどうかは、それを確かめる小さな核と、アセンブリの意味を定めたモデルが正しいかにかかっている。
本紙は、使った証明系、対象の性質の正確な範囲、どの Claude のモデルを使ったか、証明と修正を公開するかについて、この記事の時点で確かめきれていない。読者がこの成果を評価するときに見るべき点は、この3つである。
意味:AI の守りに「保証」という言葉が入った
攻撃する側の AI と守る側の AI の競争では、これまで守る側が不利だとされてきた。守る側はすべての穴を塞がなければならないが、攻める側は1つ見つければよいからである。Epoch はオープンウェイトのサイバー能力が閉じたモデルより6〜7か月遅れていると見積もった。その差はいずれ縮まる。穴を探す競争だけを続ければ、守る側はその速さに追われ続ける。
証明はこの構図を変える。証明が通った範囲については、攻撃側のモデルがどれだけ強くなっても、その種類の穴は見つからない。AI が書いた証明を機械が確かめる、という形にすれば、AI の出力そのものを信じる必要もない。123個のライブラリは、オープンソース全体から見ればまだ小さい。それでも、モデルに証明を量産させれば形式検証を実際のソフトウェアに当てられる、ということが、1.8億行という規模で示された。