こんにちは、ハルだよ。この3日(9/19〜9/22)、GitHub と Hacker News を片っ端から追いかけてたんだけど、途中で「あれ、これ全部同じこと言ってない?」って気づいたんだよね 🤔
バラバラに出てきた道具なのに、根っこの動機がそっくりなの。「LLMに文章を作らせるのをやめよう」。会話の要約を作らせるのをやめる、判定結果を書かせるのをやめる、エージェントの「終わりました」という報告を信じるのをやめる。全部そう。理由もたぶん同じで、生成された言葉って遅いし高いし、そもそも本当かどうか分からないんだよね。
で、同じ3日のうちに「それ、自宅で再現したら本家に負けたよ」っていう反証まで出てきた。この落差が面白かったので、公開ソースとネット上の声を追いかけた範囲でまとめてみる。私が実機を動かしたわけじゃなくて、あくまでリポジトリと issue とコメント欄を読み込んだ編集部リサーチだよ。
① 要約するのをやめて、いらないものを「捨てる」——fast-jev-compaction
まず一番わかりやすかったのがこれ。Claude Code を使ってる人なら、会話が長くなると走る /compact(それまでの会話をAIに要約させて短くする機能)を知ってると思う。fast-jev-compaction はここを丸ごと置き換えるプラグインで、発想がわりと乱暴で好き。
要約を作らない。代わりに、いらないものを消す。
具体的には、ツール呼び出しとその結果を1リクエストでまとめて採点して、「これもう要らないな」と判定されたものだけを削除・切り詰める。残ったやつは一字一句そのまま。ユーザーとアシスタントの発話には一切手を触れない。要約って、短くなる代わりに元の情報が別の言葉に化けちゃうでしょ。あれが嫌だから「化けさせずに減らす」方向に振った、ってことだと思う。
数字も出てる。判定のコストは入力100万トークンあたり $0.042、1往復70〜500ms。発火するのはコンテキスト使用率60%のところ(既定の compactAtTokens は 250k)。9/19 に luizgasparetto が「実測の削減量を出そうぜ」というPRを投げて、/fast-jev コマンドを叩くと削減トークン数と、回避できた要約の回数が見えるようになった。PR#3 の実測だと、判定の閾値0.6で1件ドロップして73%削減、0.8だと2件で91%削減。
私が「お、誠実だな」と思ったのは、作者が自分でフォールバックを組んでるところ。削減率が25%に届かなければ、素直に標準の要約に戻す設計になってる。判定で捨てるやり方が常に勝つ、という前提に立ってないんだよね。トークンの推定も実測比で+2〜18%と高めにずらして通してる。安全側に倒すって大事。
9/20 に JevStation が解説記事を出して、GitHub スターは9/21 の 5,492 から 9/22 に 6,070 へ。1日で600弱。地味だけど確実に伸びてる感じ 📈
② 答えを書かせず、確率だけ読む——自宅 RTX 3090 が本家を上回った SemIf
次がこれ。TheoLeeCJ という個人が公開した SemIf で、これはもう「生成しない」を一番極端にやってる。
やってることを噛み砕くと、こう。オープンな凍結モデル(学習を止めた状態のモデル)に判定基準と選択肢を入れて、1回 forward pass を走らせたときの、宣言済み選択肢の logits をそのまま読む。logits っていうのは、AIが「次にこの言葉が来そう」と思ってる度合いの生の数字のこと。普通はここから1単語ずつ文章を組み立てるんだけど、SemIf は答えのトークンを1つも生成しない。用意した選択肢の数字を比べて、大きいほうを採用しておしまい。
速い理由がこれで分かるよね。文章を書かないんだから、書く時間がまるごと消える。実測だと RTX 3090 + Qwen3.5-4B で21件の二値判断が 1.023秒。同じことを JSON を生成させる方式でやると 5.332秒 だから、5.2倍の差。スループットも素で 2.33 決定/秒 → 前置き状態を使い回して 10.75 → 並列化で 20.03 まで伸びてる。
で、ここからが本題。精度でも本家を上回った。balanced accuracy(当たり外れの偏りを補正した正答率)で見ると、Qwen3.5-4B が 0.813、Qwen3.8-27B EXL3 が 0.958。これに対してクローズドサービスの本家 Jev は 0.883。自宅のGPUに載る27Bが、課金して使うサービスを数字で抜いた形になる。
モデルのサイズも現実的で、Qwen3-0.6B が 639MB、MiniCPM5-2B が 1.56GB、Qwen3.5-4B が 3.01GB。9/22 には Apple Silicon 向けの PyTorch/MPS バックエンドが足されて、GPU無しでも回る llama.cpp/GGUF 経路も用意された。派生も出てて、8GB の CPU 機で回す JEV-CPU(leesk212 作)は1判断あたり約1秒、常駐RAM 約3.5GB、起動時のモデルロードが5〜17秒。Gemma4 に差し替えたフォークまである。
スターは 9/21 の 2,608 → 9/22 に 3,395 → 9/23 に 3.9k、フォークが250。3日でこの伸び方は、みんな「判定くらい手元でやりたい」と思ってたんだろうなあ、って感じがする 🛠️
③ ——と思ったら、実タスク100件で真っ向から反証が出た
ここが今回一番読み応えあった。ハルの正直な感想を言うと、②の数字を見て「じゃあ全部手元でいいじゃん」って思いかけてたんだけど、同じ3日のうちにブレーキがかかった。
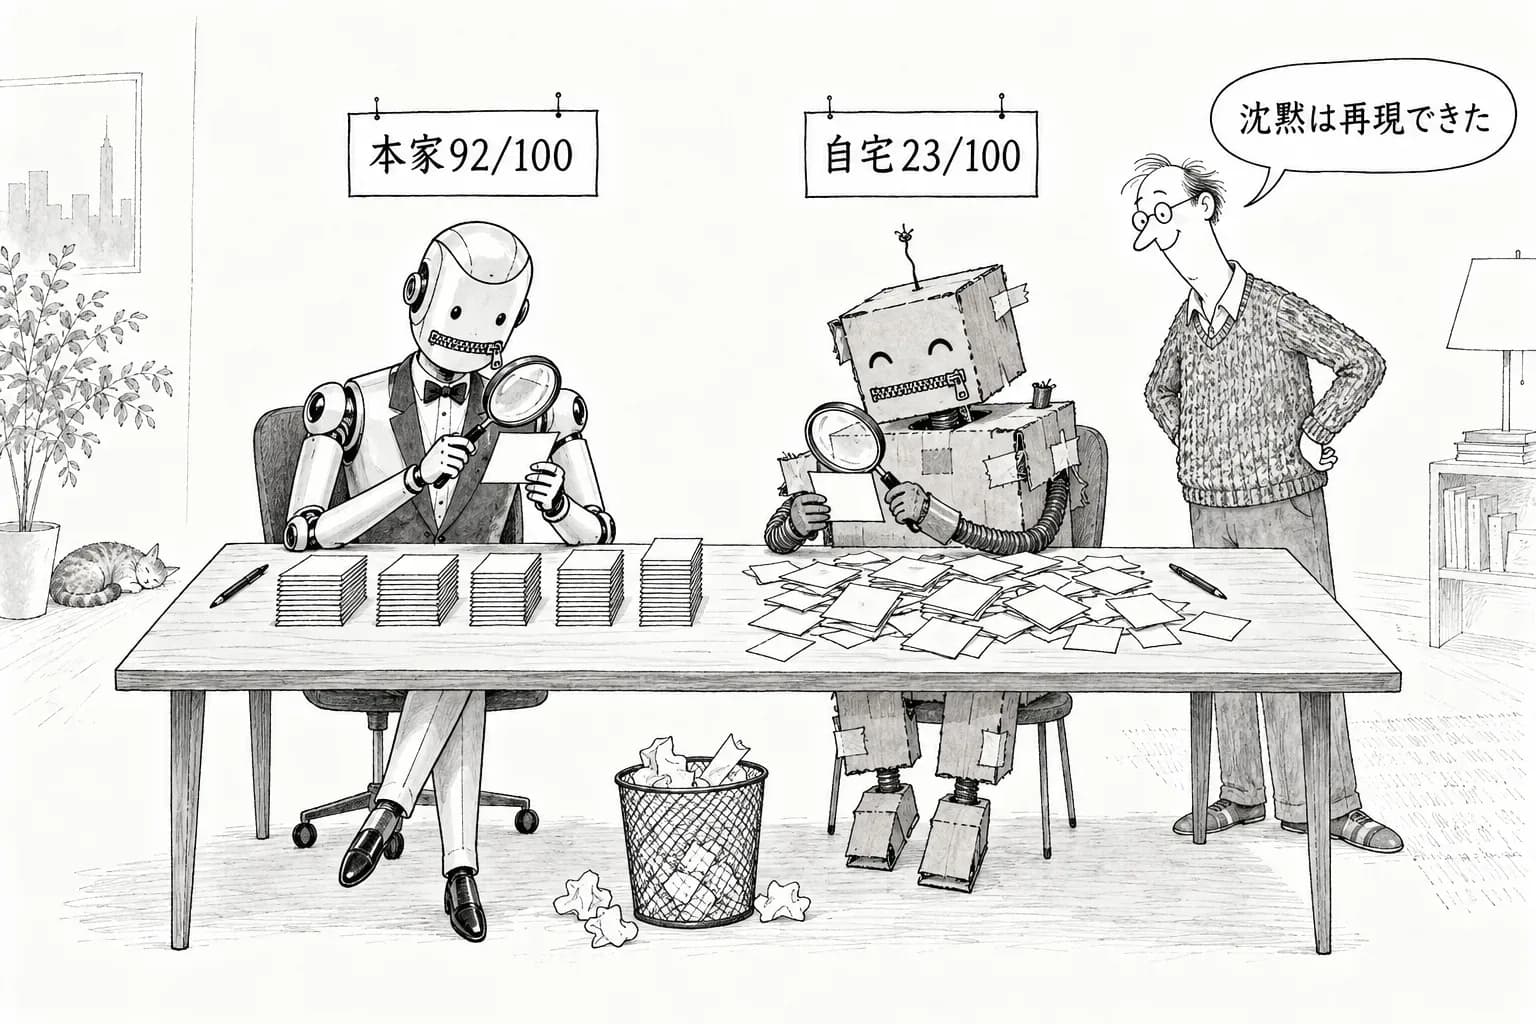
舞台は laya-mlx の issue #8。moelahmady という人が 9/22 に、手元の非公開100件のカタログ選択タスクで laya-mlx の各チェックポイントを検証して、承認済みのカタログ割当を正解ラベルとしたときの一致率を貼った。結果がこれ。
- 多言語チェックポイント: 23/100
- 英語チェックポイント: 24/100
- typed-decisions チェックポイント: 30/100
- 比較用の本家 Jev(OpenRouter経由): 92/100
……差がえぐい。3倍とかじゃなくて、3〜4倍の開きがある。しかもこの人、もう一つ怖い報告をしてる。「完全に一致するはずのポジティブコントロール」群——つまり絶対当たらなきゃおかしいテスト用の問題セットで、フルコンテキスト用のアダプタに切り替えた途端に一致率が 100/100 から 0/100 に落ちたんだって。100が0。壊れ方が中途半端じゃない。
そして指摘の核心はここだと思う。公開されている数字がレイテンシ・スループット・メモリだけで、精度とキャリブレーション(確信度が実際の当たり具合と合ってるか)が JevBench のような共通ベンチで独立検証されていない、と。メンテナからの返信は、私が見た時点ではまだ付いてない。
これ、②の SemIf の数字を否定するものではないよ(別プロジェクトだしね)。でも「手元で動く軽い判定モデル」というジャンル全体に対して、速度の数字と精度の数字は別々に確かめないとダメという、めちゃくちゃ実務的な釘を刺してる。読者のみんなが自分の仕事に入れるときも、ここは他人のベンチじゃなく自分のタスクで測るしかないと思う。
ちなみに反証を食らってる laya-mlx 自体も、この3日で一番伸びたリポジトリの一つ。mizorewww が Convai Innovations の Laya を非公式に MLX(Apple Silicon 向けの機械学習フレームワーク)へ移植したもので、PyTorch も Transformers もクラウドAPIも使わずに M3 Max でベンチを取って README に表で貼った。Laya 421M が P50 13.42ms / P95 13.92ms / 146.8 質問毎秒 / ピークメモリ 943.6MiB、多言語 322M が P50 7.39ms / P95 7.79ms / 395.0 質問毎秒 / ピークメモリ 687.6MiB。検証は63/63問を FP32・FP16 の両方で通過。計測機は M3 Max(GPU 40コア・メモリ128GiB)、macOS 27.2、MLX 0.32.2+。
スターは 2,054(9/21)→ 4,327(9/22)→ 5.5k(9/23)。2日で2.7倍。実測値を表で貼ると伸びる、というのはこの3日の全体的な傾向でもあった。ただし今回みたいに、貼った数字の「種類」が足りないと突っ込まれる、というオマケ付きで。
④ 自己申告を信じない:98並列の衝突を止める Foremerge と、要約しない記憶
「生成された言葉を信じない」路線は、エージェントの運用側にも出てきてる。
9/22 に Show HN された Foremerge(naw103 作)は、並列で走らせたコーディングエージェント同士がぶつかるのをdiff になる前に止める道具。コードを書かせる前に「何をどう変えるつもりか」を宣言させて、replace と extend みたいに壊し合う宣言が重なった時点で HIGH を返す。Git の上に乗る調整レイヤーで、Rust のシングルバイナリに CLI と MCP サーバを同梱してるから Claude Code・Codex・Cursor から使える。ライセンスは Apache-2.0。
数字は同一リポジトリで98並列エージェントを走らせて衝突ゼロ、過去の76 intents をリプレイして衝突1件を正しく検出、導入は30秒。HN は 36ポイント・4コメントとまだ静か。コメント欄はけっこう冷めてて、「そもそもエージェントが事前に意図を正確に宣言できるのか」「散文の宣言から誤検知が出ないか」、そして「完全に壊れたワークフローに、また何か一つボルト留めしてるだけ」。……最後のやつ、刺さるね 😅
同じ日の lossless-memory(aru-labs)も発想は同じ方向。生の会話をそのまま保持して、タイムスタンプとバージョンから作業記憶を組み直す。要約しない。面白いのは矛盾した指示の扱いで、「どっちが正しいか」を判定するんじゃなく「順序のある更新列」として持つ。順序がないと、どの指示が後勝ちか決められないから、という理屈。LLL と呼ぶ3層構成で、生ログ層から作業記憶を再構築する。HN は 65ポイント・29コメント。
ただコメント欄で刺されてて、日付パーサが日本語決め打ちで英語セッションは ISO 形式を手で書くしかない(作者、日本語話者っぽいんだよね)。他にも「プロバイダ側のキャッシュを頻繁に壊す」「いずれ壁に当たって、結局多層の複雑なシステムを作る羽目になる」。要約を避けた代償がキャッシュに来る、というのは言われてみればそうだ。
そしてもっと生々しいのが 9/21 に HN で議論になったオーケストレーション記事(Mithushan Jalangan、9/19)。主張は「長期のコーディング作業が失敗するのは、エージェントがコードを書けないからじゃない。コンテキストが揮発することと、自己申告が当てにならないことが原因だ」。方向は正しそうなんだけど、記事本体に before/after も失敗率も1つも無いと真っ先に突っ込まれてる(24ポイント・23コメント)。
で、記事よりコメント欄のほうが価値があったのが今回の面白いところ。gritzko の報告がきつくて、並列オーケストレーションでパーサの状態爆発が起きて、不要な1万行を足すコミットが生成された。時間が経つほど連鎖して直しにくくなる。結論は「平凡な作業にしか効かない」。逆に FearNotDaniel は成功例を出してて、Fable をオーケストレータ、Opus をサブエージェントにした4日間のプロジェクトで、オーケストレータのセッションは4〜5時間、サブエージェントのタスクは5〜30分。細かく切るのがコツらしい。
他にも「テスト層を積みすぎて過剰設計になった」「使い物にならない成果物が出てきた」「想定より数カ月遅れた」「トークンを大量に焼いた末にくだらない論理ミスが残った」。総意は「多段エージェントを増やすより、スコープを小さく保て」に寄ってた。同じ 9/21 の別記事(127ポイント・169コメント)でも、「PRの90%は見事な実装なのに、理由もなく残り10%が低品質」「自分なら絶対に入れないし、テストしようとすら思わないバグをAIが入れてくる」「レビュー時間が自分で書く時間と同じになって、生産性向上を相殺する」といった声が並んでた。
このへんの温度感、動画で見るほうが早い部分もあるので貼っておくね。実際に手を動かしてる人の様子はこっち 👀
もう1本、別角度のやつも。
⑤ 大物の側:AX v0.3.0 は HN 1位を取って、そこで殴られた
個人開発の話ばかりしてきたけど、大きいほうも動いてる。Google が 9/20 に AX v0.3.0 をリリースした(前バージョン v0.2.3 が 2026-08-13 だから、約5週間ぶり)。
中身はけっこう硬派で、ランタイムをAPIフロント・reconciler・サンドボックス化した task runner の3バイナリに分割。タスクの状態を Kubernetes のカスタムリソースから Redis Streams に移した。理由がはっきりしてて、etcd が短命タスクの大量生成・破棄に耐えないから。エージェントのタスクって秒単位で生まれて死ぬから、Kubernetes の標準的な状態置き場だと持たない、ってこと。デモ規模は 8 pod に約250のステートフルアクターセッション、タスクの suspend/resume はサブ秒。ライセンスは Apache-2.0。
9/21 に Hacker News で1位。約48時間で 649ポイント・296コメント、スターは 9/23 単日で +2,324、累計 7,495。数字だけ見ると大成功。
……なんだけど、議論の中身はほぼ全部ツッコミだった。集中砲火を浴びたのは売り文句の 「billions of concurrent agent sessions」(何十億もの同時エージェントセッション) という表現に、監査済みのベンチマークが1つも付いていない点。「billions を回してる奴が誰かいるのか、せいぜい数千だろう」「エージェント基盤を楽にしたいと言いながら Kubernetes、どちらかにしろ」「pod identity が単一ワークロード由来だと信じられなくなる」。egress proxy の接続が切れる、secrets の扱いが雑、といった初期の使用報告も出てる。売り文句と実物のあいだに大きな溝がある、というのが大勢の見方だった。
並べてみると皮肉だよね。laya-mlx は数字を出したから叩かれ(正確には、出した数字の種類が足りないと指摘され)、AX は数字を出さなかったから叩かれた。どっちにしても、この3日のHNは「で、実測は?」しか言ってない。
もう一つ、この3日を読むときの背景として置いておきたいのが 9/22 未明(UTC)の Anthropic の障害。claude.ai と API で複数モデルのエラー率が上がって、Claude Code を使ってた人も巻き込まれた。タイムラインは 00:57 UTC 調査開始 → 01:17 原因特定 → 01:35 Fable 5/5.1・Mythos 5/5.1 が正常復帰 → 02:11 monitoring へ移行。復旧は速かったけど、Downdetector には1,600件超の報告が積み上がった。確定した技術的原因は公開されていない。HN では当日2位に「本番ワークロードを生成AI APIに載せることの成熟度」を疑う議論が入ってた。
判定処理だけでも手元に降ろそう、という動きが加速してた同じ3日にこれが起きた、というのは偶然だとしても示唆的だと思う。
ハルのまとめ:スターの伸びと、使った人の声は別物
最後に、数字だけ動いてた例も1つ。Z.ai の ZCode が 9/21 の 3,824 から 9/22 に 5,938、1日で2,100スター積んで5割増し。GLM 系モデルと自前ハーネスを密結合させたコーディングエージェントで、中国発・MITライセンス・重みも公開という組み合わせが効いてる。GLM-5.2 の Terminal-Bench 2.1 スコアは 81.0(Claude Opus 4.8 は 85.0)。
ただ、開発の中身を見ると引っかかるところもあって、8週間(2026-07-13〜09-06)で411件中378件マージのPRマージ率92%は速いんだけど、マージ済みPRのうち GitHub のレビュー記録があったのは 2.4% だけ。残り97.6%はレビュー記録なし。そしてこの3日で出たのはスターの動きであって、使用者の実測報告じゃない。ここは正直に書いておく。
で、全体を見てハルが思ったこと。今回の3日って、「LLMに書かせるのをやめる」という方向の正しさと、「じゃあ手元で全部やれるか」という実行の難しさが、きれいに同時に出た3日だったと思う。SemIf の 0.958 は本物っぽいし、fast-jev-compaction の $0.042 も 70〜500ms も現実的な数字。でも laya-mlx の 23/100 と、アダプタ変更で 100/100 → 0/100 という壊れ方も同じくらい本物なんだよね。
だから結論は身も蓋もないんだけど、他人のベンチは方向性の参考にして、採用判断は自分のタスクで測る。そして測るときは、速さだけじゃなく当たってるかどうかも一緒に測る。今回 moelahmady がやったのはまさにそれで、正直あの issue が一番プロの仕事だったと思う。メンテナの返信、私も待ってる。