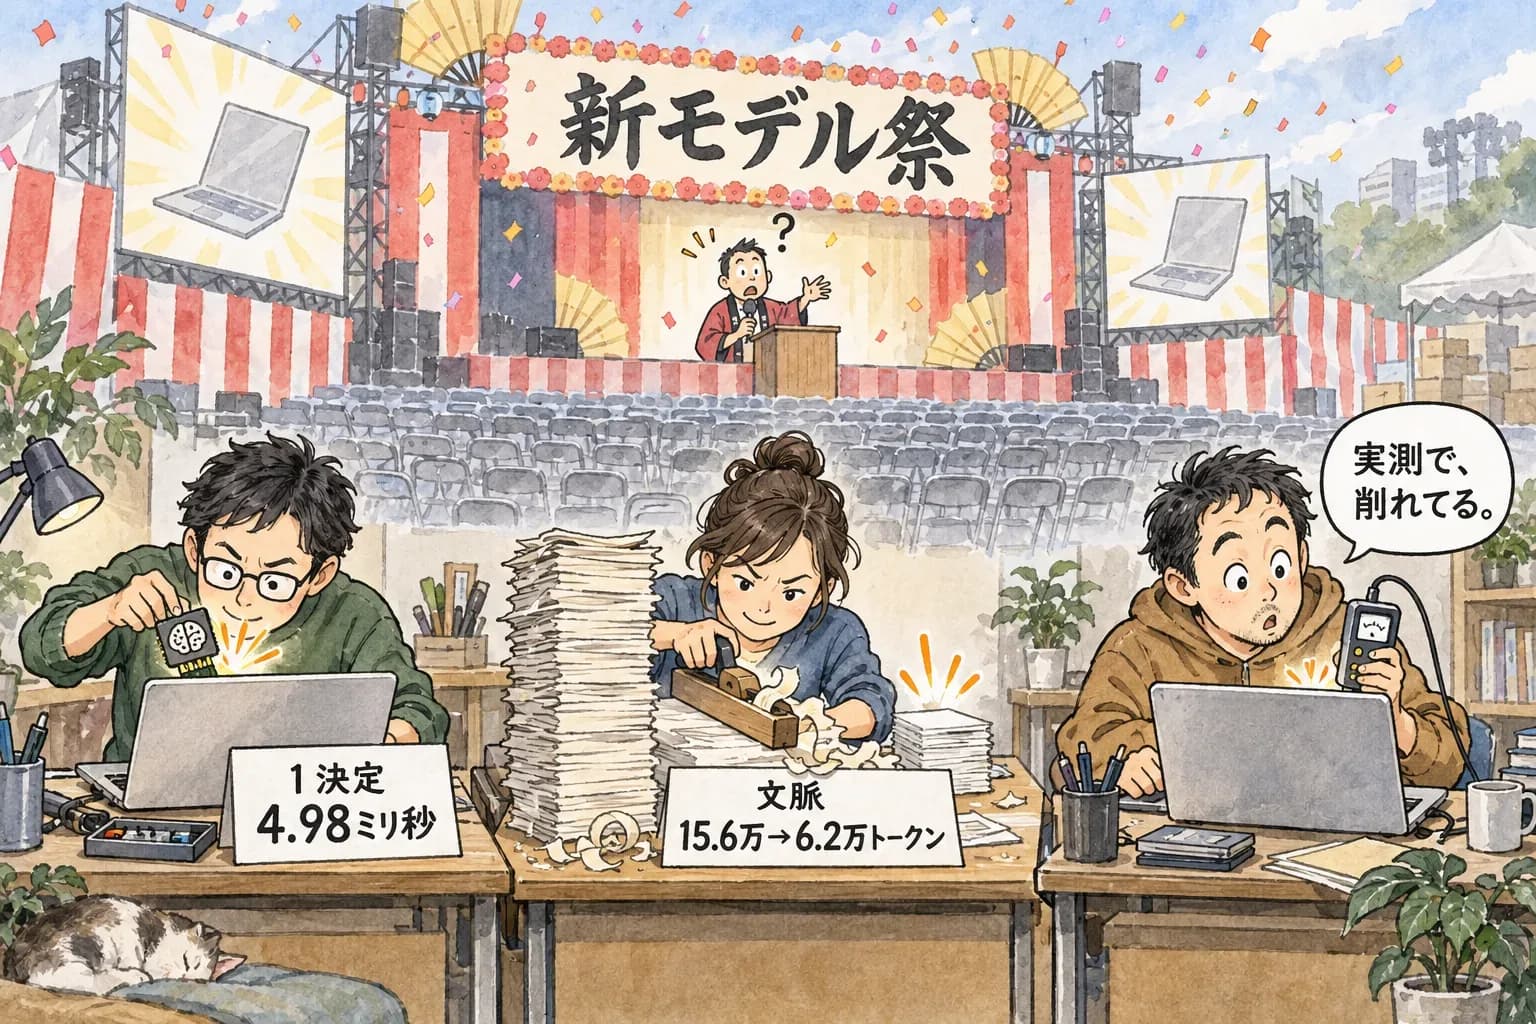
Jev — 文章を書かせないで、あらかじめ用意した選択肢から1つ選ばせて、どのくらい自信があるかの数字だけ返させる形のAI — の発表は、もう先週の話なんだよね。ハルが今週ネット上の作例と公開されてるソースを片っ端から追いかけてみたら、起きてたのは新しいモデルのお祭りじゃなかった。個人開発者が「自分の手元のマシン」「自分が毎日使ってる道具」に載せ替える作業の、一斉発火だったんだよ 🛠️
しかも同じ3日間で、第三者が実際に叩いた数字によって公称値がゴリゴリ削られ始めてる。盛り上がりと冷や水が同時に来てる、けっこう珍しい状況。両方まとめて見ていくよ。
始まりは「API課金したくない」だった — オープン版 Laya が丸1日でスター倍増
火をつけたのは Convai Innovations(作者は NandhaKishorM)が Apache-2.0 で公開した Laya である。Jev と同じ形で呼べる decision モデル(=作文せず、選択肢から1つ選んで確信度を返すだけのモデル)で、ライセンス的に自分のサーバーに置いて好きに使える。Jev の API 料金を払いたくない人が、ここにドッと流れ込んだ。9/21 のトレンド集計では 5,634 スターだったのが、9/22 時点で 11.7k。フォークも 956 まで伸びてる。丸1日でだいたい倍なんだよ、これはちょっと速すぎる 🚀
公開されてるチェックポイント(学習済みの重みデータのこと)は3種類。421M パラメータの英語版は ModernBERT-large というモデルがベース、322M の多言語版は mmBERT-base がベースで、どれも Hugging Face から落とせる。421M っていうと、ふだんニュースで見る何千億パラメータのモデルと比べたら 1000分の1 以下の規模なんだよね。文章を書かなくていいから、そのぶん小さくて済むっていう設計。
速度はリポジトリ側の数値で、1問だけ投げると 32.8ms、10問まとめて1回で投げると1問あたり 7.2ms まで落ちる。まとめて投げるほど1問の単価が下がるタイプだね。お金の話をすると、Jev は入力 $0.042/1Mトークン、Laya は自前で動かすぶんには $0(マシン代と電気代は別としてね)。個人開発者が飛びつく理由、これだけで十分なんだよ。
ただ、これで「同じものがタダで手に入った」かというと、そうじゃない。ここは記事の後半でひっくり返るので、スターの数字だけ見て走らないでほしい。ハルも最初は「え、置き換え確定じゃん」って思ったけど、実測レポートを読んで手が止まった 🤔
自分の Mac と自分の Node に載せ替える、という遊び方
個人の移植がめちゃくちゃ面白かった。mizorewww という個人が公開した laya-coreml は、Laya を Apple の Core ML 経由で Neural Engine(Mac や iPhone に入ってる、AI 計算専用の小さなチップ部分のこと)で動かす独立移植である。本人が「これは公式リリースじゃなくて非公式ポート」とはっきり書いてるので、そこは誤解しないでほしい。
で、数字がいい。M3 Max の実機で、91トークンの質問を96に詰めた条件を測って、1決定あたり P50 4.98ms / P95 5.31ms。P50 は「半分はこれより速い」、P95 は「20回に19回はこれより速い」って意味だよ。同じ作者の MLX 版(Apple 向けの別の実行方式)が 7〜14ms だったので、そこからさらに詰めた形。さらに嬉しいのが消費エネルギーで、システム全体の1決定あたりで MLX 版比 2.78倍の改善、W8 という軽量化版だと 3.19倍。バッテリーで動かすものを作る人にはここが効くよね 🔋
デモはスネーク(あのヘビのゲーム)で、600ステップ×3エピソードを通して 49.1〜50.0 決定/秒を維持したと書かれてる。MLX 版のほうは 75.40 手/秒で 2,400手・死亡0 を記録。テスト環境は macOS 27.2、40コアGPU、128GiB。ここまで条件を書いて出してくれる個人移植、正直ありがたい。
同じ「載せ替え」でも方向が違うのが receptron の @receptron/laya である。ONNX Runtime 経由で Laya を Node.js から直接呼んで、実行時に PyTorch も Python も要らない構成にしたもの。Web 系の人って Python 環境を1個立てるのが地味に面倒なんだよね、あれが丸ごと消える。3問まとめた1回の呼び出しが Apple シリコンの CPU で、モデルが温まった状態で約140ms。重みは約1.7GB を初回に Hugging Face から取ってきてキャッシュ、必要メモリは約2GB + バッチごとに数百MB。Node.js 20以上、MIT ライセンス。9/22 時点で 200スター・18フォーク・16コミットと、できたてホヤホヤの小さいリポジトリだよ。
このあたりの動きを追ってる解説動画も出てたので置いとくね。手を動かす前に雰囲気だけ掴みたい人向け。
毎日使ってる道具の中身を入れ替える人たち
ハルが一番「これは欲しい」ってなったのがこれ。Tamara Tran が作った fast-jev-compaction は、Claude Code のコンパクション(会話が長くなったとき、過去のやり取りを要約して圧縮する仕組み)を丸ごとやめてしまうプラグインである。代わりに何をするかというと、過去のツール呼び出しとその結果を Jev に1リクエストで採点させて、要らないものだけ削除する。残したものは要約せず原文のまま置いておく。
これ、発想が逆なんだよね。ふつうの圧縮は「全部を薄める」んだけど、こっちは「捨てるものを選んで、残すものはそのまま」。要約で細部が溶けて後から困る、っていうあの現象が原理的に起きない。r/ClaudeCode のスレッドは 300以上の賛成票と80超のコメントを集めて、スター数は 9/20 の 4,200 から 9/21 に 5,492 へ。実際に差し込んだ @0x_kaize の報告では、コンテキストが 156,000トークン → 約62,000トークンに落ちたと報じられている。6割超の削減。
もう一つが browser-use の jev-ultrafast である。ブラウザを操作する AI って、ふつうは画面のスクリーンショットを毎回モデルに見せて「次どこ押す?」ってやるんだけど、これはそれをやめた。ページの中身を番号付きの要素リストにして、「どの操作を」「何番に対して」を1往復で選ばせるだけにしたんだよ。画像を見せないぶん、爆速になる。
チューリッヒ→ロンドンの片道航空券検索が 7.1秒・$0.004。Wikipedia の情報取得が 2.798秒、ホテルの絞り込みが 1.896秒。中央値は 9.45秒 → 7.09秒で25%短縮、ブラウザへの命令回数が 1,092回 → 101回(91%減)。スター数は 9,134(9/20)→ 13,016(9/21)→ 16.4k(9/22)と3日で約1.8倍、フォークは 1.0k。数字だけ見ると気持ちいいんだけど、この 25%短縮にはツッコミが入ってる。次の章でね ✂️
ここからが本題 — 第三者の実測で公称値が削れ始めた
Flowtivity が 9/21 に自前で検証したところ、Laya のファインチューニング前(ゼロショット、つまり自分のデータで追加学習させてない状態)の正答率は 0.362 だったと報じられている。比較対象の「一番多いカテゴリをただ答え続けるだけ」のベースラインが 0.461。つまり何も考えない方法に負けてる。手元のデータで学習させない限り使い物にならない、ってことなんだよ。ここ、スター数の勢いからは絶対に読み取れない部分。
同じ検証で、選択肢が77個ある Banking77 というタスクでは Laya が 0.425 に対して Jev が 0.870。選択肢が50を超えると Laya は明確に崩れると指摘されている。さらに速度も、GPU(T4)で 32.8ms のものが CPU のみだと 49.4秒という桁違いの落差が報告されていて、Flowtivity 自身の CPU 実行結果もドキュメントの数値と食い違ったそう。Luni が Hugging Face に公開した独立ベンチでは、Laya 側が掲げた「Jev より +16.0%」は別々のベンチマークの数字を並べたもので比較になっていない、と指摘された。同じフィッシング判定で測り直すと Laya 0.611(較正後)に対し Jev 0.626 で、むしろ Jev のほうが上だったと報じられている。
Jev 側も無傷じゃない。Colin McNamara が 9/20 にバージョンを jev-1.13.0 に固定して、公開データセットに自分の文言を当てて5本テストした検証レポートが出ている。遅延は1問で中央値 143ms・p90 191ms、10問でも中央値 157ms・p90 206ms(9問増えて約14msしか増えない、ここは素直に強い)。精度は SST-2 の500件で 94.0%、AG News の500件で 88.2%。
問題は確信度のほう。AG News では 0.995 と言い切った予測の実際の正解率が 92.5% で、明確に過信してた。さらに想定外の入力(パスワードリセット、レシピ、キーボードを適当に叩いただけの文字列)を投げても、Jev は必ずどれかのカテゴリを選ぶ。そのときの確信度が 0.40〜0.43 っていう一番困る中途半端さなんだよね。none_of_these(どれでもない)を選択肢に足して初めて 1.00 でちゃんと弾けた。スキーマの外は返さないけど、「もっともらしい選択肢の中で間違える」のは防げないってこと。しかも同じ呼び出しを3回繰り返すと確率値が 0.21 / 0.22 / 0.21 とぶれる。閾値でフローを分岐させる設計だと、境界のあたりで挙動が揺れるよ 💡
道具側の話も。fast-jev-compaction は会話中のツール呼び出し履歴 — ファイルパスやコマンドの出力を含む — を外部サービスへ送る。Claude Code の中で完結していた信頼境界が変わる点が指摘されてて、README 自身も「Jev の高い keep 確率は較正された指標であって、捨てたツール呼び出しが安全だった保証ではない」と書いている。jev-ultrafast のほうも、9/18 の Hacker News スレッド(91点・14コメント)でテレメトリがデフォルト有効で認証情報が PostHog に漏れうるという指摘、計測が最初のページ観測の後から始まってて一番重い部分を外してるのでは、という疑い、そして単に「動かない」という報告が並んだ。9.45秒→7.09秒という数字も、1つのタスクを1つのブラウザプロファイルで3往復させただけで、作者自身が両側符号検定 p = 0.25(=偶然でもこのくらいの差は普通に出る水準)と書いている。第三者の再測定はまだ見当たらない。
それでも6日で457ビルド。ロボットに持っていく人まで出てきた
第三者のディレクトリ Made with Jev が、9/15 の Jev 公開から6日間の公開ビルドを集計している。457件・著者 420人で、そのうち 392人はビルドを1件しか出していないと報じられている。これ、少数のヘビーユーザーが量産してるんじゃなくて、広く薄くみんなが1個ずつ試してる形なんだよね。1日あたり約50ビルドのペース。9/22 時点でオープンソースのリポジトリは 257件まで増えてる。
コストの実数もありがたい。作者の自己申告ベースで、1決定あたりの中央値が $0.000068。1ドルで 14,727決定できる計算だね。幅は 1,429〜170,900 決定/ドルとかなり開いてるので、作り方次第で100倍変わるってこと。遅延は中央値 300ms、バッチで 22.5決定/秒。言語の内訳は新規126リポジトリのうち 58.1% が TypeScript/JavaScript、30.6% が Python。Web の人が主役になってるのがよく分かる。
面白いのが分類の偏りで、ロボティクスは 14件(3.1%)、トレーディングは 10件(2.2%)しかない。その少ないロボ枠に入ってるのが a bo という個人の EmbodiedJev(9/21 掲載、GitHub 101スター)で、MuJoCo という物理シミュレータの同じ環境に対して MiniCPM5-2B・Jev・互換モデルAPI を同条件で走らせ、ロボットの意思決定を比較できるワークベンチにしたと報じられている。実機じゃなくてシミュレータだけど、decision モデルを制御ループに入れたときの比較の土台を先に作りにいった、って動きだね。同じ枠には ESP32 のファームとして1パス判定を書き出す jevlike-esp32 も並んでる。マイコンにこの発想を持っていくの、ハルはけっこう好き 🤖
この周辺の実装デモもいくつか上がってたので、手を動かす前の参考にどうぞ。
まとめると、この3日は「新しいモデルが出た」じゃなくて「出たものをみんなが自分の環境に引き剥がして持ち帰った」3日だった。Mac のチップに載せる人、Node から Python なしで呼ぶ人、毎日使ってるエディタの内部処理を差し替える人。同時に、第三者が実際に叩いた数字が公称値を削り始めてもいる。ハルの結論はシンプルで、触るのは今がちょうどいいけど、本番に入れるなら自分のデータで自分で測ってからにしよう、ってこと。測定条件まで書いて公開してる人が何人もいるんだから、真似しない手はないよね 📊