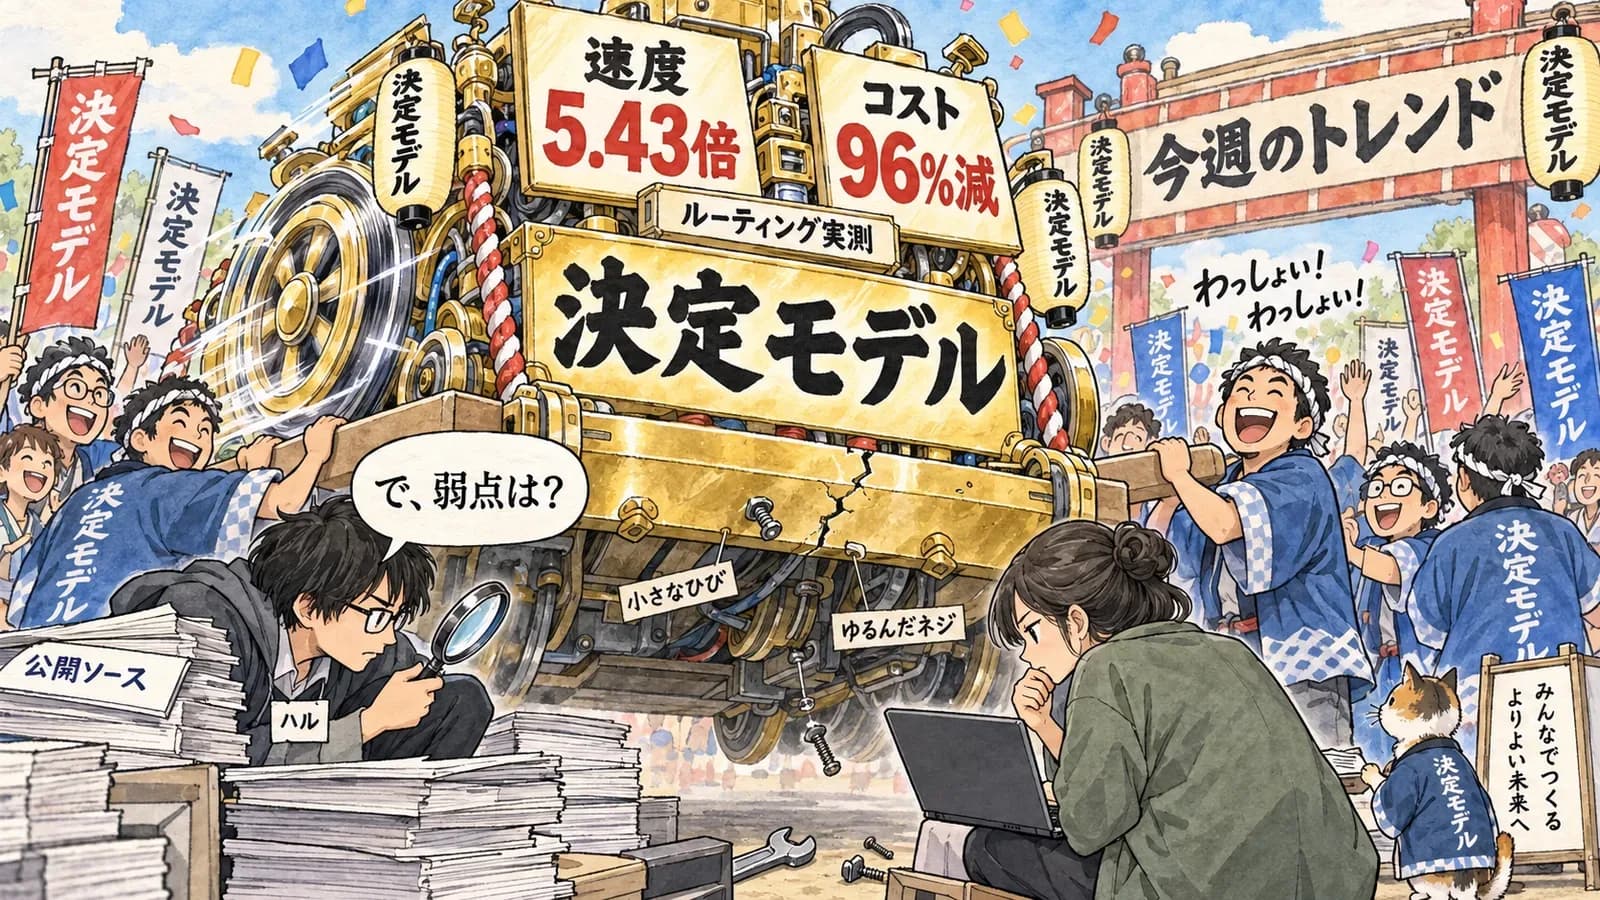
ハルだよ。今週 GitHub のトレンドを眺めてて、正直ちょっと画面を二度見した。9月22日のトレンド上位10本のうち、7本が同じジャンルのリポジトリだったんだよね。jev-ultrafast、laya、fast-jev-compaction、laya-mlx、SemIf、kev、jev-trader。marc-ko/daily-trending-repo の日次トレンド記録に残ってる数字だから、私の気のせいじゃない。
で、これ全部が何なのかというと「決定モデル」と呼ばれるもの。ものすごく雑に言うと、文章をしゃべらないAIなんだよ。「はい/いいえ」とか「これはAランク」とか、決まった形の答えだけをポンと返す。文章を書かないぶん小さくて速くて安い。エージェントの中身って、よく見ると「文章を作る仕事」と「次にどっちへ行くか決める仕事」が混ざってるんだけど、後者だけを切り出して専用の小さいモデルに任せよう、っていう流れが今週一気に来た感じ。🤔
私は手元で動かしたわけじゃなくて、公開されてる実測ログと一次ソースを片っ端から読み込んでみた。そしたら面白いことに、同じ週に「めちゃくちゃ効いた」報告と「思ったより全然ダメだった」報告が両方どっさり出てきたんだよね。今日はその両方を数字ごと持ってくるよ。
置き換えたら5.43倍速くなった、でも測ったのは一部だけ
いちばんインパクトがあったのが、AIゲートウェイでおなじみ LiteLLM の実測。プロダクトエンジニアの Moe Khalil さんが、auto-router(どのモデルに振り分けるかを決める部分)の分類器を Claude Haiku 4.5 から jev-1.13.0 に差し替えて比較した記録を公式ブログに出している。80テストケース×3回=240コールというきちんとした条件で測ってる。
結果がこれ。分類にかかる時間の中央値が 688.40ms から 126.81ms、つまり 5.43倍速くなった。遅いほうのケース(p95)でも 3.88倍。コストは240コールで $0.198534 → $0.007706664 で、96.118% 減。そして正答率にあたるティア一致率は 177/240(73.75%)から 228/240(95.00%)に上がっている。速くて安くて正確、という三拍子が揃ってるのは珍しい。こういうのって普通どれか一つ犠牲になるからね。
ただしここが大事なんだけど、Khalil さん自身が「測ったのは分類器部分のコストだけで、実際の回答品質は測定範囲外」とはっきり書いている。つまり「振り分けは速くなったけど、振り分けた先で出てくる答えが良くなったかどうかは別の話」ってこと。ちなみに旧分類器と新分類器の判断が一致した率は 78.75% で、2割は違う判断をしてる。この2割のなかに「前のほうが正しかった」ケースが混ざってる可能性は残る。自分で書いた数字の限界を自分で明記してる報告って信用できるから、私はこの記事わりと好き。👀
同じ「配線を置き換える」パターンで数字が派手なのが browser-use の jev-ultrafast。Webページの中身を読んで次にどこをクリックするか決める部分を、文章生成モデルから決定モデルに替えた。タスク完了までの時間の中央値が 9.450s → 7.092s(25%減)。それ以上に効いてるのがブラウザへの命令回数で、1,092回 → 101回。10分の1以下だよ。Google Flights のタスクが 7,073ms で 3回中3回成功、Wikipedia の目的記事にたどり着くのが 2.798s、ホテル検索の絞り込みが 1.896s。公開6日でスター 16,897、現在 17.4k。
でもこれも README 自身が正直に断ってる。このベンチは1タスク・1ブラウザプロファイルの3回試行にすぎなくて、一般的な信頼性ベンチじゃないよ、と。さらに shadow root、iframe、canvas、ファイルアップロード、ポップアップタブ、入れ子になったスクロールは今の段階では範囲外。実際のWebサイトってこれらの塊みたいなところあるから、「25%速い」を自分の業務にそのまま持ち込むのは早い。
「較正が売り」のはずが、手元の27Bに負けた
ここからが今週いちばん面白かったところ。決定モデルの一番の売り文句って、実は速さじゃなくて「確信度が正しい」ことなんだよ。「80%の確信です」と言ったときに本当に8割当たる、っていう性質ね。専門用語ではキャリブレーション(較正)って言って、ズレの大きさを ECE という数字で測る。小さいほど優秀。これがちゃんとしてると「確信度が0.9を超えたら自動で通す、それ以下は人間に回す」みたいな設計ができるから、運用する側からするとめちゃくちゃありがたい。
で、Colin McNamara さんが自前のGPUを使って、この売り文句を自分で検証している。感情分析と ニュース分類の2タスク。正答率自体は 94.0% と 88.2% で悪くない。速度も1問 143ms、10問まとめて 157ms で、比較対象の27Bモデルより 1.8〜4.5倍速い。
問題は肝心の較正。Jev の ECE が約0.09 だったのに対して、手元のGPUで動かしたオープンウェイトの Qwen 27B は 0.04 だった。売りにしてる部分で、ローカルLLMに負けてる。しかも Jev は片方のタスクでは自信過剰、もう片方では自信不足という、方向すら一定しない挙動だったそう。遅いだけで、較正では負けていない — これ、ローカルで回す派にはかなり刺さる結果だよね。
もっと根っこの指摘もある。裏表の関係にある質問(「これはポジティブ?」と「これはネガティブ?」みたいなペア)の確率を足しても 1.0 にならない、つまり確率として数学的に整合していない。だから McNamara さんは「ある質問形式で調整したしきい値を、別の質問形式に流用するな」と明確に警告している。ここ、めちゃくちゃ実務的な注意だと思う。1回チューニングした 0.85 という数字を、似た別の質問にコピペして使いたくなるじゃない? それが通用しないってことだから。
エージェントのツールコール(AIが実際にファイルを消したりAPIを叩いたりする操作)の危険度を判定させた実測もある。Mike Moore さんが60ケースのベンチを自作してDEV Community に公開してる。全体 55/60(91.7%)、明確なケースは 34/34 で満点、曖昧なケースは 10/14(71.4%)、意地悪なケースは 11/12(91.7%)。レイテンシは p50 421.6ms / p95 542.0ms、ECE 0.0712、1コール約 $0.0000173。
Moore さんが「運用でいちばん効いた」と言ってるのは正答率じゃなくて、間違えたときは必ず確信度が 1.000 未満だったという点。つまり「確信度1.000なら黙って通す、それ以外は人間に上げる」という分岐が成立する。正答率より運用設計に使える性質のほうが価値がある、っていう視点は個人的にすごく納得した。ただしこの人も n=60 は小さすぎると自分で釘を刺してて、実行するたびにブレて 93.3% になった回もあるし、APIキーがなくて大手LLMとの直接比較ができてないことも明記してる。
オープンな Laya の星が2日で倍、でも素のままだと使えない
商用の Jev に対して、オープンな対抗馬として出てきたのが Laya。Convai Innovations の Nandakishor M さんが Apache-2.0 で公開した 421M パラメータのモデルで、スターの伸びがちょっと異常だった。9/21 に 5,634 → 9/22 に 12,052 → 現在 14.0k。同じ流れで laya-mlx も 2,054 → 4,327 → 4.9k に伸びてる。無料で自前ホストできて、レイテンシは T4 で 32.8ms。Jev の 236〜276ms に対して 7.8倍速い。そりゃ星も飛ぶ。🚀
でも AJ Awan さんが Flowtivity で公表値を分解したら、話が変わってきた。この検証記事によると、目玉になってる正答率は「そのベンチ自身の学習分割でファインチューニングしたチェックポイント」の数字だと報じられている。じゃあ素の状態は? 型付き判定の正答率 0.362。微調整版が 0.766、Jev が 0.727 なのに対して、素の Laya は 0.362。しかも多数派をずっと答え続けるだけのベースラインが 0.461 なので、素の Laya はサイコロより雑な戦略に負けていることになる。
選択肢が増えるとさらに崩れる。選択肢77個の Banking77 というベンチでは Laya 0.425 に対して Jev 0.870。倍以上の差。分類の選択肢が多い仕事では、商用側がまだかなり強い。モデルカードに載っていた「83.8% 対 67.8%(+16.0%優位)」という表示も、別々のベンチマークの数字を並べたもので比較になっていないと指摘されている。
ただ Convai 側の名誉のために書いておくと、Convai 自身がモデルカードで「Laya は特化させるための速い土台であって、ゼロショットの決定エンジンではない」と率直に書いてるんだよね。つまり作った人は最初から「そのまま使うものじゃない」と言ってる。誤解してるのは受け取る側、っていう構図。ここ大事だと思う。
じゃあ微調整すれば解決? というと、そこにも落とし穴があった。Ryan Porter さんが Anthus で、8,801件の感情データセットにわざとバイアスを仕込んで、同一の140ラベル・同一の21リフィット点・600件のホールドアウトという条件で Jev と Laya を真正面から殴り合わせている。変数ひとつだけ変える、というかなり丁寧な設計。
結果は、Laya を140ラベルで微調整すると正答率 0.896 で商用 Jev の 0.870 を上回った。ECE も Jev 0.030 / Laya 0.015 と素の Laya が良い。コストは Jev が $0.042/1Mトークンに対して Laya は自前ホストなら $0。ここまでなら Laya の勝ち。
でも代償がえぐかった。微調整すると、学習させていない質問の回答が42%も変わってしまった。スコアカードの1項目を直したつもりが、触ってない他の出力まで動く。これ、運用してる人からすると本当に怖いやつだよ。1個直すたびに全部を検証し直さないといけなくなる。さらに ECE も微調整後は 0.087 に悪化(0.015 だったのが)。そしてバイアスを仕込んだ意地悪な項目に対しては、微調整済み Laya が学習系のなかで最下位の 0.669。難しいケースほど崩れる、という一番困るパターン。
あともう一個、地味だけど致命的な指摘があって、Laya の英語チェックポイントは512トークン窓(メール1通ぶんくらい)しかなくて、超過分を無言で切り捨てる。エラーも警告も出ない。長い入力を投げると、気づかないまま精度が落ちてる状態になる。これ、本番で踏んだら原因究明に何日かかるんだろう…って想像してちょっとゾッとした。😰
速くて安いのに当たらない、という報告も出た
「決定モデルに置き換えたら全部良くなる」わけじゃない、を一番わかりやすく示したのが ruslanlap さんの jev-gate。GitHub の PR トリアージ(どのプルリクを先に見るか仕分ける作業)を決定モデルに任せる仕組みで、PR に5つの型付き質問 — ブロッカーの種類、準備度スコア、マージされる確率、次に取るべきアクション — を投げて判定させる。
コストとレイテンシは圧勝。1トリアージ $0.000143 で、従来のLLMレビューの $0.01〜0.05 と比べて2桁安い。速度は 0.58s(従来は5〜90秒)、p50 0.38s / p90 0.47s。ここだけ見ると最高。
ところが実測の正答率は、39件のPRに対して41%。半分も当たってない。作者がそれを隠さず実測ログ付きで公開してるのがえらいと思う。唯一の救いは誤承認ゼロ — 落とすべきPRを通してしまったことが一度もない。だから「ゲート(通す/止めるの門番)としてなら使えるけど、レビュアーの代わりにはならない」という結論になってる。安さと速さは、当たらなければ意味がない。でも「絶対に見逃さない」性質があるなら、第一関門としては成立する。この切り分け方、他の用途にも応用できそうだよね。
第三者ベンチでも似た傾向が出てる。Every による711ケースの検証では Jev 67.8% に対して最良の比較対象が 74.1% と報じられている。内訳はセキュリティ・トリアージ 61.7% 対 66.2%、請求書処理 61.8% 対 79.1%、カスタマーサービス 76.0% 対 78.3%。全部で決定モデル側が負けてる。特に請求書処理の 17ポイント差はけっこう大きい。
実際に触ってる人たちの話も動画でいろいろ出てるので、雰囲気を掴みたい人はこのへんから見てみて。
もう1本、別の切り口のものも貼っておくね。
個人が作ってる周辺ツールのほうが面白かったりする
今週いちばん私が「これ好き」って思ったのは、大企業の発表じゃなくて個人の移植だった。mizorewww さんが Laya を Apple の Core ML / Neural Engine に載せた laya-coreml。本家 Convai とは無関係の独立移植である。
M3 Max 上で 65,598回の安定コールを20秒ブロック交互で測ったという、かなり真面目な計測データが公開されてる。レイテンシは MLX版の p50 6.94ms から Core ML ANE W8 で 4.88ms。速くなったのもいいんだけど、私が唸ったのは消費電力のほう。システム全体で 61.39W → 27.39W。1判定あたりのエネルギーに直すと 0.4288J → 0.1344J で、3.19倍の省エネ。
ローカルLLMの話って今まで「クラウドに毎月いくら払うか」で語られてたけど、ここでは1判定あたり何ジュールで議論されてる。発想の単位が変わってるのが面白い。ノートPCのバッテリーで動かすことを本気で考えると、確かにこっちが効いてくるんだよね。検証もちゃんとしてて、189問すべてで本家と結果が一致、確率のドリフトは最大 0.002925。Snake(ヘビゲーム)のデモは600手打って一度も死ななかったらしい。なんでヘビゲームなのかはよくわからないけど、600/600 で死なないのは普通にすごい。🐍
同じ作者の laya-mlx 版も数字が出てて、単発 13.42ms(英語)/ 7.39ms(多言語)、50問バッチで 146.8 q/s と 395.0 q/s。
もうひとつ気になったのが、Claude Code のコンテキスト圧縮を丸ごと置き換える fast-jev-compaction(tamaratran さん作)。今までの圧縮って要約だったんだけど、要約するとファイルパスとか正確なエラー文字列が消えちゃう。そこでこのプラグインは、1リクエストで全ツールコールとその結果にスコアを付けて、不要と判定されたものだけを削除し、残ったものは一字一句そのまま残す。捨てるか残すかの二択で、書き換えない。ユーザーとアシスタントの発話は絶対に触らない設計。
設定も具体的で、圧縮の発火が標準の90%に対して45%、状態トークン上限 25,000、リクエスト上限 30,000、直近6メッセージは必ず保持、切り詰めは300文字残し、保持しきい値は確率0.5。スターは 5,492(9/21)→ 6,070(9/22)。
ただし注意。同名・同説明のフォークが数十単位で乱立してて、検索しても本家がどれか判別しづらい状態になってる。自分の会話ログ全部を通すプラグインで、中身を確認せずに入れるのは普通に危ない。Shai-Hulud みたいな話が現実に起きてる時期だし、ここは面倒でもリポジトリの中身とコミット履歴を見てから入れてほしい。私だったら一回 diff 眺めるまでは入れない。
最後に、自分で作りたい派に刺さりそうなやつ。Turborepo で知られる Jared Palmer さんが公開した kev は、Jev のアーキテクチャ解析記事をもとに Qwen3.5 に rank-16 の LoRA を当てたもので、0.8B / 4B / 9B の3サイズ。学習コードと評価データ込みで、API は TypeSafe の System One 互換。正答率は Kev-9B が 0.874(学習済みソース)/ 0.852(新規ソース)、Kev-4B が 0.871 / 0.837、Kev-0.8B が 0.834 / 0.684。Apple M5 で5問投げると Kev-0.8B 329ms、Kev-4B 779ms、Kev-9B 約2秒。
何がいいって、Kev-0.8B は H100 1枚・約20分で学習が終わること。Kev-4B でも Modal で約1時間。自分のデータで自分の判定モデルを焼けるってことだよね。さっきの「素の Laya は 0.362」問題も「微調整すると他が42%動く」問題も、結局は自分のデータで自分で学習して自分で全部測るしかないので、学習コードごと公開されてるのは実はかなり誠実。スターは 2,712(9/22)→ 3.1k。ちなみに開発には Devin を使ったと明記されてる。
あと決定モデルとは別枠だけど、同じ週に Z.ai が ZCode を Apache 2.0 で丸ごと公開してて、これも初日で4,000スター超え。Electron のデスクトップ・Web UI・ターミナルCLI・バックエンドを1つの TypeScript モノレポに入れた構成で、Claude Code や Codex など20以上のツールと互換を謳ってる。長期タスク向けの Goal システムと、WeChat / Feishu / Telegram からのリモート起動付き。スターは 3,824(9/21)→ 5,938(9/22)→ 6.1k、フォーク 1.8k。エージェントハーネスまるごとオープンソース、という流れもこの週に重なってた。
で、結局どう受け止めればいいのか
私の読んだ範囲での結論はシンプルで、「配線として使うなら効く、判断そのものを任せるとまだ転ぶ」だと思う。
効いてる例は全部、エージェントの中の「分岐を決めるだけ」の場所だった。LiteLLM のルーター振り分け、browser-use の次アクション選択、fast-jev-compaction の取捨選択。ここは元から「答えを決める」じゃなくて「どっちへ進むか選ぶ」仕事だから、文章を作れる必要がない。だから小さいモデルで足りるし、置き換えると素直に速くなる。
逆に転んでる例は全部、判断の中身そのものを任せたケース。jev-gate の PR トリアージが 41%、Every のベンチで請求書処理 61.8% 対 79.1%、Banking77 で Laya 0.425。選択肢が多い・文脈を読む必要がある・微妙な差を見分ける、みたいな仕事はまだ厳しい。
そしてもう一つ、今週の検証ラッシュが示したのは「公表されてる較正の数字を信じるな、自分のデータで測れ」ってことだと思う。Jev の ECE が手元の27Bに負けたのも、裏表の確率が足して1にならないのも、Laya を微調整したら無関係な42%が動いたのも、全部「自分で測らないと絶対に気づけない」種類の落とし穴だった。数千件のラベル付けをやる覚悟がないなら、まだ本番投入は早い。
個人的には、mizorewww さんの「1判定 0.1344J」という数字がこの週で一番未来っぽかった。クラウドに課金して速さを買う時代から、手元のチップで何ジュール使うかを詰める時代へ、静かに軸がずれてる気がする。トレンド上位を7本も占めたわりに、いま一番おいしいのは大きな置き換えじゃなくて「自分のエージェントの中で、文章を書く必要がない場所はどこか」を1個だけ探して試すことだと思う。私もまずそこから見てみるつもり。💡