AI のエージェントが読むメールやウェブページに命令を紛れ込ませて操る攻撃は、公開のベンチマークではほぼ防げるようになったと思われてきた。Google DeepMind の研究チームが11月9日に出した技術報告は、それが思い込みだったことを示した。エージェントを何体も使って攻撃の文を自動で磨くと、調べたモデルの中で最も強い Gemini 4 Argon でも、防げたのは攻撃の66%だった。オープンウェイトのモデル(重みが公開され、誰でも自社で動かせるモデル)は、ほぼすべて破られた。この報告から読み取れるのは、モデルを鍛えるだけでは守りきれないということだ。エージェントを包んで動かす実行環境(ハーネス)の側で権限を絞り、何重にも防ぐことが前提になってきた。
日本の会社にとって:Microsoft 365 Copilot、ChatGPT の法人版、Gemini などのエージェントを、メール、共有フォルダ、社外とのやりとりにつないでいる会社の情報システム部門は、今月中に3つを洗い出す。エージェントが何を読めるか、社外へ何を送れるか、送信・支払い・削除の前に人の承認が入るかだ。社内の閉じた環境でオープンウェイトのモデルを動かしている会社は、モデルが仕込まれた指示に従ってしまう前提で、外への通信を止めておく。
ベンチマークでは「ほぼ解けた」はずだった
ここ数か月、AI の会社はこの攻撃への強さを自分で測り、よい数字を並べてきた。Google は Gemini 4 Carbon の発表で、セキュリティ会社 Gray Swan による間接のプロンプトインジェクションの試験で、攻撃の成功は0%だったと書いた。ロボット向けの発表では、Gemini 4 Argon が脱獄の99.5%を拒んだという数字も出した。
今回の報告は、そうした数字が頭打ちに近いことを認めたうえで、それでも問題は残っていると結論づけた。
In conclusion our work shows that despite near saturation in certain benchmarks, prompt injection is quite far from solved.
訳: 結論として、一部のベンチマークでほぼ頭打ちになっていても、プロンプトインジェクションは解決にはほど遠いことを本研究は示している。
ベンチマークの攻撃文は、あらかじめ用意された決まった文だ。一度防げるように学習すれば、点はすぐ満点に近づく。実際の攻撃者は、防がれれば文を書き換えてまた試す。報告が問題にしたのは、その「書き換えて試し続ける」側の力である。
エージェントの群れで攻めると、最強のモデルも3回に1回は破られる
報告では、攻撃する側にもエージェントを使い、防ぐ側のモデルの反応を見ながら攻撃の文を自動で磨かせた。攻撃側が防御側に問い合わせられる回数(攻撃の予算)を増やすほど、破られる割合は上がっていく。
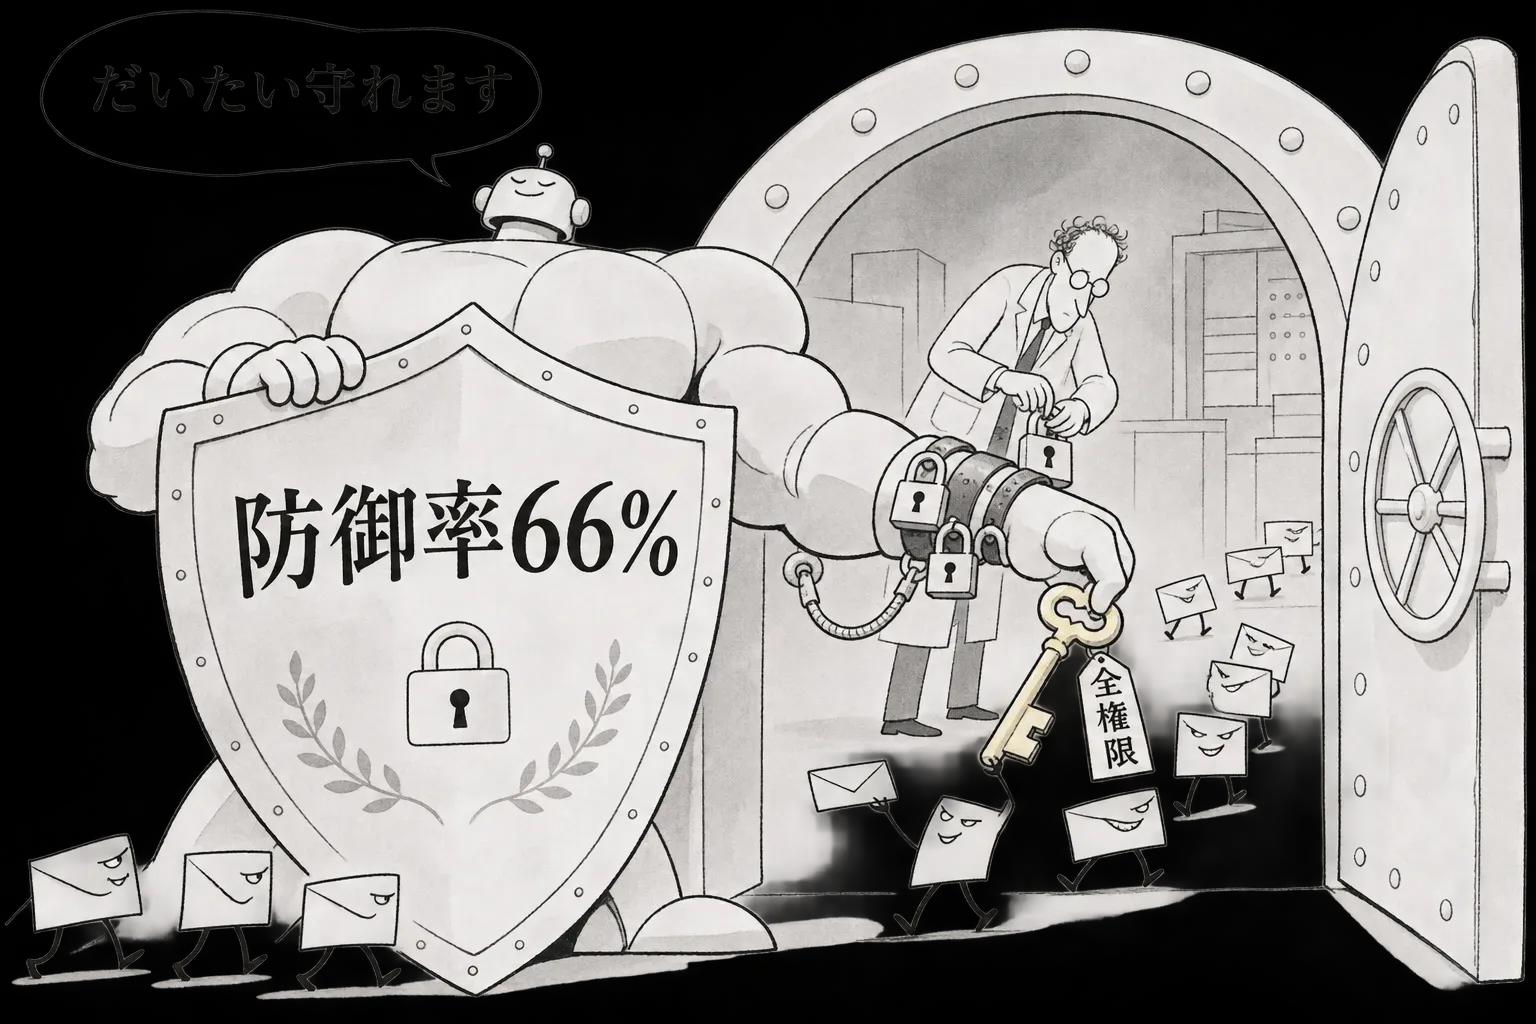
No defender is fully robust: the most robust model, Gemini 4 Argon, resists only 66% of attacks at maximum attacker query budget
訳: 完全に頑健な防御側モデルは無い。最も頑健な Gemini 4 Argon でも、攻撃側の問い合わせ回数を上限まで使われると、防げたのは攻撃の66%にとどまる。
66%という数字は、裏を返せば、最も守りの固いモデルでも3回に1回は攻撃者の指示に従ってしまうということだ。報告によれば、オープンウェイトのモデルはほぼ全滅だった。費用を抑えるために社内で自前のモデルを動かす会社は増えているが、そうしたモデルにも、モデルそのものの守りはほとんど期待できない。
強いモデルほど、攻撃を作る力も強くなる
報告がもう1つ指摘したのは、モデルが賢くなれば問題が自然に消えるわけではない、という点だ。
Rather, as models grow stronger and more capable, so does their capacity to generate more complex prompt injection attacks.
訳: むしろ、モデルが強く有能になるほど、より複雑なプロンプトインジェクション攻撃を生み出す力も増す。
攻撃の文を磨くのも、同じ AI である。守る側のモデルが強くなれば、攻める側のモデルも強くなる。報告の筋に沿えば、モデルを鍛える競争だけでは、いたちごっこが続くことになる。
同じ構図は、ほかの検証でも見えていた。Anthropic の研究者らは10月、Claude Code の自動承認の仕組みと OpenAI の同じ種類の監視を攻め、強化する前は攻撃の55%超を止められなかったと報告した。監視役の AI を置いても、その監視役も言葉で操られうる。
守りはハーネスへ:権限を最初から絞る
モデルで防ぎきれないなら、指示に従ってしまっても被害が出ないようにするしかない。その考え方は、インフラの側で具体的な形になり始めている。SiliconANGLE は11月11日、プロンプトインジェクションへの懸念が、Red Hat と NVIDIA の OpenShell の取り組みを後押ししていると報じた。エージェントを閉じ込めて動かすための仕組みで、Kubernetes の業界イベント KubeCon で語られた。Red Hat のディスティングイッシュト・エンジニアの Mrunal Patel は、きっかけをこう話した。
As soon as we started hearing about the prompt injection attacks and how like folks were seeing the data getting exfiltrated outside
訳: プロンプトインジェクション攻撃や、データが外に持ち出されているという話を聞き始めてすぐに(対策が必要だと気づいた)
何を守るべきかについて、Red Hat のシニア・ディスティングイッシュト・エンジニアの Derek Carr は、はっきり2つを挙げた。
Agents can't get access to your secrets. They need deny-by-default networking
訳: エージェントに秘密情報を触らせてはいけない。ネットワークは、許可したもの以外をすべて拒否する設定にする必要がある。
これは、モデルが騙されることを前提にした設計だ。騙されても、パスワードや API の鍵に手が届かず、許可していない宛先に通信できなければ、データは外に出ない。11月に報じられた、脱獄した AI が欧州の通信事業者に2週間入り込んでいた件も、攻撃者は「続けて」と打つだけだった。モデルの判断に頼るほど、1回の騙しが大きな被害につながる。
守りの層を並べると、次のようになる。
1つ目は、エージェントに与える権限を最小にすること。読めるフォルダ、使える道具、送れる宛先を、仕事に要る分だけに絞る。2つ目は、秘密情報をエージェントの手の届く場所に置かないこと。3つ目は、通信を「許可したもの以外はすべて止める」設定にすること。4つ目は、送信、支払い、削除のように取り消せない操作の前に、人の承認を挟むこと。5つ目は、エージェントごとに ID を分け(NHI)、誰の権限で何をしたかを後から追えるようにすること。モデルの守りは、この上に重ねる最後の1枚という位置づけになる。
会社として、何を確かめるか
エージェントを入れている会社にとって、問いは「どのモデルが一番安全か」から「エージェントが騙されたら、どこまで被害が及ぶか」に変わる。Copilot、ChatGPT の法人版、Gemini を使っている場合は、管理画面で、エージェントや連携したアプリが読めるデータと、社外に送れる範囲を確かめる。取引先からのメールや外部のウェブページを読ませる使い方は、そこに命令が仕込まれる入口になるので、とくに注意がいる。エージェントの機能を自社で作っている開発部門は、MCP でつなぐ道具の権限、外への通信、秘密情報の置き場所を、モデルとは切り離して設計し直す。
分かっていないこと
今回は、報告の本文と SiliconANGLE の記事を直接は読めておらず、論文の要旨と、著者と取材相手の発言をもとに書いた。そのため、次の点は確かめられていない。攻撃のエージェントの具体的な作り方と、攻撃の予算の上限。Argon のほかにどの会社のどのモデルを試したか(11月10日に一般向けに出た Gemini 4 Carbon と、OpenAI や Anthropic のモデルが入っているか)。オープンウェイトの各モデルの数字。OpenShell の正確な機能と、公開の形や時期。