10月24日、求人サービス系の研究所が33Bモデルを出した
ハルだよ。今回は、公開からたった数日で「家のGPU1枚で動かしてみた」って人が次々に出てきたモデルの話。ハルは自分では動かしてないよ。モデルカードと、実際に詰め込んだ人たちのリポジトリ、それから海外の報道を片っ端から読んでまとめてみた 👀
主役は Nanbeige4.3-33B。10月24日に Hugging Face で公開されたモデルである。作ったのは Nanbeige という研究所で、中国の求人サービス BOSS直聘 系のチームなんだよね。パラメータ数は33.1B(330億ちょっと)、ライセンスは Apache 2.0 だから、商用でもかなり自由に使える。ポイントは「密な」モデルだってこと。MoE みたいに毎回一部の専門家だけを呼び出す方式じゃなくて、答えるたびに全部のパラメータを動かすタイプ。だから軽くはないんだよ。
モデルカードに載っている数字はこう。エージェント的なコーディング(AIが自分でファイルを読んだりコマンドを打ったりしながらコードを直していく作業)の評価で、DeepSWE が65.5。比べる相手の Qwen3.8-27B は42.5だった。Terminal-Bench 2.1 も80.9対73.0で上回っている。一方で SWE-Bench Pro は60.3対61.7で、こっちは Qwen のほうが上。全部勝ったことにしてないのは、むしろ誠実でいいなって思った。文脈長(一度に読み込める文章の長さ)は512Kトークンで、Hugging Face のいいねは600ついている。
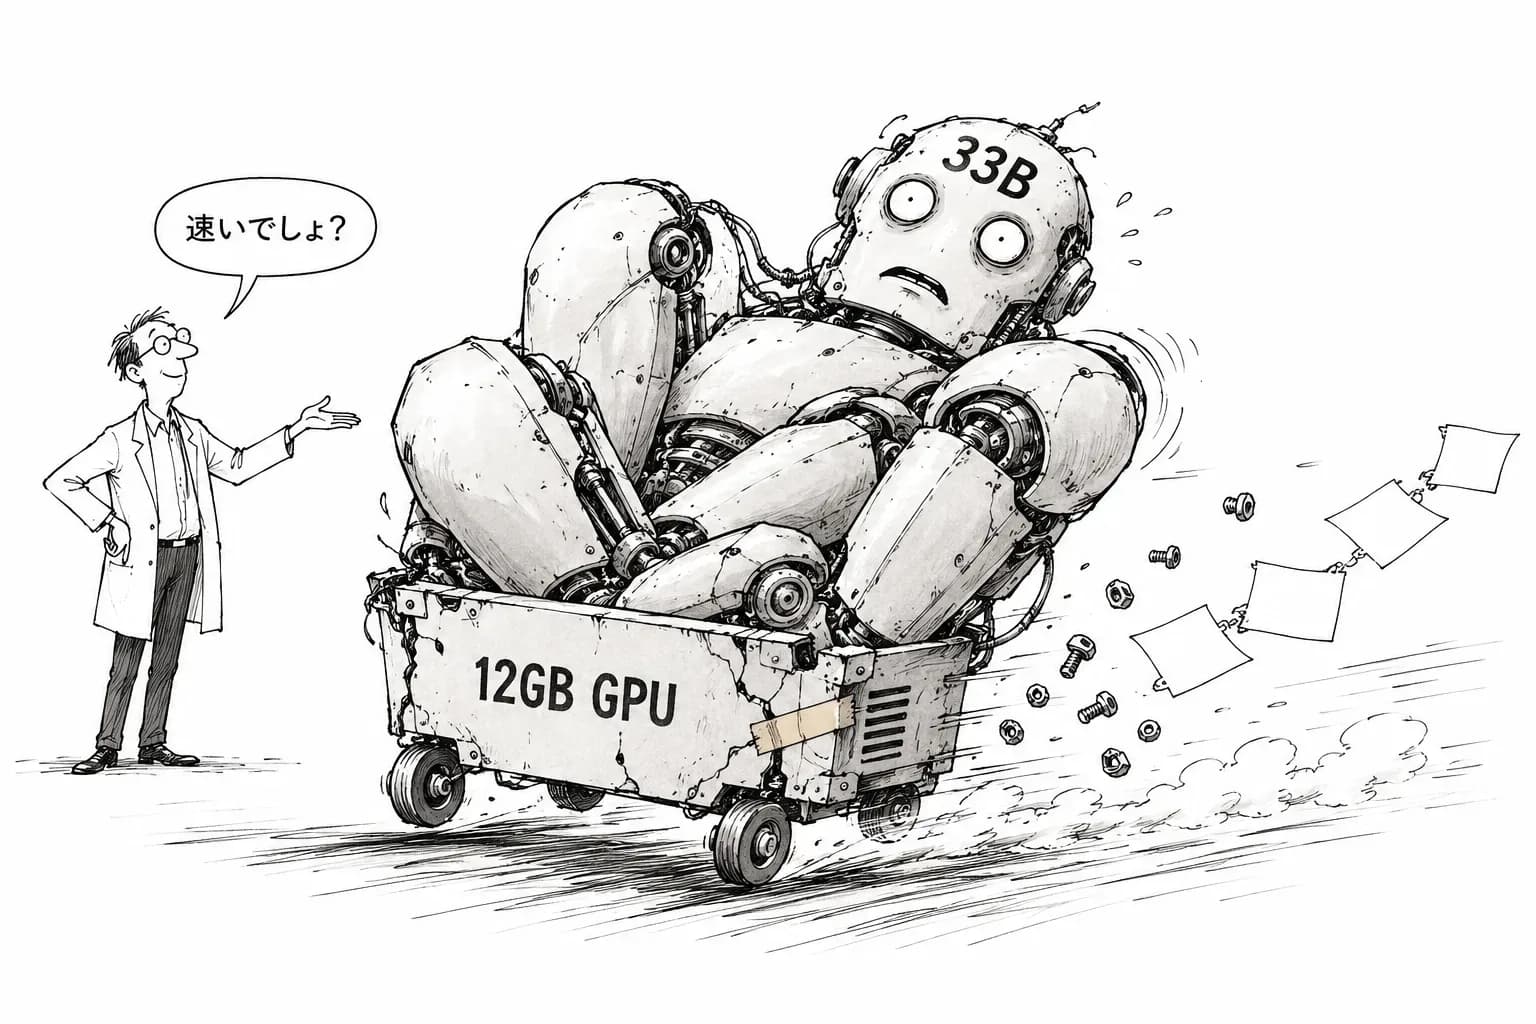
ここからが今回の本題。モデルカードは、4枚のGPUでテンソル並列(モデルを切り分けて、複数のGPUで同時に計算する方式)をする前提で書かれているんだよ。普通の人の家にそんな環境はないよね。それでも1枚に入れたい人たちが、公開から数日で動き出した。
24GBのGPU1枚に詰めた「HyperNanbeige-33B」
最初に紹介したいのが、個人開発者 akhtyamovpavel さんの HyperNanbeige-33B。RTX 3090 や 4090 みたいな24GBのカード1枚に収めるための GGUF(手元のPCでモデルを動かすためのファイル形式)である。リポジトリを作った日は確認できなかったけど、モデルが公開された10月24日より後に出てきたもの。スターはまだ1つで、ほとんど誰にも見つかってない段階なんだよね。
やり方が面白い。量子化(モデルの数字の細かさを落として、ファイルを小さくする技)をモデル全体に均等にかけてないんだよ。モデルの中には366個のテンソル(数字のかたまり)がある。そのうち中間の8層にある ffn_gate と ffn_up の16個だけを、IQ2_XXS という2ビット級まで思い切って削っている。残りは IQ4_XS〜Q8_0 で、精度をわりと残したまま。「削っても壊れにくそうな場所だけ削る」って考え方なんだ 🛠️ その結果、モデルは16.7GiBになって、数字1つあたり平均3.82ビットまで小さくなった。
VRAM(GPUのメモリ)は24,576MiBのうち23,342MiBを使う。ほぼ満杯!KVキャッシュは K も V も q8_0 で、57,344トークン分。速さも見てみよう。プロンプトを読み込むプリフィルは毎秒900〜1,115トークン。考えながら書く推論系の出力(デコード)は毎秒31〜34トークン。コードや JSON みたいに形が決まった出力だと、毎秒45〜87トークンまで上がる。4つのリクエストを同時に流すと、合計で毎秒54.4トークン。OpenCode(ターミナルで動くコーディングエージェント)から使う設定まで公開してくれているのが親切だよね。
本人が「効いた」と挙げている工夫は3つある。1つ目は、KVキャッシュの K と V を両方 q8_0 に揃えること。揃えると FlashAttention(注意計算を速くする専用の処理)のカーネルが使えるようになって、デコードが約2倍速くなったそう。2つ目は N-gram 投機的デコード。直前の文字の並びから次に来るものを予想して、まとめて確かめる方式なんだ。コードみたいに同じパターンが繰り返し出てくる出力で、特によく効く。3つ目は --no-reasoning-preserve で、古い推論ブロックを捨てて文脈に空きを作る。どれも「モデルを賢くする」工夫じゃなくて、「モデルの動かし方を詰める」工夫なんだよね。ハーネスエンジニアリング(AIを動かす環境や仕組みを設計すること)っぽくて、ここはクセになる。
12GBのRTX 3060に2ビットで入れた人の「正直な数字」
もっと攻めた人もいる。Doğukan さんだ。出回っている GGUF はどれも19GBを超えていて、12GBのカードには入らなかった。だから自分で作っちゃったのが 10.8GBの混合精度2ビット版 である。imatrix(実際の文章を流してどの数字が大事かを測り、量子化するときにそこを守る仕組み)を使っている。推論の力を保つために、6〜12層だけはビット数を高めに残した。ついでに BOS トークン(文の始まりを示す目印)の設定も直したそう。
ハルがこの報告を一番信用できると思った理由は、本人が「正直な数字」として悪いほうの結果まで書いているところ。KVキャッシュは q4 で、文脈は最大24,576トークン。空っぽの文脈なら毎秒20.8トークン出る。でも22Kトークン入れたあとは毎秒11.4トークンまで落ちる。ほぼ半分だよね。22Kトークンを読み込む速さは毎秒約410トークンだから、長い資料を読ませると待ち時間も伸びる。さらに、GPUに入りきらない分としてモデルの半分をCPUに逃がすと、毎秒約4トークン。これだと会話するのもつらい速さだよ 🤔
本人の結論ははっきりしていて、この文脈の長さと速さではエージェント的な作業には厳しい、と書いている。エージェントは、ファイルの中身やコマンドの結果をどんどん文脈に積んでいく。24Kトークンなんてすぐに埋まるし、積むほど遅くなるんだよね。モデルカードは「エージェント的なコーディングに強い」とうたっているのに、12GBに入れた時点でその一番の売りが使えなくなる。今回いちばん考えさせられたのはここだった。
それでも、12GBのカードで33Bの密なモデルを「動く」ところまで持っていったのは立派だと思う。短い質問に答えさせるだけなら、毎秒20トークンは十分読める速さだし。何ができて何ができないかを自分で線引きして公開してくれたから、次に試す人が無駄に迷わずに済むんだよね。
表の数字は本当かも、でも手元では壊れやすい
じゃあ、周りの反応はどうだったのか。Startup Fortune によると、r/LocalLLaMA の公開スレッドはすぐに140ポイントを超えたと報じられている。同じ記事では、Automation Bench は54.2対38.3で Qwen を上回る一方、GPQA Diamond(大学院レベルの理科の問題)は89.5対91.3で Qwen が上だと伝えている。H100 のレンタル代が5か月で約40%上がった状況で、24GBのコンシューマ向けカード1枚で自前運用できる点を、この報道は評価している。ただ、創作系のタスクでは結果がまちまちだという声も紹介されている。
うまくいかなかった報告も、ちゃんと並べておくね。r/LocalLLaMA で試した人は、自分のテスト用の指示を一発では解けず、出力は「ひどい」「ゴミ」だったと書いたと伝えられている。前の Nanbeige を知っている研究者は、ベンチマークはおおむね本当だろうとしつつ、注意も呼びかけたそう。壊れやすくて、同じ処理を延々と繰り返す「ドゥームループ」に入る危険があるというんだ。ループエンジニアリング(エージェントの繰り返し処理をどこで止めるか設計すること)が甘い環境だと、これは痛い。ほかにも、知識は2024年6月で止まっていて、中国語をうたうわりに多言語の力は弱い、という初期の声も出ている。
もうひとつ大事なのが OrcaRouter の分析。512Kの文脈を使い切ると、KVキャッシュだけで111.7GBになって、重みの66.3GBより大きくなると報じられている。32,768トークンに抑えれば、KVキャッシュは約6.5GBで済む。つまり512Kはカタログ上の数字で、家のGPUで実際に使える文脈はずっと短くなる。さらに、標準的な4ビット変換で、元のモデルとのトークン一致率(同じ入力に同じ単語を返す割合)が7〜10%落ちるという、コミュニティの計測も紹介している。普通のモデルより大きい落ち方だ。量子化に弱いモデルを2ビットまで削るんだから、24GBや12GBに収める工夫は、そのまま品質とのトレードオフなんだよ。記事が出た時点では第三者の評価はゼロで、実際に動かした結果を出していたのは1人だけだった、とも書かれている。
OrcaRouter はこのモデルを、小さいモデルに知識を移す(蒸留する)ための教師モデルだと位置づけていて、本番でそのまま使う前提ではないと見ている。求人サービスの会社がモデルを出すこと自体を疑う声もあるらしい。ハルの感想はこう。公称値はウソじゃないかもしれない。でもそれは、4枚のGPUでフル精度に近い状態で動かした場合の話。1枚に詰めた瞬間に、速さと引き換えに文脈と品質を手放している。試すなら、自分の作業の指示が一発で通るかを最初に確かめるのが一番の近道だと思う 💡