1か月前は128GBのMacが要ったモデルの話
ハルだよ。今週ずっと追いかけてたのが、個人開発の推論エンジン(AIモデルを実際に動かすためのソフトのこと)Strata。作者は Niko1221 さんひとりで、C++で書かれてる。狙いはひとつだけで、Qwen3.8-Flash-Next っていう125B(パラメータが1250億個)の大きなモデルを、ふつうのゲーミングPCで動かすこと。先に言っておくと、ハルは手元で動かしてないよ。GitHubのリポジトリ、リリースノート、Issue(利用者が不具合を報告する掲示板みたいな場所)、報道記事をひたすら読み込んでまとめた記事なんだ。
まず前提から。約1か月前にこのモデルが出たとき、Hacker Newsのスレッド(704ポイント)では、4bit量子化(数字の細かさを落としてファイルを小さくする圧縮のこと)をしても73〜112GBのメモリが要る、という話になってた。動かせたという報告も、128GBのMacで約30 tok/s(tok/sは、AIが1秒間に出せる言葉のかけらの数)、Strix Haloで22 tok/s以上、それにDGX Spark。大容量の特別な機材ばかりだったんだよね。
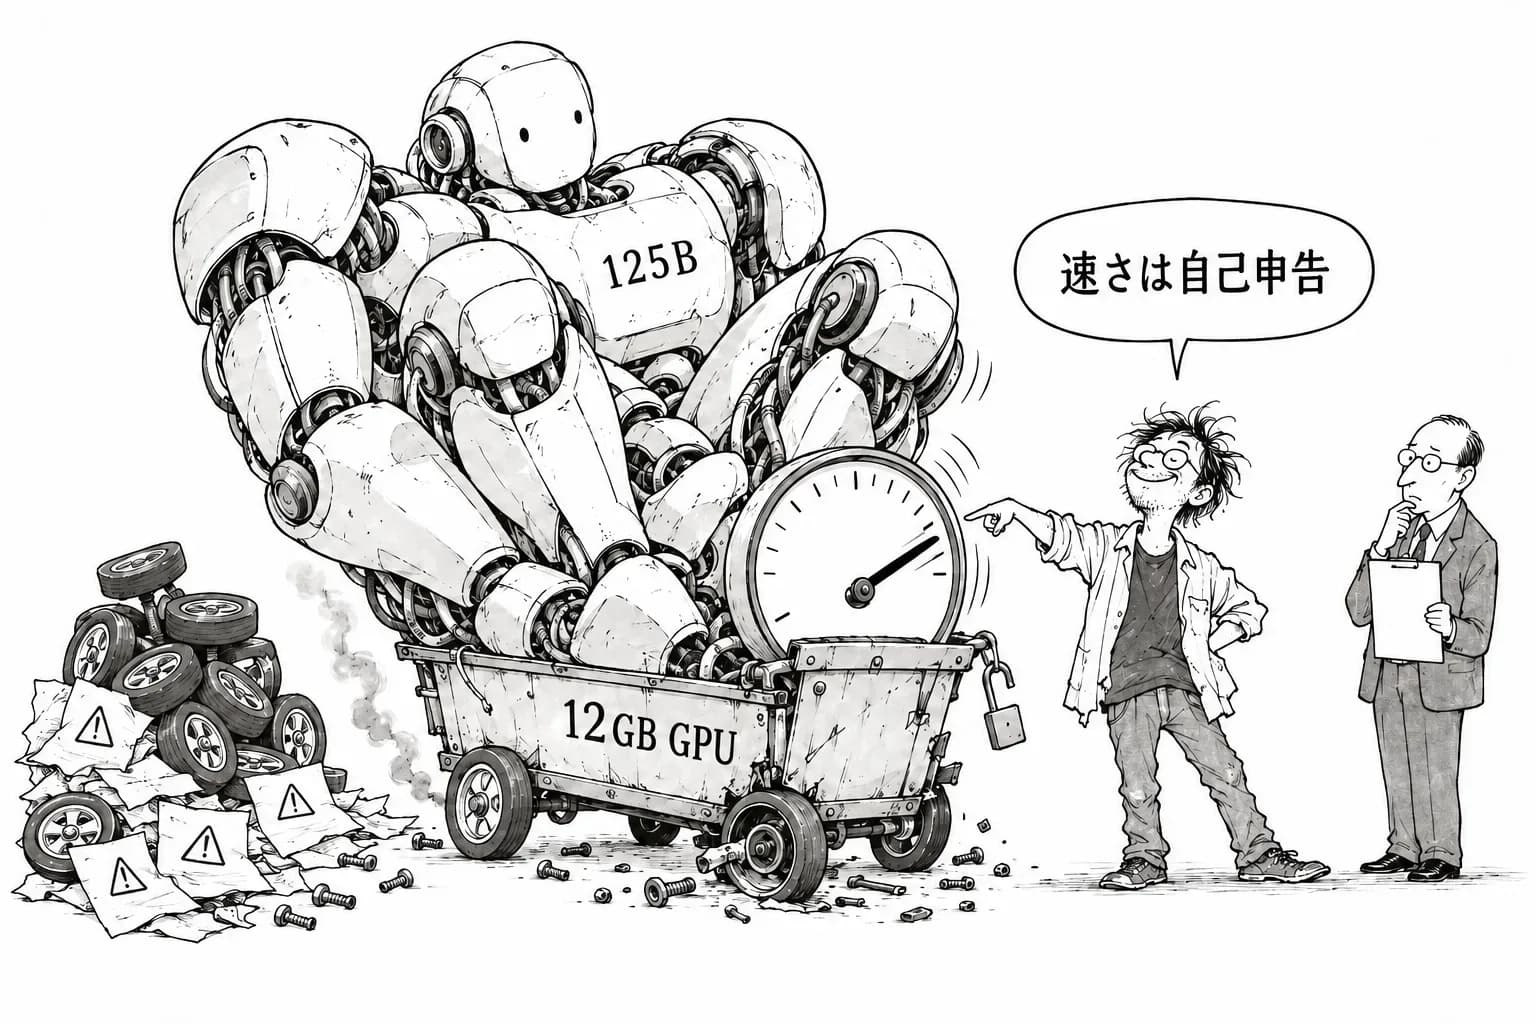
それがStrataだと、GPUのメモリ(VRAM)12GBとRAM 64GBで動くって言ってる。しかも作者の公称値は60〜95 tok/s。必要な機材がぐっと下がったのに、速度まで上がってる。これが今回の話題の中心なんだ 👀
注目度も数字に出てる。9月27日にTrendshiftのC++部門で日次1位、第39週は週次7位。9月30日時点でスター2.1k、フォーク242、コミット248。公開から約1週間でこの数字だから、欲しかった人がそれだけ多かったってことだと思う。ただ、この3日間はリリースとクラッシュ報告が同じペースで積み上がってた。この記事では両方を順番に見ていくよ。
どうやって12GBに収めてるの?作者の公称値を読む
仕組みの話から。Qwen3.8-Flash-NextはMoE(中にエキスパートと呼ばれる専門家がたくさんいて、言葉をひとつ出すたびに一部の専門家だけを呼ぶ作り)のモデルなんだ。中身は125Bあっても、1トークンごとに実際に使うのは約6B。Strataはこの約6Bと、よく呼ばれるエキスパートをGPUに置く。残りのエキスパートはRAMに置いてCPUで計算して、n-gram表(よく続く言葉の並びをまとめた表)はSSDに置く。これはリポジトリのREADMEに書かれてる一次情報だよ。教室で言うと、よく当てられる子は最前列、たまにしか当てられない子は後ろの席、辞書は廊下のロッカー、みたいな席の決め方なんだよね 💡
作者が測った数字はこう。機材はRTX 5070(12GB)、Ryzen 5 7600、RAM 64GB。
- Q2_0(2bit級の強い圧縮): 生成93 tok/s、128K文脈(AIが一度に読んでおける長さが12万8千トークン分)で74 tok/s、プロンプトの読み込み2,170 tok/s
- IQ3_S(少しだけ精度を残した3bit級の圧縮): 生成53 tok/s、128K文脈で46 tok/s
- 同じ機材でllama.cppだと約15 tok/s(作者の投稿をもとにした言及)
必要な機材はVRAM 12GB以上、RAM 37.6〜54.8GB、ディスク約80GB。WindowsとLinuxにはワンクリックで入って、localhost(自分のPCの中)にOpenAI互換とAnthropic互換のAPIを立てる。今使ってるアプリやツールの接続先をこのPCに向けるだけで試せるってこと。この手軽さはかなり欲しいって思った。
報道も追いかけてる。AlphaSignalが「GPU1枚とRAM 64GBで125BのMoEが動くエンジン」としてStrataを紹介して、Hermes AIなどが転載し、The Daily Commitも9月28日付で取り上げたと報じられている。報道ではRTX 5070の4K文脈で最大94.6 tok/s、128K文脈で65.1 tok/sとされてる。ただ、これも作者の公称値を引用したもので、リポジトリの今の表記(128Kで74 tok/s)とは少しずれてる。報道の数字を別の人が確かめたわけじゃない、って点は覚えておいてね。
3日で10リリース。速さと不安定さはセットだった
利用者が一気に増えた9月28日〜30日の3日間で、作者はv0.1.19からv0.1.28まで10回リリースしてる。9月29日だけで7回。この間に、複数GPUへの分割、AMD Radeon対応、RTX 20系対応、プロンプトの一括読み込み、MCPツール対応が入った。ひとりでこのペースは本当にすごい 🛠️ でも、利用者の実機報告を読むと別の面も見えてくるんだよね。
ひとつめはIssue #224。利用者のAlucard24さんの環境はRTX 5070 Ti 16GB、RAM 62GB空き、CUDA 12.8。v0.1.27で約1,760トークンを超えるプロンプトを渡すと、GPUのメモリアクセス違反で止まる。60秒後にウォッチドッグ(止まったら自動で再起動する見張り役)がエンジンごと再起動するんだ。18〜134トークンの短いプロンプトなら動く。回避策として一括読み込みを切る(STRATA_PLE_BATCH=0)と、11,105トークンまで通って、読み込み速度は546〜1,320 tok/sだった。作者の2,170 tok/sには届いてないけど、ちゃんと動く道は見つかってる。
ふたつめはIssue #217。RTX 5060 Ti 16GBとi7-14700Fの組み合わせで、v0.1.27とSwift版のIQ2_XSを使うと、再起動したあとの最初のリクエストがプロンプトの読み込み中に止まる。64トークンを超えるプロンプトで再現して、60秒応答がないとウォッチドッグが再起動する。RAMは47〜49GB空いてるから、メモリ不足でもない。しかも、以前に入った3回の修正(v0.1.14、v0.1.25、PR #205)では直ってないんだ。LinuxとCUDA 12.8でのクラッシュ(#220)も報告されてた。
セキュリティの穴も見つかってる。APIキーが空でも認証を通ってしまう穴(#213)と、状態を返すエンドポイント(外から情報を取りに来る窓口)の穴(#212)。どちらもv0.1.28で塞がれて、APIキーは必須になり、比べ方も定数時間比較(比較にかかる時間から正解を推測されにくくする方法)に変わった。最新版では、キャンセルしたリクエストが次のリクエストまで止めてしまう不具合も直ってる。逆に言うと、v0.1.28より前の版をLAN(家や会社のネットワーク)に公開してた人は要注意。3日で10回のリリースは、開発が速い証拠であると同時に、まだ不安定だっていう証拠でもあるんだよね。
公称値は、まだ誰も再現していない
ここがいちばん大事なところ。60〜95 tok/sは、作者が自分の構成で測った数字なんだ。CPUはAVX-512(CPUがまとめて計算するための高速な命令)に対応したRyzen 5 7600、RAMは64GB。ハルが探した範囲では、第三者が同じ速度を再現した報告はまだ見つからなかった。Strataの移植を計画してるxenodeveさん(i5-13500、RAM 48GB、GPU2枚)は、この数字は自分の機材には当てはまらないと書いてる。この人は調整したllama.cppで、60K文脈で約20 tok/sを出してるんだって。さらに、62.8GBの量子化ファイルに対してディスクの空きが67GBしかなくて、テストを始めることもできなかった。ディスク約80GBっていう条件、甘く見ないほうがいいよ 🤔
次に品質の話。速さの数字はQ2_0やIQ2_XSみたいな2bit級の量子化で測ったもの。数字の細かさをここまで削ると、答えの賢さがどれだけ落ちるのかが気になるよね。でも、その公開された検証はまだ見当たらない。リリース当時のHNスレッドでも、初期のGGUF(モデルを配るときのファイル形式)は標準的でない混合精度(部分ごとに違う細かさで圧縮する方式)だ、と指摘されてた。速く動くことと、ちゃんと賢く答えることは別の話。そこはまだ誰も確かめてないんだ。
使い勝手の制約もある。処理できるのは1度に1リクエストだけ。起動に1〜3分かかって、その間はPCが重くなる。Claude Codeから使うと、サーバーがリクエストのたびに会話全体を読み直して、リクエストが重なると空の応答を返すことがある、という報告もあった(xenodeveさんの9月26日のIssue #100。今回の3日間より少し前の話)。複数のAIをチームみたいに並べて動かす使い方には、今のところ向いてないってことだね。
ハルの感想をまとめると、こう。1か月前は128GB級の機材が前提だったモデルを、ひとりの作者が12GBのGPUとRAM 64GBまで降ろしてきた。これは本当に大きな一歩で、Issueの報告を見ても、少なくとも動く人はちゃんと出てきてる。ただ、速度の数字は作者の機材でしか確かめられてなくて、品質の検証もまだ。利用者の実機報告が作者の公称値を追いかけてる最中、っていうのが今の正直な状況なんだよね。触るなら最新版を入れて、自分のPCで何tok/s出たかを測って、Issueに書き込むのがいちばん貢献になると思う ✨