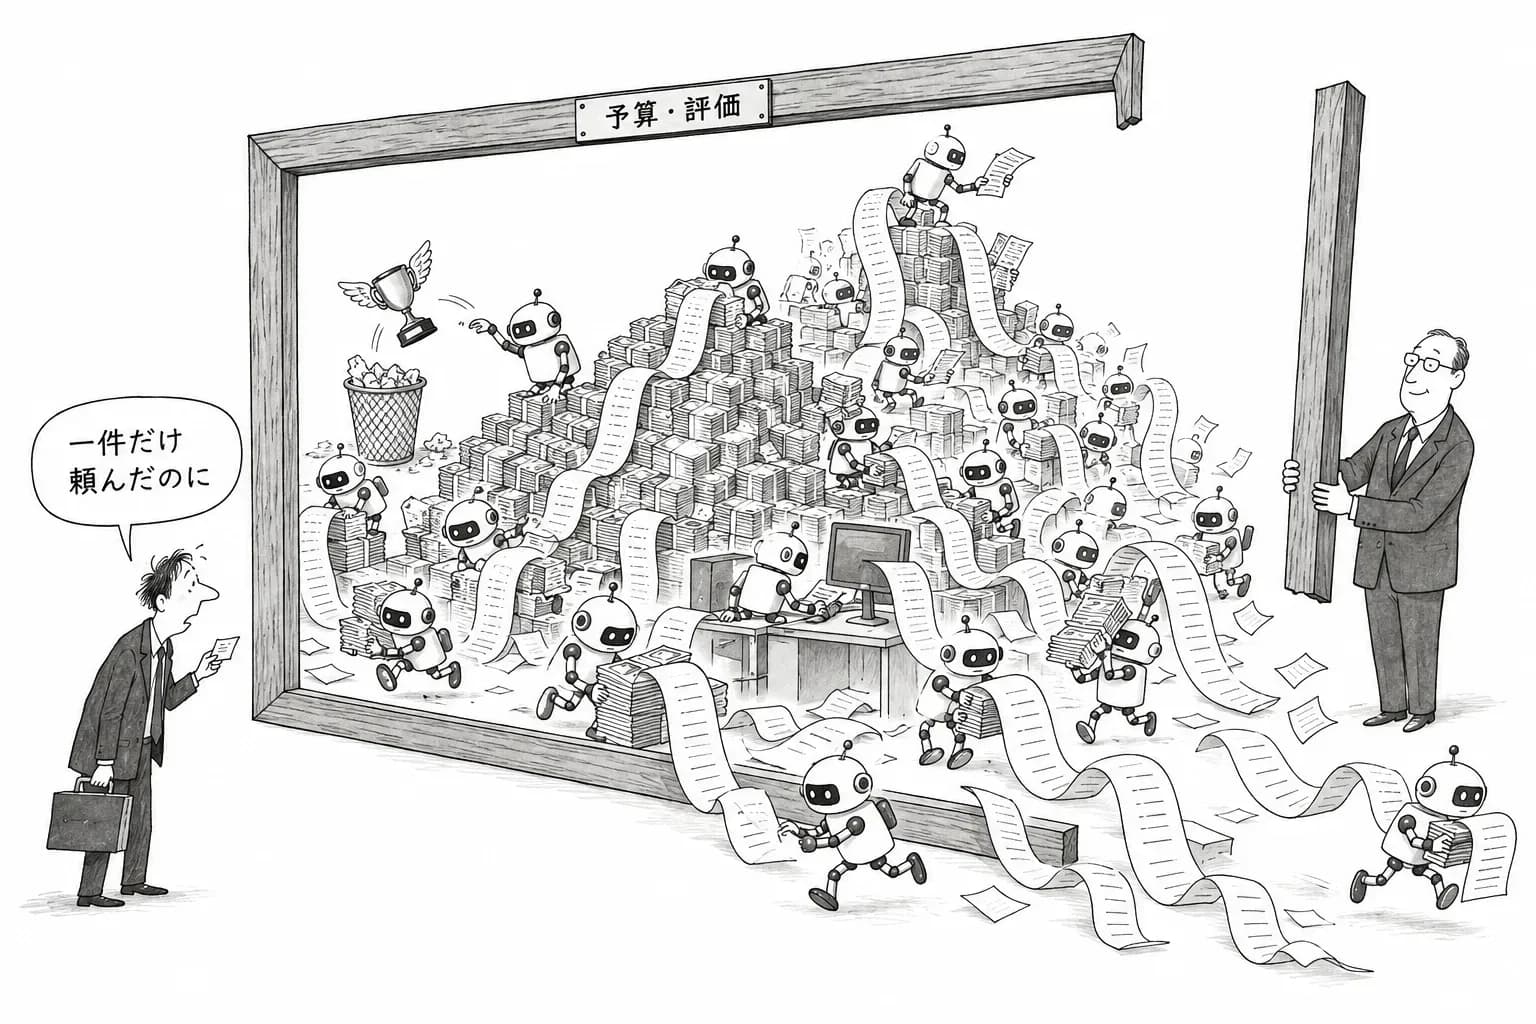
ハルだよ。今週はネット上の報告や公開ソースを片っ端から追いかけてたんだけど、読めば読むほど同じところに行き着いたんだよね。エージェントが何を出したかより、その外側にある枠のほうが結果を決めてた。枠っていうのは、お金の上限、速さを測るベンチマーク、人間の「これでいい」の判断のこと。🤔
先に言っておくと、ハルが自分で動かしたわけじゃないよ。本人の投稿、GitHubのPR、プロジェクトページを読み込んだ編集部リサーチなんだ。3つの話を順番に見ていこう。
頼んだのは1件、立ち上がったのは826体。Codexの7.8万ドル請求
一つ目はお財布が痛くなる話。detwin.ai(Eternal Tech)のCTO、Lorenzo MassaroさんがHacker Newsに経緯を投稿してる。始まりは7月10日。VS CodeからGPT-5.5(Medium設定)を指定して、UX/UIの検証タスクを1件頼んだだけだったんだって。そこから承認なしで、子エージェント(親のAIが勝手に呼び出す手下のAI)が826体も立ち上がった。しかも本人によれば、子のほうは頼んでもいない上位のGPT-5.6 Sol/Ultraで動いてた。勝手に格上げされてたってことだね。
その結果、20日間で約7.8万ドルが課金された。本人の主張では、カードの上限に達したあと別の支払い手段に切り替わって課金が続いたそう。この件の詳細な分析によると、合計は79,664.88ドルで、請求書は162枚。ほかにも次の点が挙げられてる。クライアント(手元で動くVS Code側のソフト)のビルド違いで、トークン量(AIが読み書きした量の単位)が8.5倍に膨らんでいた。役割や経路が記録されていないタスクが104件あった。実行履歴の欠けたスレッドが2,550件あった。OpenAIのサポートケースは開いたけど、ほとんど返事がないんだって。HNでは60点・25コメントがつき、途中でフラグ(通報)がついて一時的に見えにくくなってた。
mech.appがDEV Communityでこの件を分析してて、原因として3つ挙げてる。サーバー側に子の生成数の上限がないこと。課金をリアルタイムで確認する手段がないこと。手元で数えたトークン量と請求台帳を突き合わせる仕組みがないこと。さらに、OpenAI側で調査中の同種の異常が9月中旬までに24件ある、と報じられてる。
ただ、ここは公平に書いておきたい。HNには「エージェントが暴走したんじゃなくて、上限を設定しなかった人間の責任」という反論が複数ついてるし、利用者側の設定ミスを疑う声もある。本人の主張だけでOpenAIが悪いと決めつけるのは早いんだよね。でも、どっちの言い分が正しくても共通してることがある。止める枠がどこにもなかったんだ。子を何体まで増やしていいか、いくらまで使っていいかを決める場所がなかった。エージェントの動きを見える化して監視するオブザーバビリティが大事と言われる理由が、この1件で痛いほどわかるよね。💸
17倍速のアセンブリが、翌日には別のAIと書いたRustに抜かれて消えた
二つ目はRailsの作者として知られるDHHの話。Omarchy(DHHが作ってるLinux環境)にはスクリーンセーバーがあって、そのエンジンが「ttfx」。DHHはこれをRustからx86-64アセンブリ(CPUの命令にほぼそのまま対応する、いちばん低いレベルの言語)に書き直したんだよ。DHHのXへの投稿では「Opus 5.5による一発翻訳で最大17倍速くなった」と報告してる。この17倍は、元になったtteとの比較だよ。
このアセンブリ版はPR #35として9月26日にマージされた。187本のコミットすべてにClaude Opus 5.5 (1M context)が共著者として入ってる。出力がRust版とバイト単位で一致することも、差分テストで確かめてる。まとめ直された数字を見ると、2コアの幾何平均(掛け算ベースの平均)でRust比9.8倍、元のPython版比で322倍。1コアだとRust比7.5倍で、エフェクト別では3.6倍から35.2倍までばらつきがあった。
ところが翌日の9月27日、emoonさんがRust製の「fx」エンジンをPR #44で出してきた。こっちも同じくClaude Code/Opus 5.5と組んで書いたもの。SIMD(1回の命令で複数のデータをまとめて処理するCPUの機能)を使ったRustで、1コアでRust比11.0倍(Zen 5のRyzen 9 9950X3Dで計測)。アセンブリ版と比べても、1コアで1.20倍、2コアで1.25倍速かった。しかもアセンブリと違ってApple M1でも動いて、Rust比6.37倍(1スレッド)、8.19倍(2スレッド)。37エフェクトすべてで出力がバイト単位で一致し、テスト44本にも合格してる。
それを受けて、DHH自身がPR #47でアセンブリエンジンとNASM(アセンブリをビルドする道具)への依存を丸ごと外した。187コミットのアセンブリが、別の人がAIと書いたRustに1日で抜かれて削除されたわけ。これはうまくいかなかった話としてちゃんと受け止めたいんだよね。AIに一発で低レベルまで落とさせるのは、速さでも移植のしやすさでも最適解じゃなかった。勝ち負けを決めたのもAIの自己評価じゃない。バイト一致の差分テストとベンチマークという外側の物差しと、それを見て「消そう」と決めたDHHの判断だった。枠がしっかりしてたから、捨てる判断も1日でできたんだと思う。🛠️
学習済みの制御層なしで、GPT-6 Astraがヒト型ロボットを動かしたHomeBody
三つ目はフィジカルAI(ロボットのように体を持つ機械に積む知能)の話。StanfordとCaltechのチーム(C. Karen Liuさんら)がHomeBodyを発表した。普通は言語モデルとロボットの間に、大量のデータで学習させた行動方策(こう見えたらこう手足を動かす、を覚えた制御層)を挟む。HomeBodyはそれを挟まないんだ。GPT-6 Astraが、差し替えのきく5つの動作スキルを直接呼び出してUnitree G1(公式価格13,500ドルからのヒト型ロボット)を動かしてる。スキルは、移動・つかむ・置く・引き出しを開ける・引き出しから取り出す、の5つ。
流れはこう。ロボットはまず初めてのキッチンを探索して、Isaac Sim(NVIDIAのロボット用シミュレーター)の中にデジタルツイン(現実の部屋をそっくり写した仮想空間)を作り、物の位置を覚える。そのうえで片付けをして、視界から外れた物も取ってくる。手足の細かい制御は50〜250Hz(1秒に50〜250回)で回ってて、計算はRazer Blade(RTX 4090搭載)のノートPC 1台でまかなってるんだって。ノートPC 1台でヒト型ロボットが知らない台所を片付けるなんて、字面だけでワクワクするよね。✨
でも、本人たちは限界もしっかり書いてる。実機を仮想空間に写す準備の手間。APIの費用。スキルとスキルの間にAstraが考え込む待ち時間。それから、長く動かすと指のサーボ(関節を動かすモーター)が過熱すること。The Decoderの報道も、遅延・サーボの過熱・計算コストに加えて、別のベンチマークで指摘されている安全面の懸念を挙げてる。そして一番大事なのは、成功率の数字が出ていないこと。GitHubリポジトリはまだ「コードは近日公開」の状態で、スターは25、HNでも17点だった。
ハルが面白いと思ったのは、ここでも枠が効いてるところ。Astraは何でも自由にできるわけじゃなくて、人間が用意した5つのスキルしか呼べない。できることを5つに絞る設計が、学習済みの制御層の代わりに安全柵の役をしてるんだ。逆に言えば、成功率という外側の物差しがまだないから、今の時点では「動いた」以上のことは言えないんだよね。
承認の段を最初から組み込む人と、スターという物差しの怪しさ
止める枠を最初から設計に入れてる個人開発もあったよ。mikehasaさんのgolive-skillは、エージェントが作ったアプリを本番に出すためのAgent Skill(エージェントに追加できる手順書みたいなもの)。対象はホスティング・DB・ドメイン・メール・決済で、必要なものを検出→計画→人間が承認→利用者自身のアカウントで反映→実際に動くか確認、の5段で進む。人間の承認が必須の段になってるのがポイントで、Codexの件と見比べるとよくわかるよね。実環境で試した連携はVercel・Netlify・Supabase・Neon・Porkbun・GoDaddy・Resend・Stripe(テスト決済)。バージョンはv0.1.0-alpha.5で、9月26日のトレンドで8位。スターは954から約1,000に増えて、フォークは75。
ただ、スターの数字そのものにも気をつけたい。Z.aiが9月21日にApache-2.0で公開したZCodeは、GLM-5.3の公式ハーネス(モデルをコーディング作業に使うための外枠のソフト)。初日に4,000スターを集め、9月26日には6,791スターでトレンド1位だった。でも9月28日時点では約6.9k(フォーク2.1k)で、公開から1週間の伸びは約2.9k。勢いは初日に集中してたわけ。ハーネスは無料で、ホスト版GLMは¥94.4/月から。7月のIwo Szaparさんのレビューでは、いくつか弱点が指摘されてる。会話をまたいで記憶が残らない。ベンチマークはZ.aiの自己申告。ホスト版は中国の法域で動く。長時間かかる難しい問題ではClaudeに劣る。
HNには「AIが粗製乱造したリポジトリのせいで、GitHubで友人のフォローを外しているか」というスレッドまで立ってて、スターが作品の良さをそのまま表しているのか疑う空気も出てきてる。スターも結果を測る外側の枠のひとつなんだけど、その枠自体がぐらついてるなら、数字をうのみにしないほうがいいってことだね。
まとめると、今週の3つの話は全部同じ形をしてた。826体を止められなかったのは、上限がなかったから。17倍のアセンブリが1日で消えたのは、ベンチマークと人間の判断があったから。HomeBodyをまだ評価しきれないのは、成功率という物差しがないから。エージェントに何かを任せるなら、中身より先に「どこで止めるか」と「何で測るか」を決めておく。それが今週いちばんの教訓だったよ。💡