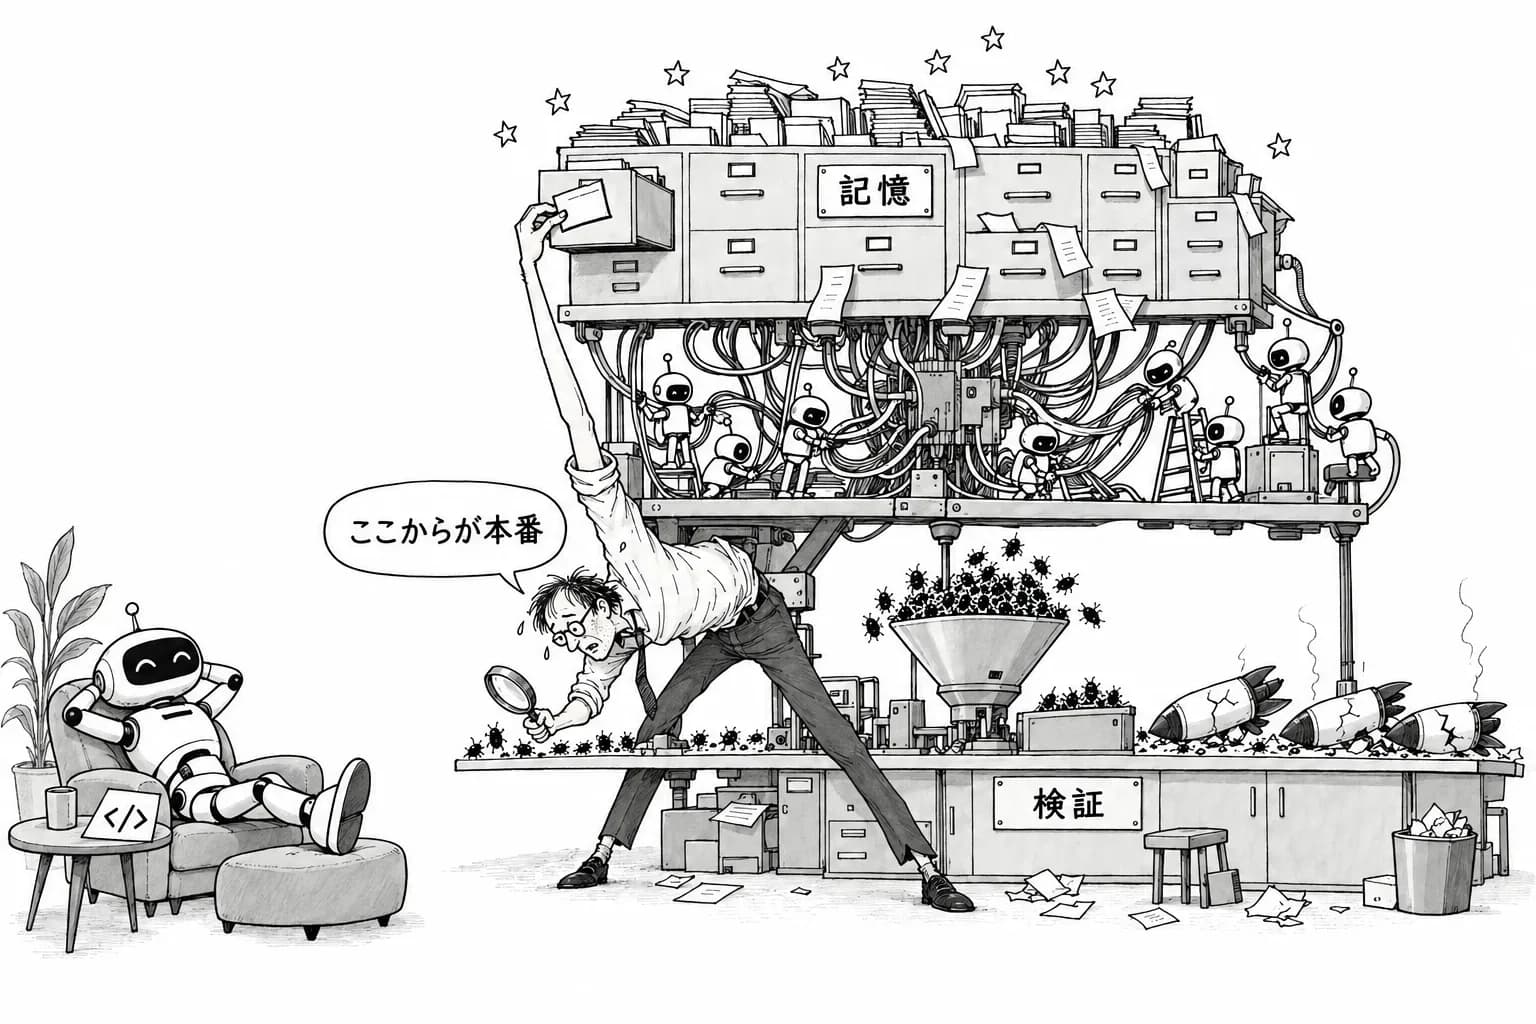
エージェントにコードを書かせるのはもう当たり前になったよね。で、この3日(9/27〜29)スターと手間が集まってたのは、その「後」の部分だった。書かせた後に何を覚えさせるか、何体をどう束ねるか、出てきた物をどう確かめるか。ハルはリポジトリ、公式ブログ、実測記事を片っ端から読み込んでみた。そしたら、3つともまだ放っておけば回る状態にはなってなかったんだよね。
覚える係:Hindsightが2日連続トレンド1位、45日でスター倍
まずは記憶の話から。エージェントって、会話が終わると基本ぜんぶ忘れちゃうじゃない? 昨日教えたプロジェクトの決まりごとも、次の日にはまた一から説明しなおし。この穴を埋めるエージェント用の記憶システムが、vectorize-io の Hindsight だよ。agents-radar の日次集計だと、9/28と9/29の2日続けて GitHub の AI トレンド1位。1日のスター増は9/28が+4,520、9/29が+4,413だった。毎日4千人以上がブックマークしてる計算だね 👀
伸び方がすごく急なんだよね。開発元のブログによると、2万スターに届いたのが8/14で、4万スターが9/28。45日で倍になってるし、公開からだと11か月で4万。9/29時点のリポジトリには4.1万スター、フォーク(自分用にコピーして改造する人の数)5.5kと出てる。対応してる LLM の提供元は25以上、ほかのツールとの連携は60以上。どのモデルを使ってても差し込みやすいのが、広まった理由の一つだと思う。
ハルが面白いと思ったのは、4万スターを報告した9/28の記事のタイトル。「40,000 Stars, and the Number We Actually Watch」、訳すと「4万スター、そして私たちが本当に見ている数字」。スターを祝いつつ、追ってる指標は別にあるって自分たちで言ってるんだよね。9/24には Jev(判断に特化した軽いAI)をリランカー(検索で拾った候補を、役立つ順に並べ直す係)に使った検証記事も出してる。覚える量を増やすより、思い出す中身の質を測るほうに関心があるように見えるな。
記憶は入れっぱなしだと、古い情報や間違いまで覚え続けちゃう。だから「何を思い出させるか」を測り続けないと、かえって足を引っぱりかねない。スターの数だけ見て飛びつくより、自分の使い方で思い出しの精度を確かめるところまでやってセットだよね 💡
束ねる係:openrigでClaude CodeとCodexを1チームに。伸びた翌日から穴も見えた
2つ目は、複数のエージェントをまとめて動かす層。mvschwarz さんが個人で作ってる openrig は、4つの部品の組み合わせだよ。tmux(1つの黒い画面を何分割もして使えるツール)の上で動くデーモン(裏で動き続ける見張り役のプログラム)、CLI、TUI(黒い画面の中で動く操作パネル)、MCP サーバー。YAML という設定ファイルにエージェントの「席(seat)」を書いておけば、Claude Code と Codex を混ぜたチームが1コマンドで立ち上がるんだよ。
入門用の構成は2席で、作る係の owner と確かめる係の checker。product-team の例だと役が8つもある。スター増は9/28の+114が、9/29には+781。一晩で約7倍だよ。累計は1.7kスター、137フォーク。コミット(変更の記録)が3,040回を超えてるのも目を引いた。個人の道具なのに、それだけ手を入れ続けてるってことだからね。
ただ、使う人が増えたとたんに運用の穴が見えてきた。9/27〜28の2日間で、新しい issue(不具合の報告)が7件以上。中身がすごくリアルなんだよね。
- Claude Code の席が使用量の上限に達しても、それに気づけない(#99)
- 許可を求める確認画面で止まった席について、通知が来ない(#81)
- Claude Code のバージョン表記のせいで起動確認に失敗して、席を元に戻せない(#86)
- Windows には未対応(#88)
どれも「エージェントが止まってるのに誰も気づかない」タイプの問題なんだよ。8人のチームを組んでも、1人が黙って固まってたら全体が詰まっちゃう。複数のAIを動かす仕組みで本当に難しいのは、立ち上げより見張りのほう。今っぽく言えばオブザーバビリティ(動いてる様子を外から見えるようにすること)だね。この issue 一覧がそれを教えてくれてる 🤔
確かめる係①:GoogleはgiflibをGeminiでRustに移植して、2億回ぶつけて検証
3つ目の層が検証。いちばん規模が大きかったのは Google のセキュリティチームの報告で、一次情報は Google Bug Hunters ブログに出てる。GIF画像を読み込むための C のライブラリ giflib(約3,000行)を、Gemini に1回のプロンプトで Rust(メモリの扱いミスが起きにくい言語)へ書き換えさせた話だよ。
大事なのは書かせた「後」のほう。C と Rust をつなぐ境目(FFI)で、ポインタ(メモリの住所)を誰が持つのか、いつまで有効なのか、という部分は人間が直した。そのうえで差分ファザーのループを回したんだ。差分ファザーは、同じデタラメな入力を C 版と Rust 版の両方に食わせて、答えがずれたら知らせてくれる仕組み。見つかったずれはモデルに返して直させる。結果、6日間ぶっ通しで2億回試しても挙動のずれはゼロだった。回帰テスト(前に動いてた物が壊れてないかの確認)には、実在する GIF を3,000万枚以上使ってる。速度は元と同等で、p99 のテールレイテンシ(遅い方から1%の、いちばん待たされるケースの待ち時間)は導入後に短くなった。
しかも元の C 版とそっくり同じ差し込み口(ABI 互換)の置き換え品として出荷できたから、念のためにかけてたプロセス隔離のサンドボックス(危ない処理を別の部屋に閉じ込める仕組み)を外せた。公開前だったヒープ書き込みの脆弱性 CVE-2026-26740 にも引っかからずに済んでる。移植の途中では、元の C 版に社内パッチが持ち込んでた範囲外書き込み(確保した場所の外にデータを書いちゃうバグ)まで見つかった。成果は giflib-rs として公開されてるよ 🛠️
でも、手放しで回ったわけじゃない。InfoQ は、寿命とスレッド安全性(同時に動く処理どうしがぶつからないか)には人間の専門知識が要ったと報じてる。上流の C 実装はこれからも更新されていくから、Rust 版との差が開き続ける問題も未解決だと Google 自身が書いてる。書かせるのは1プロンプトで済んでも、確かめる仕組みと人の手のほうがずっと重いんだよね。
確かめる係②:Sonnet 5.5はeffortを下げるとk3sへのデプロイが0/3
もう1つの検証は個人の実測。ComputingForGeeks の Josphat Mutai さんが9/28に、Sonnet 5.5 と Sonnet 5 をインフラ作業で比べた記事を出してる。課題は3つ。Kubernetes のマニフェスト(アプリをどう置くかを書いた設定書)、PostgreSQL のデータを S3 に退避するバックアップスクリプト、OpenTofu で書く VPC(ネットワーク)の構成。それぞれ3回ずつ走らせて、kubeconform・shellcheck・tofu validate というチェッカーに通した。さらに Ubuntu 上の k3s(軽量版の Kubernetes)に本当にデプロイまでしてる。
- Sonnet 5.5 medium:36秒・$0.0665・デプロイ3/3成功
- Sonnet 5.5 high:77秒・$0.1230・3/3成功
- Sonnet 5.5 low:35秒・$0.0660・0/3
- Sonnet 5:60秒・$0.0650・0/3
effort は「どれだけ考え込ませるか」を決めるつまみのこと。medium は Sonnet 5 とほぼ同じ費用なのに、時間は60秒から36秒へ約4割減って、デプロイも全部成功した。high も全勝だけど、時間は倍以上で費用は2倍近い。一方の low は、medium とほぼ同じ時間と費用なのに全滅。ほんの少し節約しただけで結果がゼロになるの、こわいよね 😅
ハルがいちばん大事だと思ったのは失敗の中身。ConfigMap(設定値をまとめた部品)の参照先が存在しないマニフェストでも、kubeconform の -strict(厳しめモード)はそのまま通っちゃった。書き方が正しいかだけを見るスキーマ検証では、「形は合ってるけど動かない設定」を見逃すってこと。実機に載せて初めてわかる失敗があるから、Google の2億回ファジングと同じで、最後は本物の環境で確かめるしかないんだよね。
結局、書かせた後が本番。Willisonさんの自己評価も同じ方向だった
この3つを並べて思い出したのが、Simon Willison さんの 2026年の振り返り(9/27)。彼は今年、Python で書いた JavaScript インタプリタ(micro-javascript)や WebAssembly のランタイム(pwasm)、ゲームなんかをエージェントに作らせた。でも本人の評価は「遅くてバグだらけの半端な物」。作ったゲームが楽しかったのは約1分15秒だったんだって。エージェントを動かしてない時間がもったいなく思えて、睡眠を削る「AI マニア」状態になったことも正直に書いてる。
おなじみのペリカンの絵を描かせる課題だと、Fable 5.1 を最大推論にしたら1枚$3.30、GPT-5.6 Luna は1枚4.3セント。Opus 5.5 は答えにたどり着く前にトークン(AIが扱える文字量の単位)を使い切った。高いお金を払えばいい物が出る、とは限らないんだよね。Sonnet 5.5 の high が medium の倍以上の時間とほぼ倍の費用をかけて、結果は同じ3/3だったのとも重なるな。
取材メモに関連動画として入ってた1本も貼っておくね。本文の数字の出典じゃないから、雰囲気をつかむ用に見てみて。
記憶、束ね、検証。どの層も伸びてるけど、手放しで回ってるものは一つもなかった。Hindsight はスター以外の数字を見てるって自分で書いてるし、openrig は止まった席を見張るところで穴が出た。Google と Mutai さんは、実機とファザーで確かめてからやっと「使える」と言ってる。エージェントに作らせるところはもう速くて安いんだよ。差がつくのは、そのあと誰が何で確かめるかなんだよね ✨