Mixture of Experts(MoE、混合専門家モデル)は、1991年の論文「Adaptive Mixture of Local Experts」を起源とし、入力ごとに一部の専門家サブネットワークのみを活性化することで、モデル容量を増やしながら計算コストを抑える手法として知られる。IBMの解説によれば、この発想は登場から約30年を経て、DeepSeek-V4やQwen3.5のような数百億〜数千億パラメータ級の大規模言語モデルで標準アーキテクチャとなった。the-decoderが報じるように、トークンごとに数個の専門家だけを呼び出す設計により、モデル全体を毎回計算する必要がなくなった。だが2026年に入り、研究の焦点は「モデルをどう大きくするか」から「専門家群をいかに効率よく動かすか」へと明確に移っている。

Appleが投機的プリフェッチと推論時アンサンブルを提案
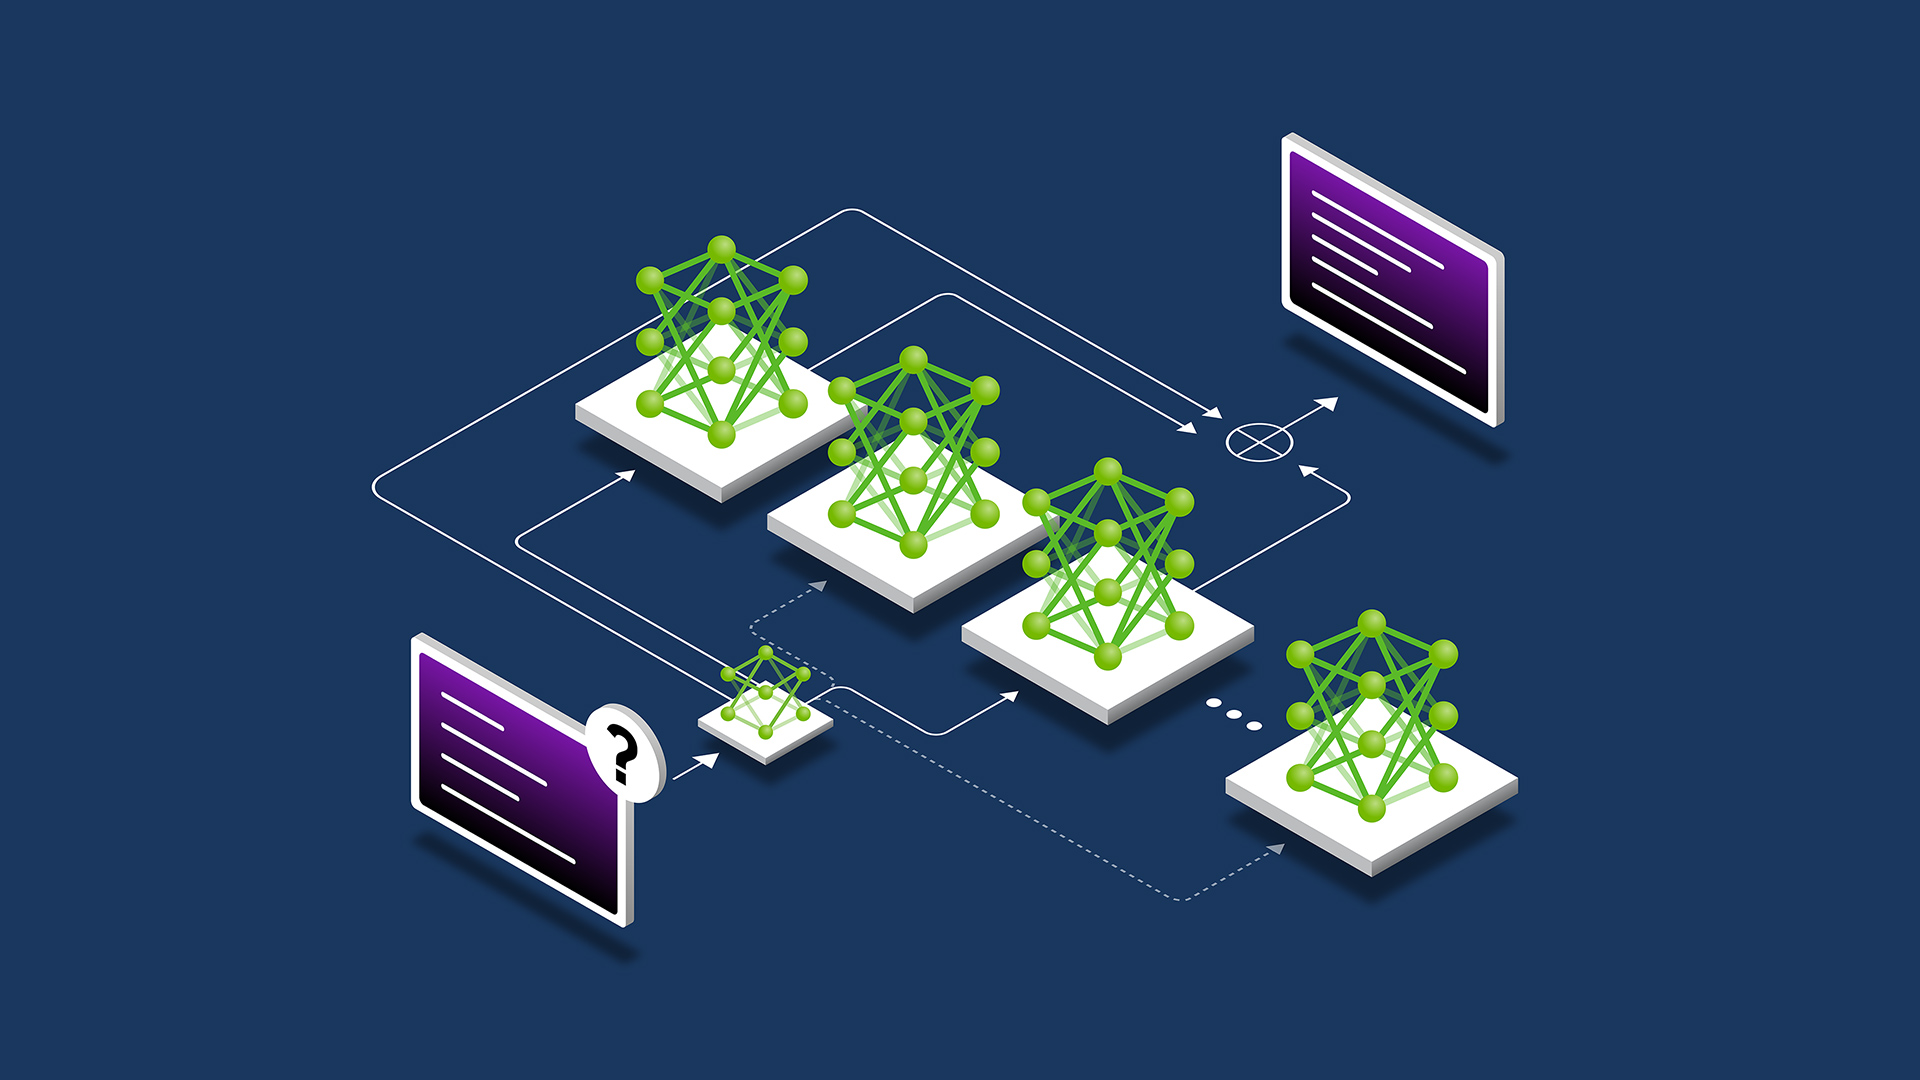
Appleの機械学習研究チームは2026年5月、SpecMDと題する研究を発表した。MoEはトークンごとに一部パラメータしか使わないスパース性が売りだが、実際の高速化には専門家をどうキャッシュするかが鍵になる。従来のハードウェア中心のキャッシュ方針は、異なるハードウェア構成との相互作用が十分検証されていなかった。SpecMDは複数のキャッシュ戦略を標準化されたフレームワーク上で徹底的にベンチマークし、既存手法を再現・拡張する形で、専門家の投機的プリフェッチが実際に性能改善につながることを示した。
さらにAppleはRoE(Roster of Experts)という手法も公開している。これはChain-of-Thoughtのような系列レベルの推論時スケーリングとは別に、トークンレベルで予測品質を高める「ハイパーパラレルスケーリング」の枠組みだ。ルーティング機構に制御されたランダム性を注入し、1つのトークンに対して複数の専門家からの出力をサンプリングして集約することで、単一のMoEを訓練なしで動的なMoEのアンサンブルに変換する。加えて2025年12月に公開された関連研究MoE-PHDSは、従来は固定のtop-kスパース性で運用されていたMoEを、精度とレイテンシの目標に応じてランタイムで柔軟に切り替えられるようにする発想を示しており、複数モデルの併存運用というコスト増の課題に対する解として位置づけられている。
専門家の12.5%だけでフル性能に近づく新学習法
the-decoderが報じた別の研究は、より根本的な問題に切り込む。標準的なMoEでは、専門家が前置詞や句読点、冠詞といった表層的な言語パターンに反応しがちで、数学やコードのような高次のドメインには結びつきにくい。そのため「数学だけ使いたいから一部の専門家だけロードする」という運用ができず、推論時には結局モデル全体をメモリに載せる必要があった。今回の研究では文書境界を学習信号として利用する新手法により、専門家全体のわずか12.5%だけを使ってもフル性能に近い結果を達成したという。これはメモリ制約下でのMoE運用における大きな前進であり、エッジデバイスや低スペックGPUでの大規模モデル運用の可能性を広げるものだ。
中国勢の動向:計算量削減と通信最適化が競争軸に
中国の通信専門メディアC114の分析によれば、2024年1〜5月だけで発表された1000億パラメータ以上の大規模モデルは、そのほとんどがMoE最適化アーキテクチャを採用し、その数は過去3年間の合計を上回った。C114の報告では、MoEと指令調整を組み合わせることで、計算量を約3分の1に抑えつつ性能を約45%向上させられるという研究結果が紹介されている。DeepSeekMoEは共有専門家や細粒度の専門家分割といった手法を用い、145Bパラメータの構成でありながら約28.5%の計算量でDeepSeek 67B相当の性能を達成したと報告されている。
通信コストの削減も重要な研究軸だ。ScMoEという通信オーバーラップ並列戦略は、分散MoE環境における通信操作の依存関係を解消し、訓練速度を11%、推論速度を15%向上させ、通信時間を8基のA800-NVLink構成における標準MoEの15%程度にまで圧縮したという。Google、OpenAI、アリババ、テンセントといった企業がコスト抑制と性能向上の両立、さらには価格競争への対応策として、こぞってMoE最適化に取り組んでいる背景がここにある。
専門家の「専門性」は本当に機能しているか
NVIDIAの技術解説によれば、Mixtral 8x7Bを用いた実験では、負荷分散アルゴリズムを適用しているにもかかわらず、特定の専門家が特定のトピックに対して偏って活性化される傾向が観測されている。つまり専門家の「専門化」は経験的に一定程度起きているが、完全に制御されたものではない。NVIDIAはさらに、SwitchHeadと呼ばれる研究がMoEの概念をアテンション機構のQ・K・V射影層にまで拡張できることを示したと紹介しており、MoEの適用範囲がフィードフォワード層に留まらず、トランスフォーマー全体に広がりつつあることを示唆している。ルーティングアルゴリズムについても、単純な均一選択から、Expert Choice Routingのような複雑な手法まで多様化が進んでいる。
今後の実務的な焦点
これらの研究群を総合すると、MoEはもはや「パラメータ数を増やしても計算コストを抑える」という当初のメリットだけでなく、推論時のメモリフットプリント、キャッシュ効率、ランタイムでのスパース性可変化、専門家の可搬性といった、実運用に直結する課題へと研究の重心が移っている。企業がMoEベースのモデルを自前運用する場合、Apple型のキャッシュ最適化やハイパーパラレル推論、あるいは12.5%圧縮のような手法を組み合わせることで、ハードウェア投資を抑えつつ性能を維持できる可能性がある。今後数四半期は、こうした「動かし方」の研究成果が製品レベルの推論エンジンに実装されるかどうかが、MoE活用の競争優位を左右する分水嶺になりそうだ。
