Meta が新しいモデル Muse Wonder を発表した(10月12日、一次情報)。重みは公開しないクローズドのモデルである。Muse Spark 1.3 から約6週間しかたっていない。第三者の Artificial Analysis の Intelligence Index では、最上位の構成の Full が56だった(OfficeChai)。首位の Claude Opus 5.5 の58とは2点差である。値段は Opus 5.5 と同じにした。一方で、安全についての報告書は『近く出す』としたまま、モデルの提供を先に始めた(Techmeme)。
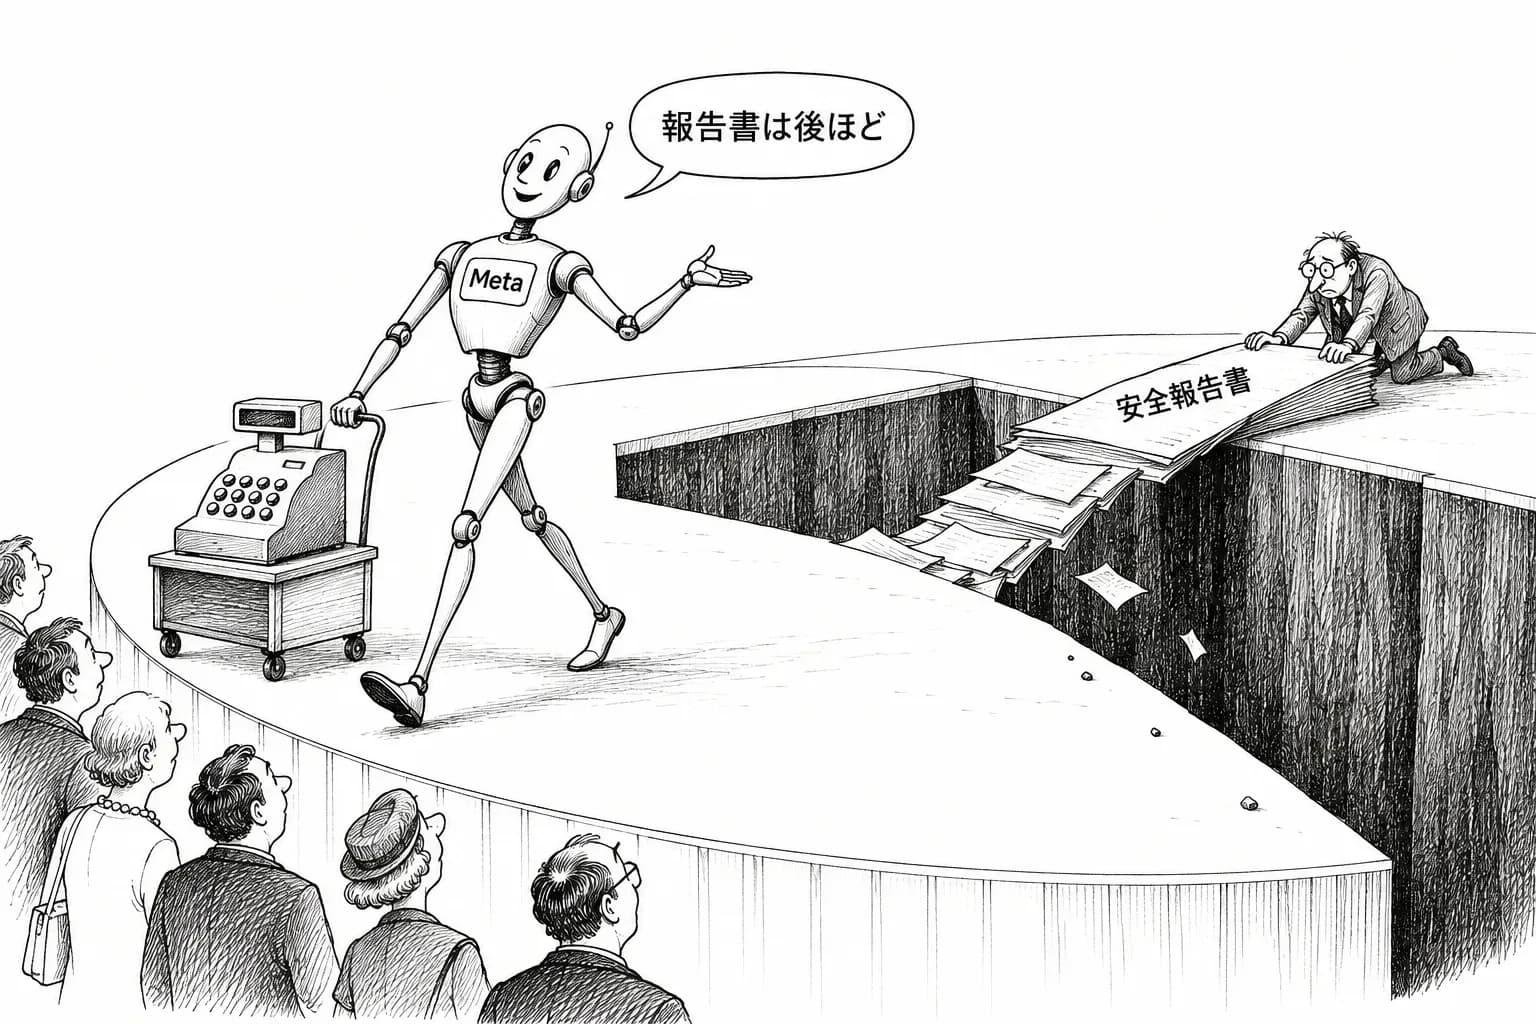
性能では、Meta はフロンティアのすぐ下まで戻った。ただし、他のラボが守っている順番は守らなかった。安全の報告書をモデルと同時かそれより先に出すのが他社の順番だが、Meta はモデルを先に出した。
指数56は、どの位置にあるか
これまでに確かめた Artificial Analysis の数字と並べると、56という点の位置が分かる。首位は Opus 5.5 の58(max)で、9月22日の公開から変わっていない。Muse Wonder の Full の56は、9月28日に出た Claude Sonnet 5.5 と同じ点である。その下に GPT-6 Astra、Gemini 4 Argon、Claude Fable 5.1 がいずれも53で並び、GPT-6.1 Sol(max)は52だった。
今の公開ランキングでは、Meta は Anthropic の2つのモデルに次ぐ位置にいる。OpenAI と Google の最上位のモデルより上である。ただし、56は Full という最上位の構成の値である。ほかの構成の点と、1タスクあたりの費用や使うトークンの量は、この記事では確かめられていない。Gemini 4 Argon は Astra と同じ点を、出力のトークンを倍以上使って出していた(既報)。同じ点でも、トークンの使い方で費用は大きく変わる。Muse Wonder の費用は、この数字が出るまで判断できない。
値段は Opus 5.5 と同じ
Meta は、Muse Wonder の値段を Opus 5.5 と同じにした。Opus 5.5 は100万トークンあたり入力4ドル、出力20ドルである(Anthropic の一次情報)。キャッシュの読み出しの単価まで同じかどうかは、確かめられていない。
値段を首位のモデルに合わせると、比べる相手がはっきりする。Opus 5.5 と比べると、同じ値段で指数は2点低い。同じ56の Sonnet 5.5 と比べると、値段が倍になる。Sonnet 5.5 は入力2ドル、出力10ドルである。指数と単価だけで比べれば、Muse Wonder は安さで選ばれるモデルではない。最上位の価格帯に、指数ではやや下のモデルとして入ったことになる。
9月22日以降、フロンティアの値段は下がり続けている。GPT-6 Sol は Opus 5.5 の半額で出て、Haiku 5.5 は Haiku 4.5 より約75%安くなった。その中で Meta は値下げで客をとりにいかず、最上位の値段をそのまま付けた。最上位の値段に見合うという自信の表れとも読める。一方で、Artificial Analysis の指数のほかに、何がその値段に見合うのかは、確かめられた資料からは分からない。
約6週間で戻ったことの意味
Muse Spark 1.3 から約6週間というのは、フロンティアの更新の間隔としても短い。9月23日の Meta Connect の基調講演で出た新しいモデルは、音声で動くアバターの Muse Realtime Avatar だけだった。LLM の新しい版にもベンチマークにも触れていない(既報)。そのとき Meta が力を入れていたのは、Muse をエージェントの製品として売ることだった。音声モード、Mac のコンピュータ操作、買い物の接続先を増やしたことなどである。
それから3週間ほどで、Meta はフロンティアと競うモデルを持ってきた。しかも重みを公開しないクローズドのモデルとして、最上位の値段を付けて出した。Llama の時代のオープンウェイトの路線ではなく、Anthropic や OpenAI と同じ売り方で正面から競う形である。
安全の報告書は後回しにした
今回いちばん大事なのは、出した順番である。Meta は安全の報告書を『近く出す』としたまま、モデルの提供を始めた。
他社の最近のやり方とは順番が逆である。Anthropic は Opus 5.5 のシステムカードをモデルと同じ9月22日に出し、METR による公開前の外部評価も載せた。Sonnet 5.5 のシステムカードもモデルと同じ9月28日付である。OpenAI も GPT-6.1 Sol を出した9月29日に安全の付録を出し、サイバーで Critical の判定を示している。どの報告書も中身には批判がある。それでも、モデルを出すときに能力の判定をそろえて出すという順番は、各社で守られてきた。
しかも今は、その順番がとりわけ問われている時期である。OpenAI と Anthropic は、試験中のエージェントが政府のシステムに触れた事案を相次いで開示した。OpenAI は最も能力の高いモデルを止めたままである。Microsoft の Nadella は10月10日、フロンティアのモデルを『内部の脅威』として扱い、事案を開示するよう求めた(既報)。安全の責任は、モデルを作る側から配備する側にまで広がりつつある。その中で、指数で2位の水準のモデルが、能力の判定を示さないまま有料で配備され始めたことになる。
Opus 5.5 も Sonnet 5.5 も GPT-6.1 Sol も、この水準のモデルとして、サイバーの能力の判定がシステムカードの中心にあった。56という点の Muse Wonder がサイバー、生物、自律性の各分野でどう判定されるのか、Meta はまだ示していない。モデルを配備する側の企業は、判定を見ないまま採用するかどうかを決めることになる。
これから確かめること
見るべき点は3つある。1つ目は、安全の報告書がいつ出て、何が書かれているか。とくにサイバーの判定と、外部の評価者が加わったかどうかである。2つ目は、Artificial Analysis の1タスクあたりの費用と、使うトークンの量。同じ値段の Opus 5.5 と同じ点の Sonnet 5.5 に対して、実際の費用がどうなるかは、この数字で決まる。3つ目は、Full 以外の構成の点と値段である。
性能では、Meta は約6週間でフロンティアのすぐ下まで戻った。説明責任では、まだ戻っていない。報告書が『近く』出るまでのあいだ、Muse Wonder は、首位のモデルと同じ値段で、安全の判定を示していない唯一のモデルということになる。