NIIが「LLM-jp-4」をオープンソース公開
国立情報学研究所(NII、黒橋禎夫所長)の大規模言語モデル研究開発センター(LLMC)は、日本発プロジェクト「LLM-jp」を通じて開発した大規模言語モデル「LLM-jp-4 8Bモデル」と「LLM-jp-4 32B-A3Bモデル」をオープンソースライセンスで一般公開した。電波タイムズによれば、8Bモデルは約86億パラメータ、32B-A3Bモデルは約320億パラメータを持つ。後者は複数のサブモデルを組み合わせるMixture of Experts(MoE)構成を採用し、AI内部に配置した128人の「専門家」のうち質問内容に応じて最適な8人だけを呼び出す仕組みで、全回路を稼働させずに高い知能と処理効率を両立させたという。
日本語MT-BenchでGPT-4o・Qwen3-8Bを上回る
対話能力を測る「日本語MT-Bench」において、32B-A3Bモデルは7.82というスコアを記録した。これは世界中で利用される多言語モデル「GPT-4o」の7.29、アリババ社の「Qwen3-8B」の7.14を明確に上回る結果だ。ITmedia AI+の報道では、OpenAIのオープンモデル「gpt-oss-20b」の日本語性能も上回るとしており、英語性能についても海外モデルと同等以上をアピールしている。両モデルはLlama系やQwen系のアーキテクチャ設計を参考にしつつ、フルスクラッチで学習されたことが後日の訂正で明記された点も注目される。
19.5兆トークンの学習データと合成データの活用
事前学習では前作「LLM-jp-3」シリーズの約6倍にあたる学習コーパスを構築した。総計約19.5兆トークンの内訳は日本語約7000億トークン、英語約17.8兆トークン、中国語・韓国語など他言語約8500億トークン、プログラムコード約2000億トークンで、このうち約10.5兆トークンを事前学習に投入した。データにはインターネット公開情報に加え、国立国会図書館のデジタル資料や政府の公文書、AIが論理的思考を学ぶために生成した合成データも含まれる。中間学習では指示事前学習データを加えた計1.2兆トークンを使用し、最終的に英語・日本語のインストラクションチューニングデータ22種類でチューニングを実施した。Ledge.aiもこの学習規模とフルスクラッチ開発を強調して報じている。
「AI主権」を掲げる透明性重視の思想
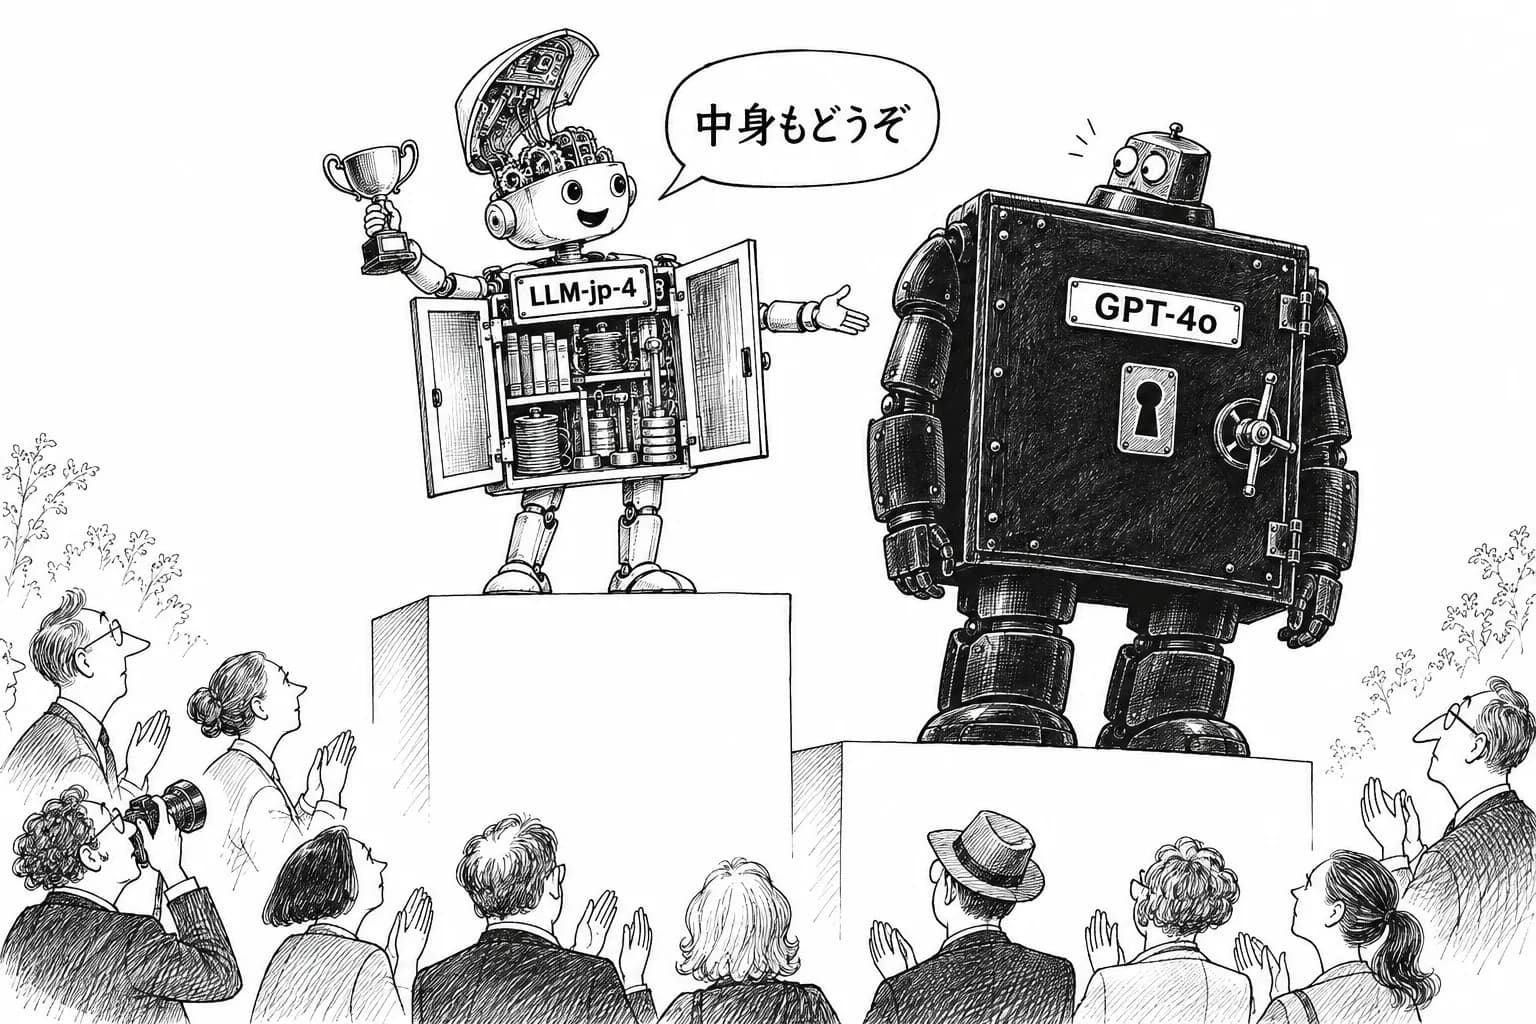
NIIの黒橋禎夫所長は4月16日の記者懇親会で、プロジェクトの根幹に「透明性」と「信頼性」があると強調した。多くの商用AIが学習データや作成手順を非公開とする中、LLM-jp-4は学習の「レシピ」やデータの来歴、モデルの重みまで全てオープンソースとして公開し、誰もが検証可能な「日本のAIの土台」を目指すとした。国産にこだわる理由については「海外のAIに頼り切ることは、自国のデータや文化のコントロールを他国に委ねるリスクを伴う」「特定の企業が開発を止めたり方針を変えたりするリスクを回避するために、日本独自の検証可能なモデルが必要」と「AI主権(データ主権)」の観点から説明した。数学やコードの学習を重視した理由についても、論理的思考力の訓練が他の言語処理能力全体を底上げすると述べている。
医療・教育への応用と今後の展開
活用事例としては、LLM-jpのモデルに約800億トークンの医学テキストを追加学習させた医療特化型モデルが、医師国家試験でGPT-4を上回る成績を収めたことが紹介された。教育分野でも、生徒の理解度に応じて答えを即座に教えず一緒に考えるエージェントの開発が始まっているという。今後の展望としては、2026年度中により大規模な32Bモデルと、3000億規模のパラメータを持つ超巨大MoEモデルの公開を予定しており、産官学2600名以上が参加する「チーム・サイエンス」体制での開発継続を掲げている。
オープンソースLLM市場の地殻変動
国産モデルの公開は、世界的なオープンソースLLM競争が激化する局面と重なる。Digital Todayの報道では、OpenAIやAnthropicが新モデルを相次ぎ投入し、Metaもオープンウェイト系LLMを更新する中、NVIDIAはHugging Faceを129億ドルで買収する方針を明らかにしたと伝えている。クローズドな巨大モデルとオープンな開発コミュニティの双方が主導権を争う構図の中で、学習データや重みを全面公開するLLM-jp-4のアプローチは、企業のベンダー依存リスク回避や規制対応の観点から今後の選定基準の一つになり得る。