DeepSeekが10月17日、V4.1-Flashの更新版「DeepSeek-V4.1-Flash-1017」の重みを、MITライセンスでHugging Faceに公開した。APIの更新履歴によれば、価格は変えていない。新しい世代のモデルではなく、同じ型番に日付を付けた小さな更新である。それでもDeepSeekは、コーディングエージェントのベンチマークTerminal-Benchの点が31から42に上がったと自己申告している。同じ日には、エージェント向けの検索と取得のAPIも売り出した。重みを配るラボだったDeepSeekが、エージェントの土台を売る側にも踏み出したことになる。数字はすべてDeepSeek自身のもので、第三者の評価はまだない。
何を出したか――値段は同じで、重みはMIT
V4.1-FlashはHugging Faceに9月10日から置かれてきた。10月12日に一度更新されたが、新しい版の名前は付いていなかった。APIの更新履歴も9月10日から止まっていた。今回の1017は、その両方を約5週間ぶりに動かした更新になる。
ライセンスはMITである。前の週に重みを出したほかのモデルと比べると、MetaのMuse Spark Openには独自のMuse Model Licenseが付く。12か月の売上が2,000万ドルを超える事業者がサービスとして提供するには、Metaと別の契約が要る。StepFunのStep 5 Previewも、表示義務と商用の条件が付いた独自ライセンスである。MITなら、受け取った企業が手を入れて自社のサービスに組み込むのに、ほぼ何の制約もない。
価格を変えなかったことも、使う側から見ると重い。V4.1-Flashは、OpenRouterの9月中旬の週次集計で15.8兆トークンを処理して首位だった(報道ベース)。Terence Taoが紹介した学者向けの場「SAIR Open Math OS」でも、使えるオープンモデルの1つに入っている。これだけ使われているモデルが、同じ値段のまま、エージェントの作業で強くなったと申告されたことになる。
数字をどう読むか――31→42は自己申告で、比べられる相手がまだない
DeepSeekが示した主な数字は、Terminal-Benchが31から42への改善である。MarkTechPostは、DeepSWEが77.0だったと伝えている(二次情報)。重みも価格も変えないまま、Agentic RLの事後訓練だけで、コーディングエージェントの点を3割以上上げたと読める。
ただし、割り引いて読むべき点が3つある。
1つ目は、点がどれもDeepSeek自身の測定であることだ。Artificial Analysisは、元のV4.1-FlashのIntelligence Indexを39としていた。1017にはまだ点を付けていない。Epoch、LMArena、Vals AIの評価も出ていない。前の週には、Haiku 5.5のTerminal-Bench 4.0で、Anthropicの申告が39.2%、Artificial Analysisの測定が33%と食い違った例があった。自己申告と第三者の測定は、同じベンチマークでも揃わないことがある。
2つ目は、Terminal-Benchにいくつもの版があることだ。Reflection AIのBeamはTerminal-Bench 2.1で80.1%、Muse Spark Openは76.4と申告した。一方、Artificial AnalysisのTerminal-Bench 4.0では、Beamは3.0%だった。版と採点の仕組みが違えば、数字はまったく別物になる。42という数字を、ほかのモデルの数字と並べて順位を付けるのは、まだ早い。
3つ目は、点を何のハーネスで測ったかである。DeepSeekは自前のコーディングエージェントのハーネス「deepseek-harness」を、ほぼ毎日のように更新している。10月14日のv0.2.1-alpha.3に続き、16日にはv0.2.1-alpha.5を出した。ARC Prizeは、Gemini 4 Argonの点が、Google自身のアダプタと標準のハーネスで2倍近く違うと示したばかりである。モデルの改善とハーネスの改善を切り分けられるかどうかは、第三者が標準の条件で測るまで分からない。
本当の新しさはSearch API――エージェントが毎回呼ぶ部分を売る
モデルの更新以上に、DeepSeekの位置を変えるのは検索のAPIである。エージェントは推論、行動、観察をくり返す(Loop engineering)。そのたびに、ウェブを検索し、ページを取得して読む。検索と取得は、Long Horizonタスクの中で最も回数の多い道具呼び出しの1つである。DeepSeekはこの部分を、自社の窓口から売り始めた。AI Weeklyの見出しは価格を0.75ドルとしているが、何あたりの値段かは確かめられていない(二次情報)。
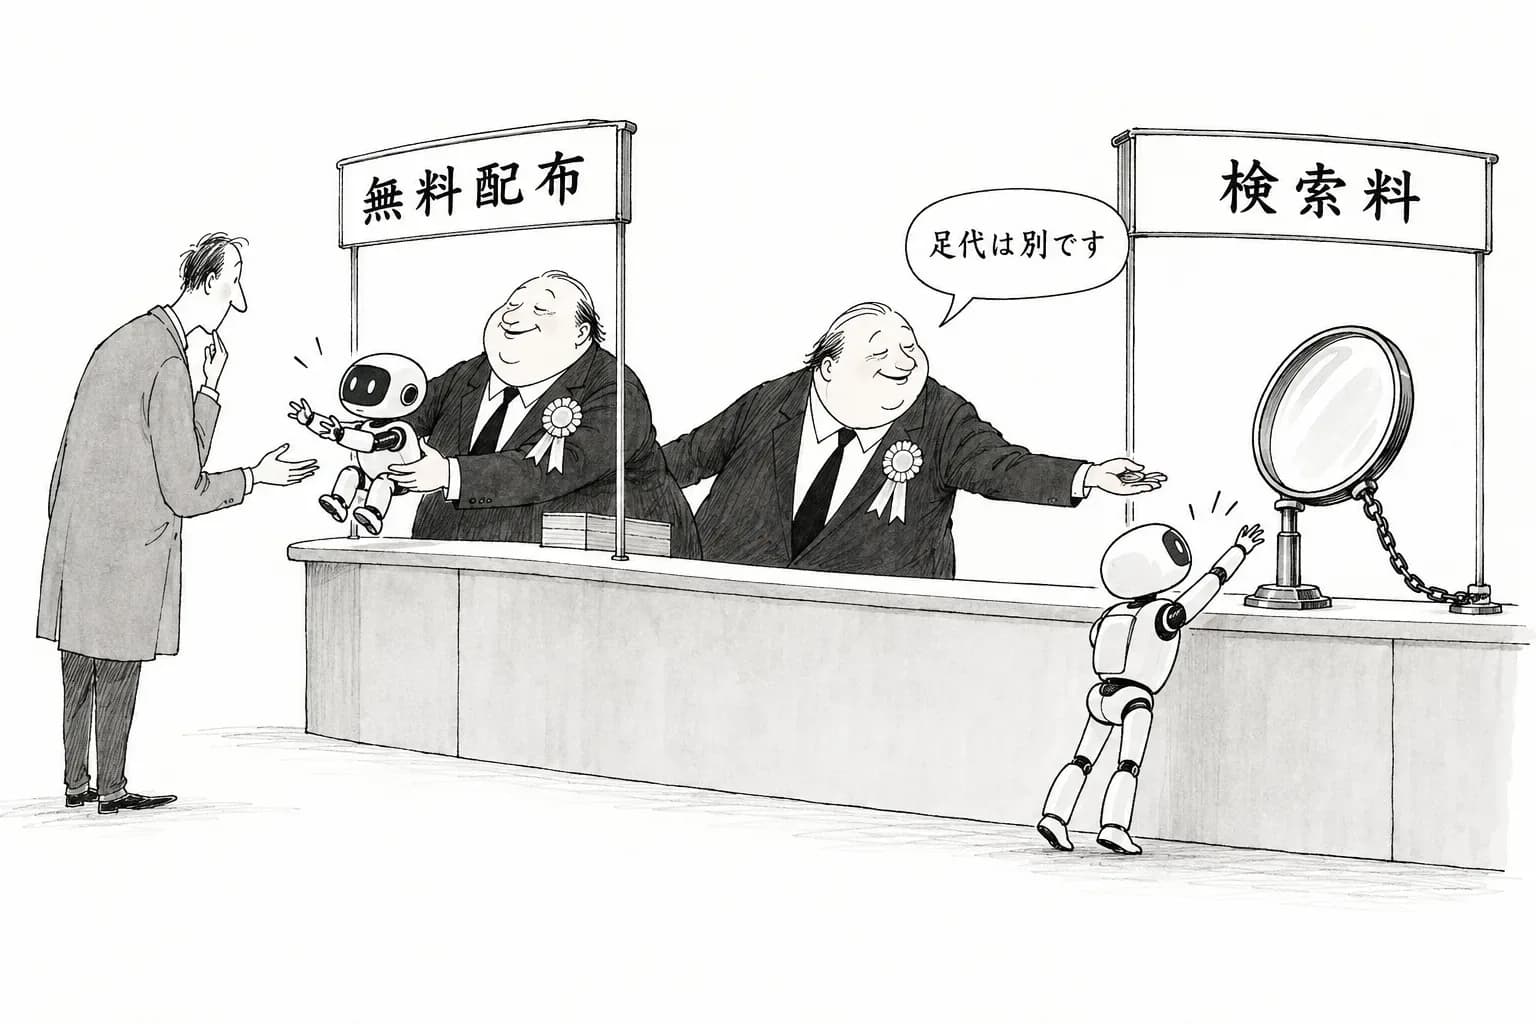
ここでモデルと基盤の関係が逆になる。重みはMITで誰にでも配る。そのうえで、ハーネスを無料で出し、エージェントが動くたびに呼ぶ検索をお金に換える。DeepSeekはこれまでも、DeepGEMM、DeepEP、TileKernels、Ascend向けのカーネルなど、推論と訓練の下の層を公開してきた。9月には、1日約300万のサンドボックスを回すAgentic RLの基盤DSecの論文も出している。今回の検索APIは、その内側の道具を、初めて外の開発者に商品として売るものになる。
同じ層を狙う競争もある。OpenAIのAgents API、Anthropicのウェブ検索と取得の道具、PerplexityのSPACEなど、米国のラボと周辺の企業は、モデルにサンドボックスや検索を組み合わせて売っている。中国勢でも、Qwen、StepFun、Z.ai、Moonshotが9月にハーネスを相次いで公開した。重みはどこも出せる段階に入り、差を付ける場所は、エージェントがどの基盤の上で動くかへ移りつつある。DeepSeekの検索APIは、中国のオープンウェイトのラボがこの層にお金の取り方を付けた、最初のはっきりした例である。
まだ分からないこと
第三者の評価がない。Artificial Analysis、Epoch、ARC Prize、LMArenaが1017に点を付けるまで、31→42が標準の条件で再現できるかは分からない。
検索APIの中身も細かく分からない。何あたり0.75ドルなのか、どの検索の索引を使うのか、取得したページをどこで処理し、どれくらいの期間保存するのか。これらは、海外の企業が使うかどうかを決める条件になる。Anthropicは10月12日に、思考の記録を抜き取って蒸留する攻撃への対策を強め、Zhipuなど中国のラボを名指しした。米中のあいだでデータの流れを見る目は厳しくなっている。エージェントが何を検索したかの記録を中国の窓口に送る仕組みは、性能や値段とは別の理由で、採用を左右しうる。
V4.1 Proも、まだ出ていない。中国メディアは9月末に一部のアカウントでの試験を伝え、10月下旬〜11月の公開を予想する声もあるが、確かめられた事実はない。今回のDeepSeekは、上位のモデルではなく、Flashの小さな更新と検索の窓口を同じ日に出した。重みを無料で配りながら、エージェントの基盤で稼ぐ形を、まず手頃な価格帯で試し始めたと見るのが妥当である。