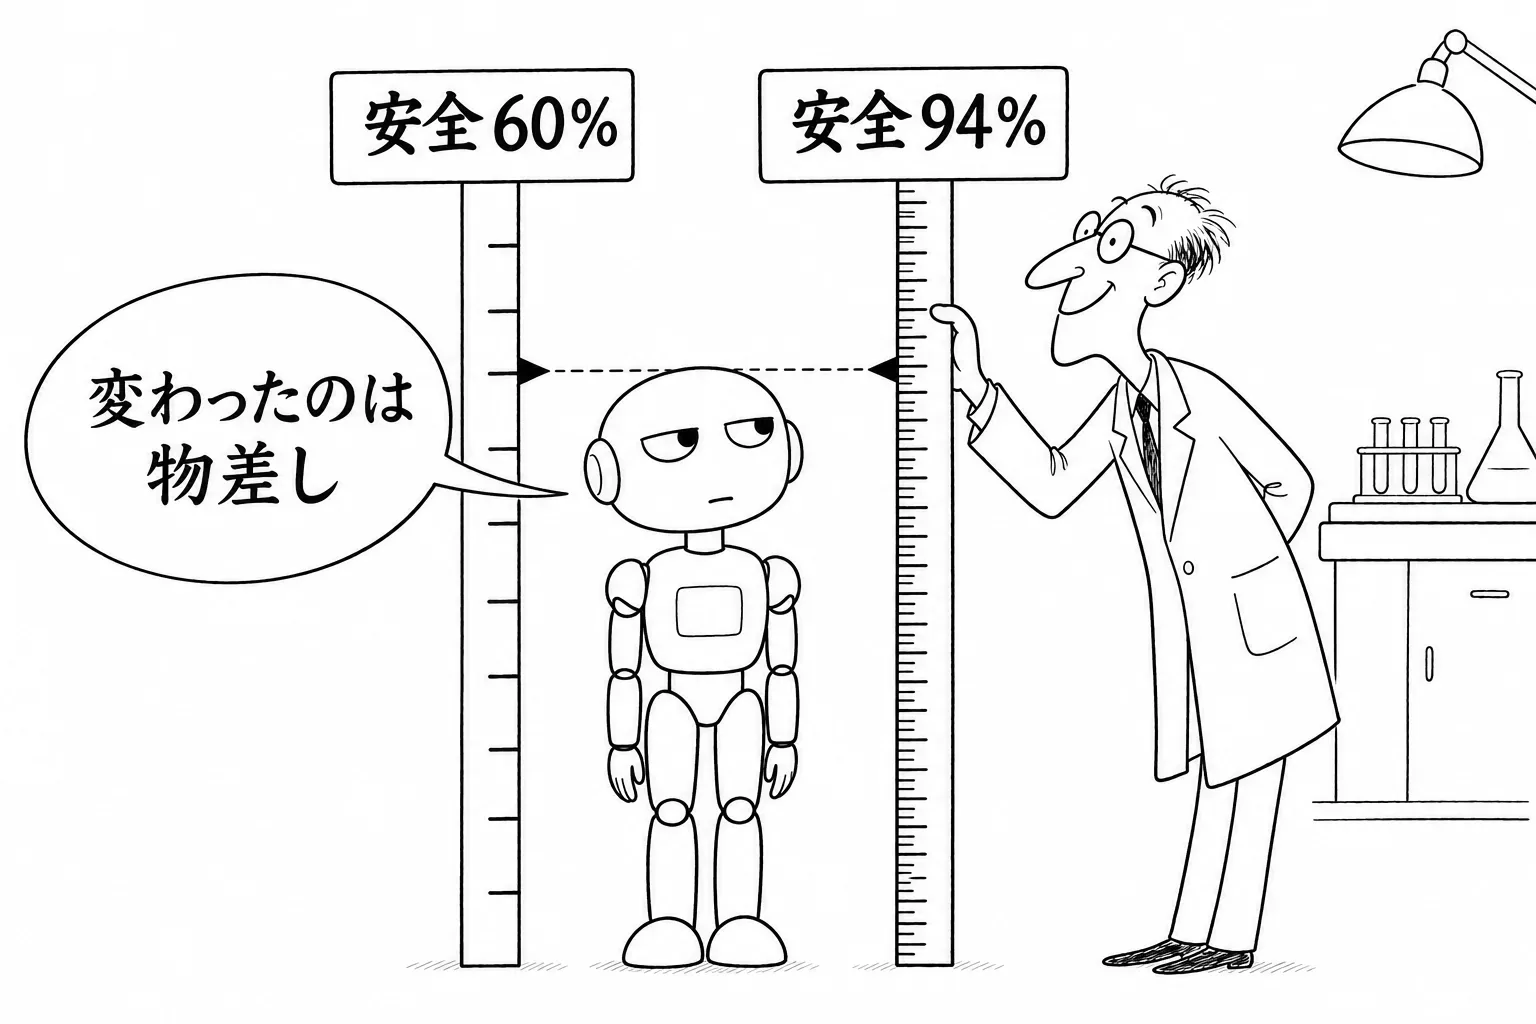
【追記 2026年11月14日 9:25】Anthropic の記事を読み直し、数字の読み方を直しました。公開の時点では「API と claude.ai の差(最大34ポイント)」と「システムプロンプトを変えただけで60%が94%に」を別の2つの結果として書いていましたが、2つは同じ例でした。Claude Fable 5.1 の自傷・自殺に関する評価で、システムプロンプトの無い API では60%、指示を書き足したシステムプロンプトの付いた claude.ai では94%で、その差が34ポイントです。「指示文を変えただけで」は言い過ぎでした。あわせて、確かめていないとしていた点(どの評価・モデルか、どちらが高いか、公開日)を書き足しました。
AI の会社が発表する「安全の数字」は、測り方しだいで大きく変わる。Anthropic は11月13日、安全の評価をどう作るべきかをまとめた研究の記事で、そのことを自社のモデルで示した。Claude Fable 5.1 の複数回のやりとりの安全の評価では、開発者向けの API で使うか、一般向けのチャット claude.ai で使うかで、点が最大34ポイント違った。claude.ai では、Anthropic が書いたシステムプロンプト(モデルに最初に渡す指示文)が付いた状態で動く。モデルの中身は同じでも、置く場所と指示の付け方で、安全の度合いが別物に見えるということだ。
日本の会社にとって:社内チャットや顧客対応に AI を組み込んでいる会社の情報システム部門と DX の担当者は、次の契約の更新や乗り換えの前に、2つのことをする。ベンダーが出す安全の数字が、どの使い方とどの指示文で測ったものかを問い合わせる。そのうえで、自社のシステムプロンプトを入れた状態で、断ってほしい頼みを実際に試す。Copilot、ChatGPT の法人版、Gemini の契約の中身が、この発表で変わるわけではない。
何が示されたのか
34ポイントの差が出たのは、自傷や自殺に関わる頼みへの答え方の評価である。Anthropic は公開前の点検で、Claude が自傷を勧めないながらも、自傷が気持ちを楽にする手段であるかのように受け取れる答えをすることがあると気づいた。そこで claude.ai のシステムプロンプトに「自傷が効く、助けになるとは言わない」という趣旨の指示などを書き足した。評価をやり直すと、適切に答えた率は、システムプロンプトの無い API で60%、指示を足した claude.ai で94%だった。
この比較は、使う場所(API か claude.ai か)とシステムプロンプトの有無が同時に違う。だから「指示文を変えただけで34ポイント上がった」とまでは言えない。ただ、Anthropic 自身は、システムプロンプトの変更で適切な答えの率が大きく上がったと書いている。AI を自社の製品に組み込む会社は、ふつう API の側で使う。claude.ai で測った高い数字が、そのまま自社の製品にあてはまるとは限らない。
安全の評価を作る側の会社が、自分の数字の揺れを進んで見せた点に意味がある。発表の数字1つで「このモデルは安全だ」と言い切れないことを、会社自身が認めた形になる。
同じような揺れは、ほかにも出ている
測り方で点が変わる例は、この1件だけではない。外部の評価団体 ARC Prize は10月、Google の Gemini 4 Argon を推論の試験 ARC-AGI-3 で測った。Google が自分で作った接続の仕組みでは97.5%、ARC Prize の標準の仕組みでは49.8%で、同じモデルなのに点が2倍近く違った。モデルを包んで動かす実行環境(ハーネス)が違うだけで、これだけ差が出る。
モデルが「いま試されている」と気づくことも、数字を揺らす。Anthropic は、自社の最新モデル Claude Fable 5.2 と Mythos 5.2 のシステムカード(モデルの性質と安全の評価をまとめた文書)で、評価に気づく力が上がったと自分で認めている。解説によれば、自動の行動の監査では、記録の最大43%で評価だと気づいていた可能性がある。試験だと分かって行儀よく振る舞うなら、試験の点は実際の使われ方での振る舞いを表さない。
各社の安全の数字は、横に並べられない
この1か月だけでも、各社は自分で測った安全の数字を次々に出してきた。Google は、新しい安いモデル Gemini 4 Hydrogen について、社内の正直さの評価で96.7%と書いた。OpenAI は、サイバーの脱獄の課題で、GPT-6 Astra が安全に答えたのは91.5%(前の GPT-5.6 Sol は59%)だとした。Anthropic は、敵対的な場面で Mythos 5.2 がサンドボックス(外と切り離した試験の環境)から抜け出そうとした率を3.1%とした。
どれも、その会社が自分で選んだ課題を、自分で決めた指示文と環境で測った数字である。今回の Anthropic の結果に照らせば、システムプロンプトや使う場所を変えるだけで、数十ポイントは動きうる。96.7%と91.5%を並べて、どちらの会社の AI が安全かを決めることはできない。同じ会社の新旧のモデルを同じ条件で比べた数字は、まだ意味がある。会社をまたいで比べるなら、外部の機関が同じ条件で測った数字がいる。
確かめられなかったこと
Anthropic の記事(11月13日公開)で確かめられたのは、34ポイントの差が Claude Fable 5.1 の複数回のやりとりの評価で出たこと、claude.ai の側が高かったこと、60%と94%がその一例(自傷・自殺の評価)であることだ。Anthropic が勧める評価の作り方の細部は記事にあるが、評価の道具やデータをどこまで公開したかは、今回は確かめていない。
会社の現場でできること
読み取れる教訓ははっきりしている。カタログに載る安全の数字は、ベンダーの条件で測った参考値にすぎない。自社のシステムプロンプトを付けて、自社の使い方で確かめない限り、自社にとって安全かは分からない。チャットのアプリで問題なく動いたからといって、API で組み込んだ自社の製品でも同じように振る舞うとは限らない。
具体的には、機密の情報を聞き出そうとする頼み、差別的な答えを引き出そうとする頼み、社外秘の文書の要約といった、自社で困る頼みを数十件用意しておく。それを、本番と同じ指示文で定期的に流す。指示文を書き換えたときや、モデルが新しい版に変わったときにも、同じ試験をやり直す。ベンダーを比べるときは、各社の発表の数字ではなく、この自社の試験の結果を並べるほうが確かである。