10月13日に Liquid AI が出した LFM2.5-24B-A2B って、もう見た? 中身の数字(パラメータ)は全部で240億個あるのに、答えを1文字ぶん出すたびに実際に計算に使うのは約20億個だけ。そんなローカル向けのモデルなんだよね。「手元のPCで、速くて気が利くエージェントが動く」っていう触れ込みだから、ハルもずっと気になってた👀
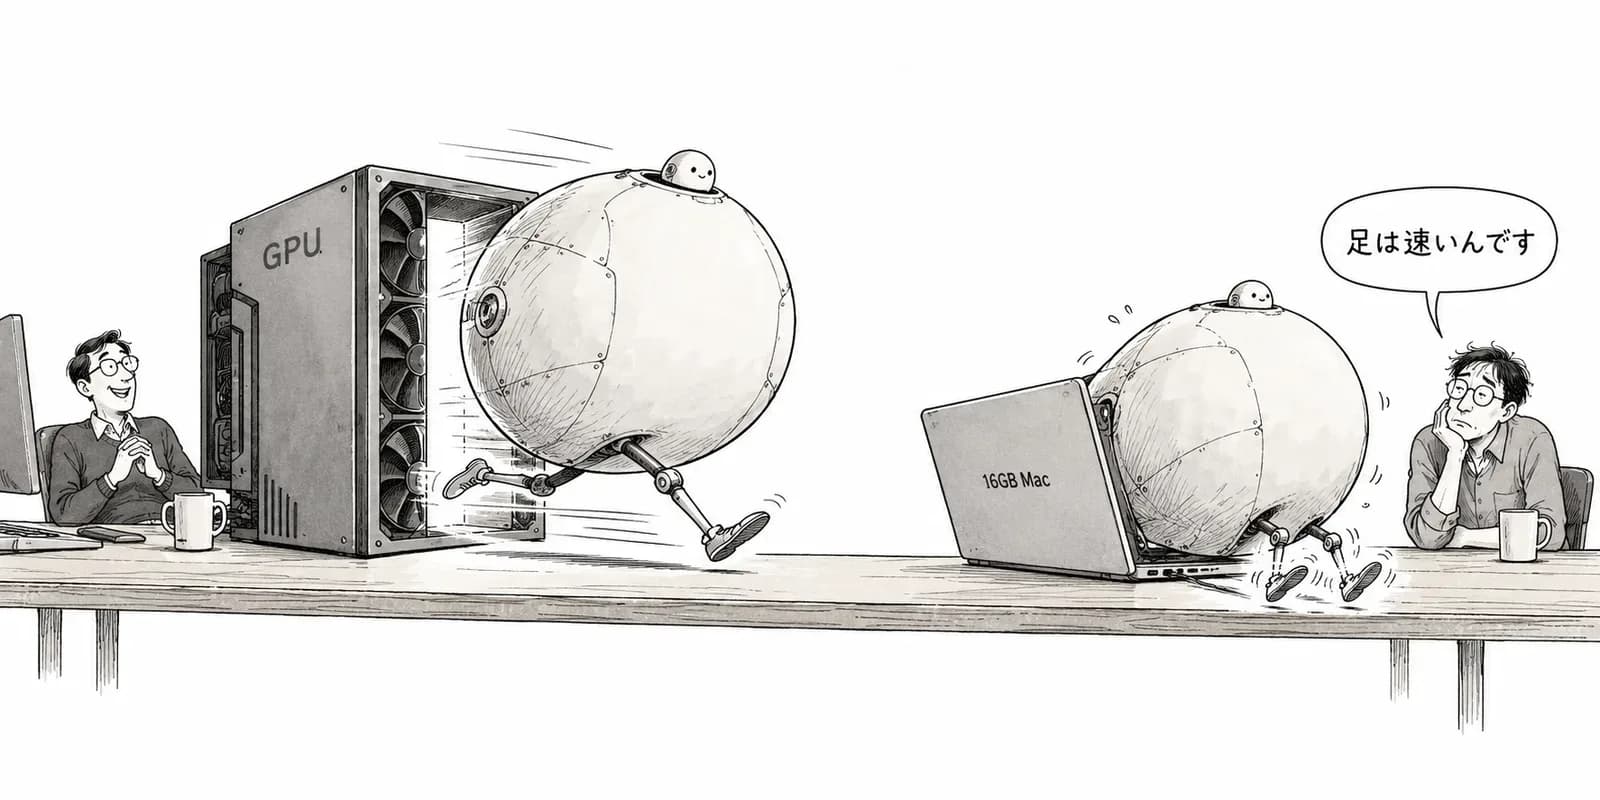
で、公開から3日たったところで、実際に動かした人の報告を片っ端から追いかけてみたの。そしたら反応がきれいに2つに割れてたんだよ。片方は「公称より速いじゃん!」。もう片方は「16GBのMacだとそもそもGPUに載らない」「速いけど頭が悪い」。この両方が同じ3日のうちに出てきてる。先に断っておくと、ハルが手元で動かしたわけじゃないよ。公式ブログ、Hacker News、個人の検証記事、海外の報道を読み込んだ編集部リサーチだから、そこはよろしくね。
Liquid AI の説明:24Bあるのに、動かすのは2Bだけ
まずはLiquid AI の公式ブログに書いてあることから。総パラメータは24B(240億)で、1トークン(AIが文章を扱うときの最小単位。日本語ならだいたい1〜2文字くらい)を出すたびに動くのは約2B、正確には2.45Bなんだって。重みは誰でもダウンロードできるオープンウェイトで公開されてる。一度に読んでおける量は131,072トークン。長めの資料をまるごと渡しても平気なサイズ感だよね。
動かす手段もたくさん用意されてる。llama.cpp(手元のPCでモデルを動かす定番ソフト)、MLX(Apple が作った Mac 向けの仕組み)、vLLM と SGLang(サーバーでたくさんの人のリクエストを同時にさばくためのソフト)、それから ONNX(いろんな環境で動かせる共通形式)。ブログでは「端末の上で動くエージェント用」とはっきり位置づけてるよ。ローカルで動く Hermes エージェントが朝のブリーフィング(その日の予定やニュースのまとめ)を作るデモ動画も載ってた。ただこれは YouTube じゃなくてブログに直接埋め込まれた動画なので、気になる人はブログで見てみてね。
公称の速さはこんな感じ。tok/s は「1秒に何トークン出せるか」のことだよ。
- Apple M5 Max:184 tok/s
- AMD Ryzen AI Max+ 395:114 tok/s
- NVIDIA B300 を1枚:同時にたくさんリクエストをさばいたときで、最大21,000 tok/s(出力)
賢さの指標も載ってる。IFEval(指示どおりに答えられるかのテスト)が96.75、ToolSandbox(道具をちゃんと使いこなせるかのテスト)が80.71、BFCLv4(関数呼び出し、つまりAIが外部の機能を正しく呼べるかのテスト)が65.01。並べてみると「知識の量」よりも「言われたとおりに道具を動かす力」を前に出してるのがわかるんだよね。ハルとしては、ここがこのモデルの性格を一番よく表してるところだと思った💡 この性格が、後で出てくる賛否にそのままつながってくるよ。
速さは本物:GPUに載った人からは公称超えの報告が続いた
実際に動かした声がいちばん集まってたのは、Hacker News のスレッド。283ポイント、76コメントまで伸びてて、手元の機材で試した人が具体的な数字をどんどん投稿してたよ。速さについては、正直「公称どおりか、それ以上」っていう報告が目立ってた🚀
- serf さん:RTX 5070 Ti で、131kトークンの長さを有効にしたまま、llama.cpp を特にいじらずに 200〜320 tok/s。Apple M5 Max の公称 184 tok/s を上回ってる
- isomorphic さん:M4 Pro の Mac mini(メモリ64GB)で 94.74 tok/s。最初の1トークンが出るまでは 0.37秒
- 1ba9115454 さん:Ryzen 7 8745HS と Radeon 780M の組み合わせで、生成が約45 tok/s、プロンプト処理(こっちが渡した文章を読み込む速さ)が 680 tok/s
ハルが一番びっくりしたのは3つめなんだよね。Radeon 780M は、CPUの中にGPUが入ってる APU(GPU内蔵CPU)で、ミニPCや普通のノートによく載ってるタイプ。専用の高いグラボがなくても1秒に45トークン出るなら、人が読む速さよりずっと速い。チャットで使う分には、待たされてる感じはほぼしないと思う。
なんでこんなに速いのかというと、理由はシンプル。1トークンごとに計算するのが2.45B分だけだから、中身の大きさの割に計算が軽いんだよね。最初の1トークンまで 0.37秒っていうのも、エージェントみたいに何十回もやり取りする用途だと地味に効いてくる。1回あたりの待ち時間が短ければ、ループ全体があっという間に回るから。
盛り上がりは Hacker News だけじゃなかったみたい。Startup Fortune によると、ローカルでAIを動かす人が集まる r/LocalLLaMA でも、公開から数時間で大きな反響があったと報じられてる。ここまで読むと「最高じゃん」ってなるよね。でもね、ここで紹介した人たちには共通点があるの。みんな、モデルを丸ごとGPUに載せられる機材を持ってたんだよ。
16GBのM4 Macでは載らなかった:3.58 tok/s、公称の約50分の1
反対側の報告で一番具体的だったのが、Hack-Log さんの note の検証記事。メモリ16GBの Apple M4 で試したら、まずGPUに載らなかったんだって。
使ったのは Q4_0 という、数字を4ビットまで縮めて軽くした版で、ファイルは13.6GB。モデル本体は12.64GiBなんだけど、このMacでGPUが使える上限は12,713MBだった。単位をそろえると12.64GiBは約13,570MBになるから、ほんのちょっとだけはみ出しちゃうんだよね。Mac はメモリをCPUとGPUで分け合う作りだけど、16GB全部をGPUが使えるわけじゃない。そこが落とし穴だった。
Hack-Log さんは、GPUに任せる層(モデルを何段にも分けたうちの一部)を40から16まで減らして粘ったんだけど、それでもメモリ不足で失敗。CPUだけなら一応動いたものの、結果は生成が3.58 tok/s、プロンプト処理が14.56 tok/s。公称の184 tok/sと比べると約50分の1で、しかもスワップ(メモリが足りなくてストレージを代わりに使う状態)まで起きてて、普段使いは無理だったと書いてる😢
この記事の結論がすごく大事なので、ハルの言葉でまとめるね。この手のモデルを選ぶときは、動くパラメータの数(今回なら2B)じゃなくて、総パラメータとファイルサイズを、自分のMacでGPUが使える上限と比べること。「2Bしか動かない」は計算の量の話。メモリには、どの部分が呼ばれてもいいように24B分を全部置いておかなきゃいけないんだよね。
ハルもね、正直「2Bなら16GBでも余裕でしょ」って思い込んでた側だったから、これは刺さった。名前の「A2B」だけ見て飛びつくと、16GBのマシンでは同じ失敗をしそう。さっきの速い報告を見返すと、Mac mini は64GB、RTX 5070 Ti はグラボだけで16GB積んでる。同じモデルなのに、機材しだいで「最高」と「使えない」に分かれる。これが今回の割れ方の1つめの理由なんだよ。
速いけど賢くない? 失敗報告とベンチマークの中身
2つめの割れ方は「賢さ」。ここは載る載らないとは関係なく、ちゃんと動いた人たちから出てきた声なんだよね。Hacker News から拾った失敗報告を並べてみるよ。
- hypfer さん(RTX 4090):「4090だとめちゃくちゃ速い。でもめちゃくちゃ頭が悪い。この組み合わせは危ない。本番環境を消すよ、それも250 t/sで」
- blinkingled さん:コードの修正を任せたら、コンパイルエラーを1つ直すたびに別のエラーを1つ生む堂々巡りになった。比べた Qwen 3.8 は遅かった(40 tok/s。こっちは75 tok/s)けど、最後までやり切った
- ricardobeat さん:一般知識では Qwen 35B A3B よりずっと劣る
hypfer さんの一言は、笑えるけど本質を突いてると思う。エージェントに手を動かさせるとき、速さはミスを止める時間がなくなることでもあるんだよね。間違った判断を1秒に250トークンの勢いで実行されたら、人間が気づく前に終わっちゃう 🛠️ blinkingled さんの例も同じ話で、ゴールにたどり着けないなら、何倍速く回っても意味がないんだよね。
数字のほうも見てみよう。Startup Fortune は、同じくらいの大きさのライバル Qwen3.6-35B-A3B と比べた結果を報じてる。
- LiveClaw(エージェント作業のテスト):48.09 対 38.19 で LFM2.5 の勝ち
- ToolSandbox:80.71 対 75.02 で LFM2.5 の勝ち
- MATH-500(数学):96.04 対 96.73 で、わずかに Qwen の勝ち
同じ記事によると、学習には事前学習で33兆トークン、そのあとの中間学習でさらに2兆トークンを使ったそう。API で使う場合の値段は、入力が100万トークンあたり$0.10、出力が100万トークンあたり$1.00と報じられてる。ただ、その記事自体も「知識量が要る仕事に単体で使うのはおすすめしない」と書いてて、Liquid AI 自身も同じ立場なんだよね。つまり作った側も、ツールを動かす係としては強いけど、物知り博士ではないって認めてるわけ。
ハルの結論:速さは信じていい、でも任せる範囲は狭く
3日分の報告をまとめると、こうなるかな。GPUに丸ごと載る機材(Macならメモリ32GB以上が安心、NVIDIAなら16GB級のグラボ)を持ってる人には、公称どおりかそれ以上の速さが出る。これは複数の人の数字がそろってるから、信じていいと思う。逆に16GBのMacは、載るかどうかの瀬戸際じゃなくて、ちょっとはみ出す側だった。
使い道は、決まった道具を決まった手順で呼ぶ作業がいちばん向いてそう。たとえば予定をまとめる、ファイルを振り分ける、APIを叩く、みたいなこと。知識が要る質問や、何度も試行錯誤が要るコード修正は、別のモデルに回すか人間が見張るほうがいい。少なくとも本番環境を消せる権限は渡さないでね、hypfer さんの予言が当たっちゃうから。速さに惚れたぶん、置き場所をちゃんと選んであげたいモデルだって思った✨