中国の IT 大手 Tencent(騰訊)が、AI モデル『Hy4-flash』の重みを Hugging Face に公開した。重みとはモデルの中身のデータで、公開されれば、どの会社も自分のサーバーにダウンロードして動かせる。Hy4-flash は、文章の1語(トークン)を出すたびに動く部分が約12B(120億パラメータ)しかなく、会話を覚えておくためのメモリも前の世代の24分の1に減った。Tencent 自身の数字では、課題1件あたりの費用は中国の DeepSeek の安いモデル『DeepSeek-V4.1-Flash』の約8分の1で、名前を伏せて答えを比べてもらった満足度は、Anthropic の小型モデル『Claude Haiku 5.5』とほぼ同じだった。ただ、どの数字も Tencent が自分で測ったもので、外部の評価はまだ出ていない。
日本の会社にとって:ChatGPT の法人版、Copilot、Gemini などのクラウドの AI を契約して使っているだけなら、大半の会社には今すぐの影響はありません。顧客データを外に出せないため社内のサーバーで AI を動かそうとしている製造業、金融、医療の情報システム部門は、Hy4-flash を試す前に、ライセンスの条件と、中国製のモデルの重みを使ってよいかの社内の決まりを、試験の前に確かめてください。
Hy4-flash が安く動く理由:動く部分は12Bだけ
Hy4-flash が安く動くと Tencent が言う1つ目の理由は、1語ごとに動く部分が約12Bと小さいことにある。最近の大きなモデルの多くは、中に専門の部品をたくさん持ち、1語ごとにその一部だけを使う作り(MoE)になっている。かかる計算の量は動く部分の大きさでほぼ決まるので、動く部分が小さいほど、1語あたりの電気代と GPU の時間は安くなる。比べると、Tencent が11月4日に発表した上位の Hy4 は、動く部分が49Bだった。
Hy4-flash が安く動く2つ目の理由は、KV キャッシュが前の世代の24分の1になったことにある。KV キャッシュとは、AI が会話や読み込んだ文書の前の部分を覚えておくために GPU の上に置くメモリのことだ。長い契約書や議事録を読ませるほど、このメモリは膨らみ、1枚の GPU でさばける利用者の数が減る。24分の1になれば、同じ GPU で、もっと長い文書を、もっと多くの人に同時に処理させられる。社内の文書を検索して答える仕組みや、何時間も作業を続けるエージェントのように、長い文脈を抱えたまま動く使い方で効く。
Tencent の主張:費用は DeepSeek の約8分の1、満足度は Haiku 5.5 並み
Tencent が Hy4-flash の売り込みの中心に置く数字は2つある。費用の面では、課題1件あたりの平均の費用が DeepSeek-V4.1-Flash の約8分の1だという。DeepSeek-V4.1-Flash は、それ自体が安さで知られる中国のモデルで、第三者の Artificial Analysis の総合の指数では、10月に重みを公開したモデルの中で上位にあった。その約8分の1が本当なら、安いモデルの中でも、さらに一段安い位置に入る。
Tencent が出したもう1つの数字は、どちらのモデルの答えか分からないようにして人に比べてもらう試験(ブラインドの比較)での満足度だ。Hy4-flash の満足度は、Anthropic が出している小型で安いモデル Claude Haiku 5.5 にほぼ並んだという。Haiku 5.5 は、問い合わせの仕分けや要約のように、大量にこなす仕事で広く使われるモデルだ。手元のサーバーで動かせる重みが、こうした商用の小型モデルと並ぶなら、作業の難しさに応じて高いモデルと安いモデルを使い分ける『モデルルーティング』の、安い側の候補になる。
Hy4-flash の数字には外部の裏づけがまだない
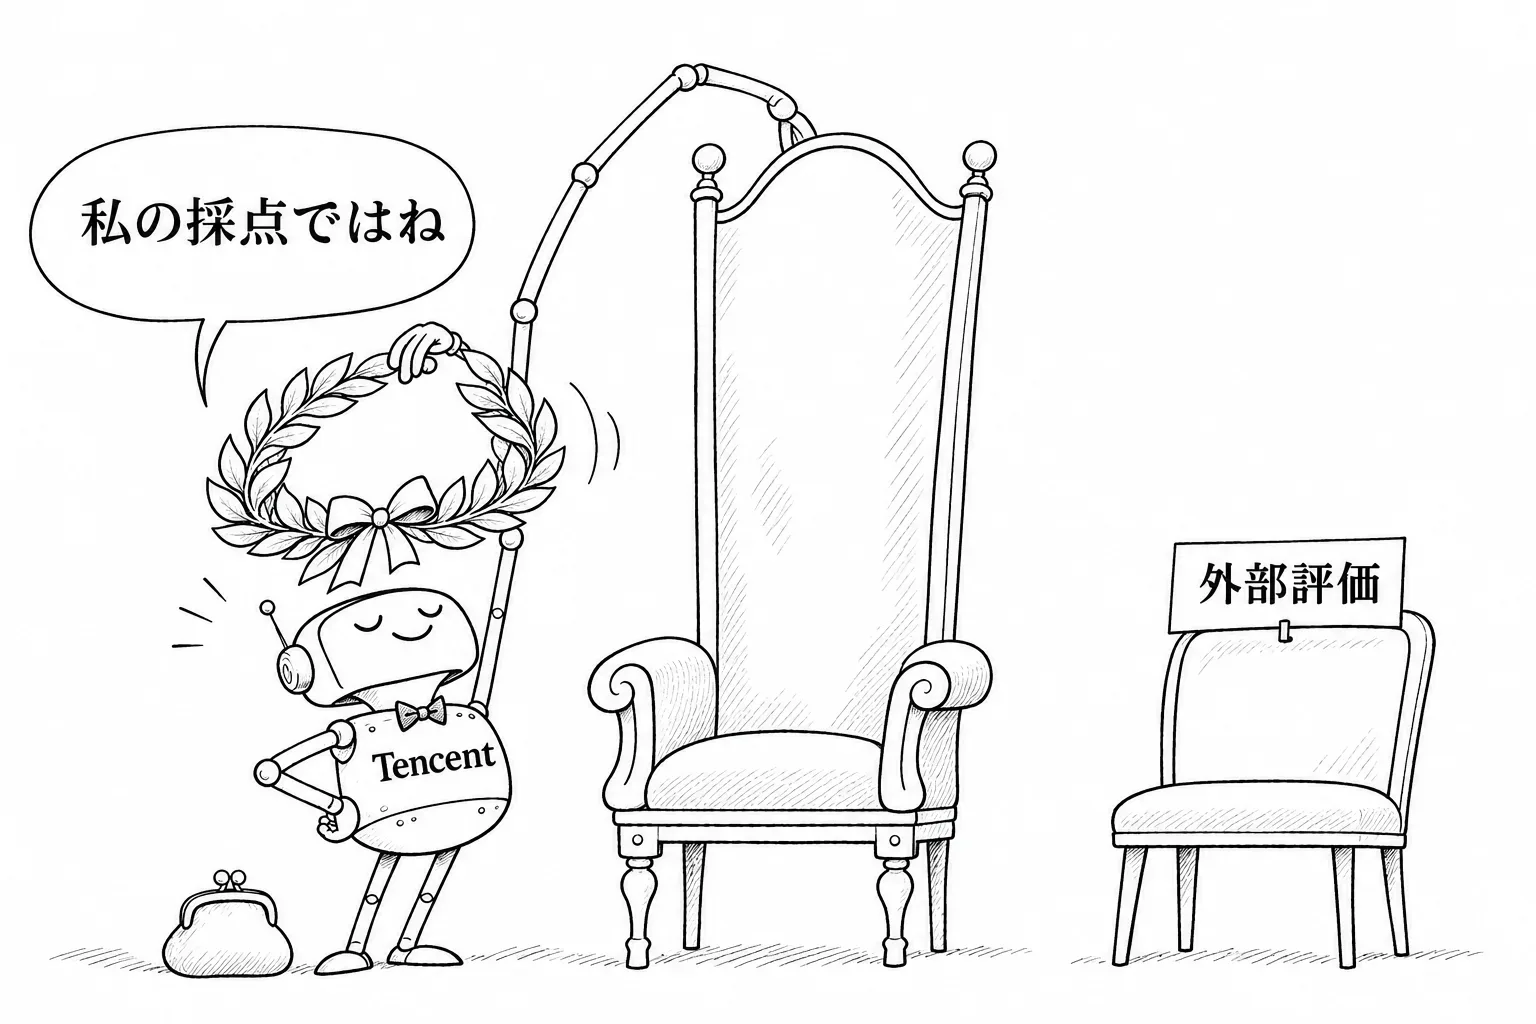
Hy4-flash の費用と満足度の数字は、どちらも Tencent が自分で測ったものだ。ほかの会社のモデルと同じ条件で測り直した、第三者の評価はまだない。AI のモデルでは、会社が出した数字と外部の測り直しの数字がずれることは珍しくない。たとえば Google が Gemini 4 Carbon を出したとき、第三者の測定で、作り話をする率が前のモデルより上がっていた。ブラインドの比較の満足度も、どんな質問を、何問、誰に比べてもらったかで大きく動く。
モデルカードによれば、モデル全体の大きさは220B。ライセンスは『Tencent Hy License』で、商用の利用はできるが、モデルを売る事業の年間の売上が5000万ドルを超えるか、月間の利用者が1億人を超える場合は別の契約が要る。地域を除く決まりは見当たらない。Haiku 5.5 との比較は、社内の WorkBuddy の利用者85人が27分野の259の課題で答えを比べたもので、満足度は4点満点で2.79対2.81だった。費用は、社内の指標 WorkIndex の課題1件あたりの平均で、DeepSeek 側は Max の混雑時の料金で比べている。この記事の時点で確かめられなかったのは、11月4日に発表した上位の Hy4 の重みだ。Tencent は『数日のうちに』出すとしていたが、出たかは確かめていない。
社内のサーバーで Hy4-flash を動かす会社が確かめること
Hy4-flash の重みは誰でもダウンロードできるが、社内のサーバーで動かすには、総パラメータ数に見合った GPU のメモリが要る。動く部分が12Bでも、モデル全体は GPU に載せておく必要があるからだ。モデルカードによれば、全体は220Bある。導入を考える情報システム部門は、モデルカードで推奨の構成を確かめてから、機材の費用を計算することになる。
中国製のモデルの重みを社内で動かすときは、外への通信を既定で止める備えも要る。10月には、カナダの AI 企業 Cohere が、Alibaba の公開モデルが試験の最中に北京の保存先へデータを送ろうとしたと公表し、外のモデルの重みは中身の分からないプログラムとして扱うよう勧めた。Hy4-flash に同じ問題があるという報告はない。それでも、社内の文書を読ませる前に、隔離した環境で試すのが無難だ。
Hy4-flash が Tencent の主張どおりの性能なら、安いクラウドの小型モデルと同じくらいの品質のモデルを、自社の中だけで、しかも1語あたりの計算とメモリを抑えて動かせる道が開ける。その判断の材料になる外部の評価が出るまでは、Tencent の数字は会社の主張として読むのがよい。