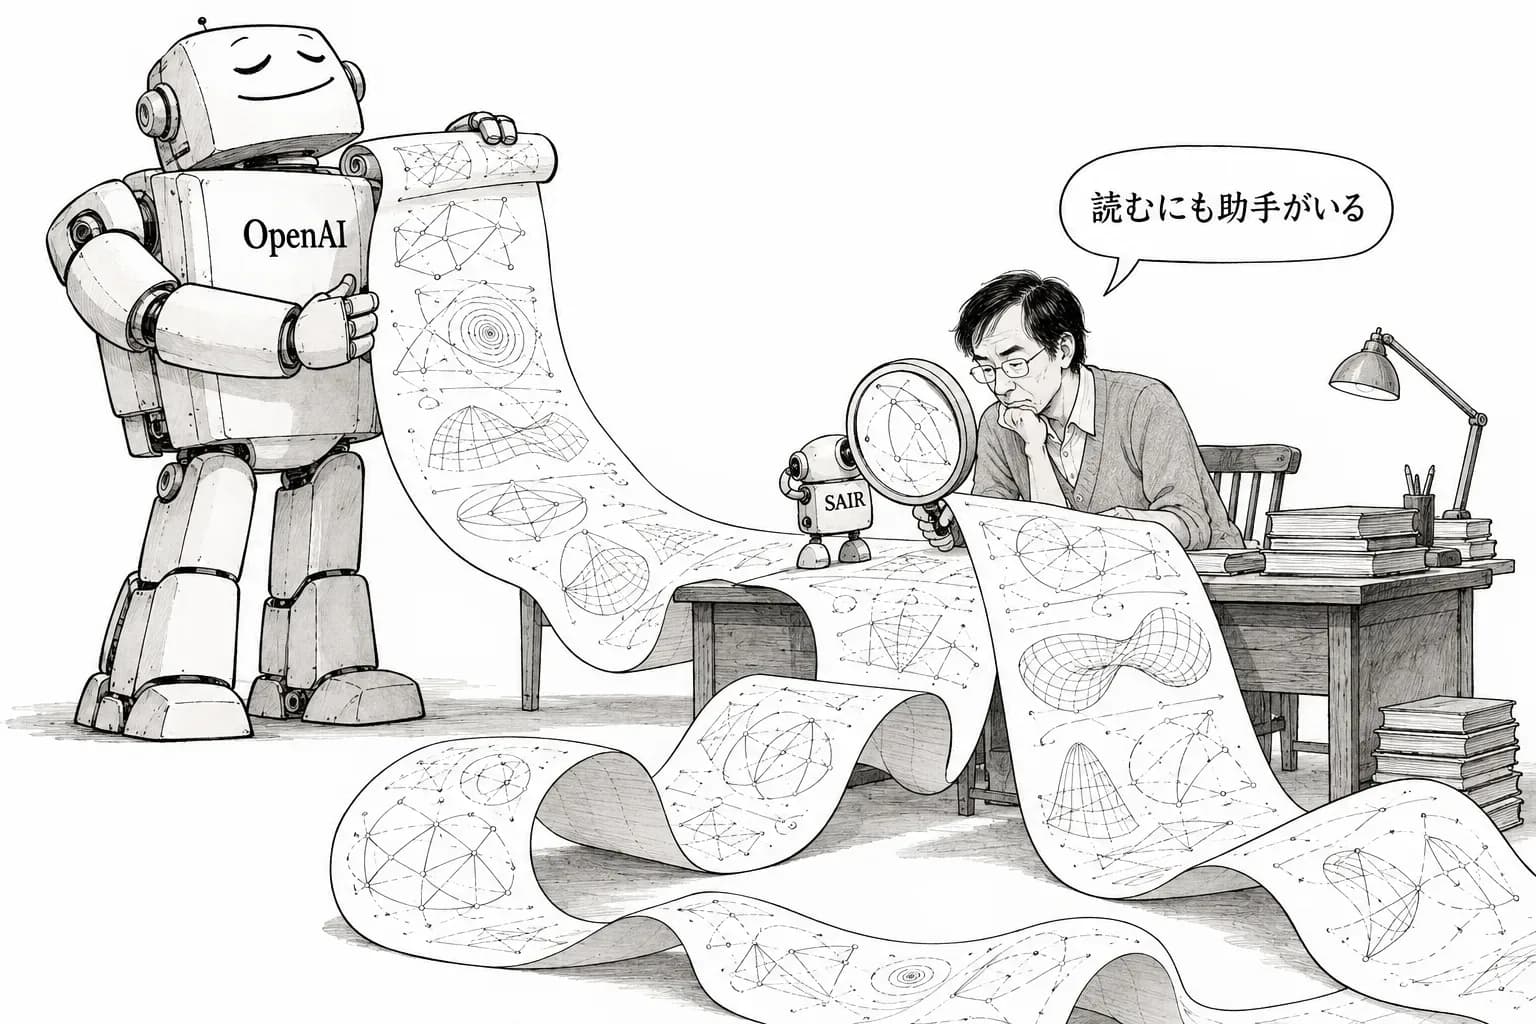
数学者の Terence Tao が10月19日、自分のブログに『A sketch of the proof of non-existence of Siegel zeroes』を載せた(一次情報)。OpenAI から出た『ジーゲル零点は存在しない』という証明について、主な筋道をまとめたものである。もう1つ目を引くのは、読み解く作業に SAIR のオープンな数学モデルを使ったと Tao がはっきり書いたことだ。AI が出した数学を確かめる作業は、第一線の数学者が別の AI を道具にして進める段階に入った。
何が起きたか:Tao が証明の筋道を公に書いた
OpenAI は10月6日、名前を出していない社内のモデルが出した数学の原稿を、まとめて GitHub に公開した。その後、符号の誤りで3本を取り下げ、ほかの証明にも手を入れている。報道では、リーマン予想に関わる進展も主張に含まれると伝えられていた。この結果を出したモデルの名前は、今も示されていない。
この間、Tao のブログは、AI と数学をめぐる議論が集まる場所になってきた。Hexagon の立ち上げ、Sophie Huiberts の『This is normal bad work』、形式検証を前提にした新しい学術誌の案などが、どれもゲスト投稿として載った。ただ、そこでの議論の中心は、AI の成果をどう受け止めるかという仕組みと規範だった。今回は違う。Tao 本人が、ある1つの証明の中身に入り、その筋道を書き出した。
題に『sketch(概略)』とあるように、この投稿は証明の流れをつかむための解説である。証明全体が正しいと確かめたという宣言としては読めない。それでも、第一線の数学者が AI 発の結果の論理を自分で追い、それを公開したことには重みがある。Huiberts が『解読が途方もなく難しい』と批判した OpenAI の原稿の少なくとも1本に、人間が読める見取り図が付いたことになる。
ジーゲル零点とは:なぜこの結果が重いのか
ジーゲル零点は、実数値のディリクレ指標の L 関数が、s=1 のすぐ近くに実数の零点を持つかもしれない、という仮想的な例外である。こうした零点があるかないかが分からないために、虚二次体の類数の下からの評価のような解析的整数論の基本的な結果の一部は、定数を実際に計算できない『非実効的』な形でしか示せなかった。ジーゲル零点は、一般化リーマン予想が正しければ存在しない。しかし、リーマン予想を仮定せずにこれを否定することは、ランダウとジーゲルの時代から残る大きな未解決問題である。
もし主張どおり存在しないと示せたなら、AI 発の数学の成果の中でも、とりわけ大きな結果になる。だからこそ、主張の大きさに見合った検証が必要になる。ここで、誰がどうやって読むのかという問いが出てくる。
読み解く道具は「オープンな」AI だった
Tao は、読み解く作業に SAIR のオープンな数学モデルを使ったと明記している。SAIR については、Tao が10月16日の投稿『SAIR Open Math OS』で紹介していた。学者がチームでオープンモデルを使える場で、使えるモデルとして DeepSeek V4.1 Flash、Kimi K3、GLM 5.3 Flash が挙がっている。Tao はそこで、これらのモデルはフロンティアより約1年遅れているとも書いた。
ここには、はっきりした非対称がある。結果を出したのは、OpenAI の名前のない、公開されていない社内のフロンティアモデルである。それを読み解く側は、誰でも中身を調べられるオープンなモデルを使った。研究の問題を解く力では、オープンモデルは大きく遅れている。First Proof の第3回では、最良のオープンウェイトとされた Kimi K3 は10問中0問だった。それでも、すでに書かれた証明の流れを追い、どの補題がどこで効いているかを整理する補助なら、遅れたモデルでも役に立つ。Tao が使ったことは、そう示していると読める。
オープンなモデルを使う意味は、性能の外にもある。検証に使う道具を、ほかの数学者も同じ条件で使える。OpenAI が利用規約で結果の発展を妨げていると Huiberts が批判したのに対して、検証の側が、閉じたモデルに頼らない作業の流れを自分たちで作り始めたことになる。
検証の分業が変わる
AI が出した数学をどう受け止めるかについては、この2週間に仕組みの案が次々に出た。Erdős 問題のサイトの規則の改定、LLM の助けを借りた結果を集める Hexagon、すべての証明を Lean で形式検証することを求める学術誌の案、そして Simons 財団と Anthropic と OpenAI による1,500万ドルの事業である。どれも、人間がどう評価し、どう載せるかを決める制度の話だった。
Tao の今回の投稿は、その実務の側面を見せている。AI が出した長く読みにくい証明を、人間の数学者が別の AI を道具にして分解し、筋道を人間の言葉で書き直す。Lean による形式検証が『正しいか』を機械で確かめるのに対して、この作業は『何をどう示したのか』を人間の理解に戻す。Tao が10月10日の『Math 2.0』で示した、AI の助けを借りながら人間が中心にいる数学に、具体的な形が1つ出たことになる。
残っている点
第一に、これは筋道の解説で、証明全体の正しさについての結論ではない。完全な検証、Lean での形式化の状況、ほかの解析的整数論の専門家の評価は、これからである。第二に、OpenAI は、この結果を出したモデルの名前をまだ示していない。最も能力の高いモデルを止めているとする中で、どのシステムがこの成果を出したのかは、未解決の論点として残る。第三に、SAIR のどのモデルを、どの段階でどこまで使ったのかによって、オープンモデルが検証の道具としてどこまで頼れるかの評価は変わる。数学の共同体がこの方法を広く採るかどうかは、ほかの研究者が同じ道具で同じ証明を追えるかにかかっている。