Anthropic が9月22日に公開した Claude Opus 5.5 について、自社発表の優位が外部の数字で裏付けられた。ARC Prize のリーダーボードでは ARC-AGI-2 で93.3%を記録し、Vals AI でも首位に立った。Artificial Analysis の Intelligence Index v4.3.2 で史上最高の58を出したことは前日に伝えた。これで、互いに独立した第三者評価の3つで首位になったことになる。
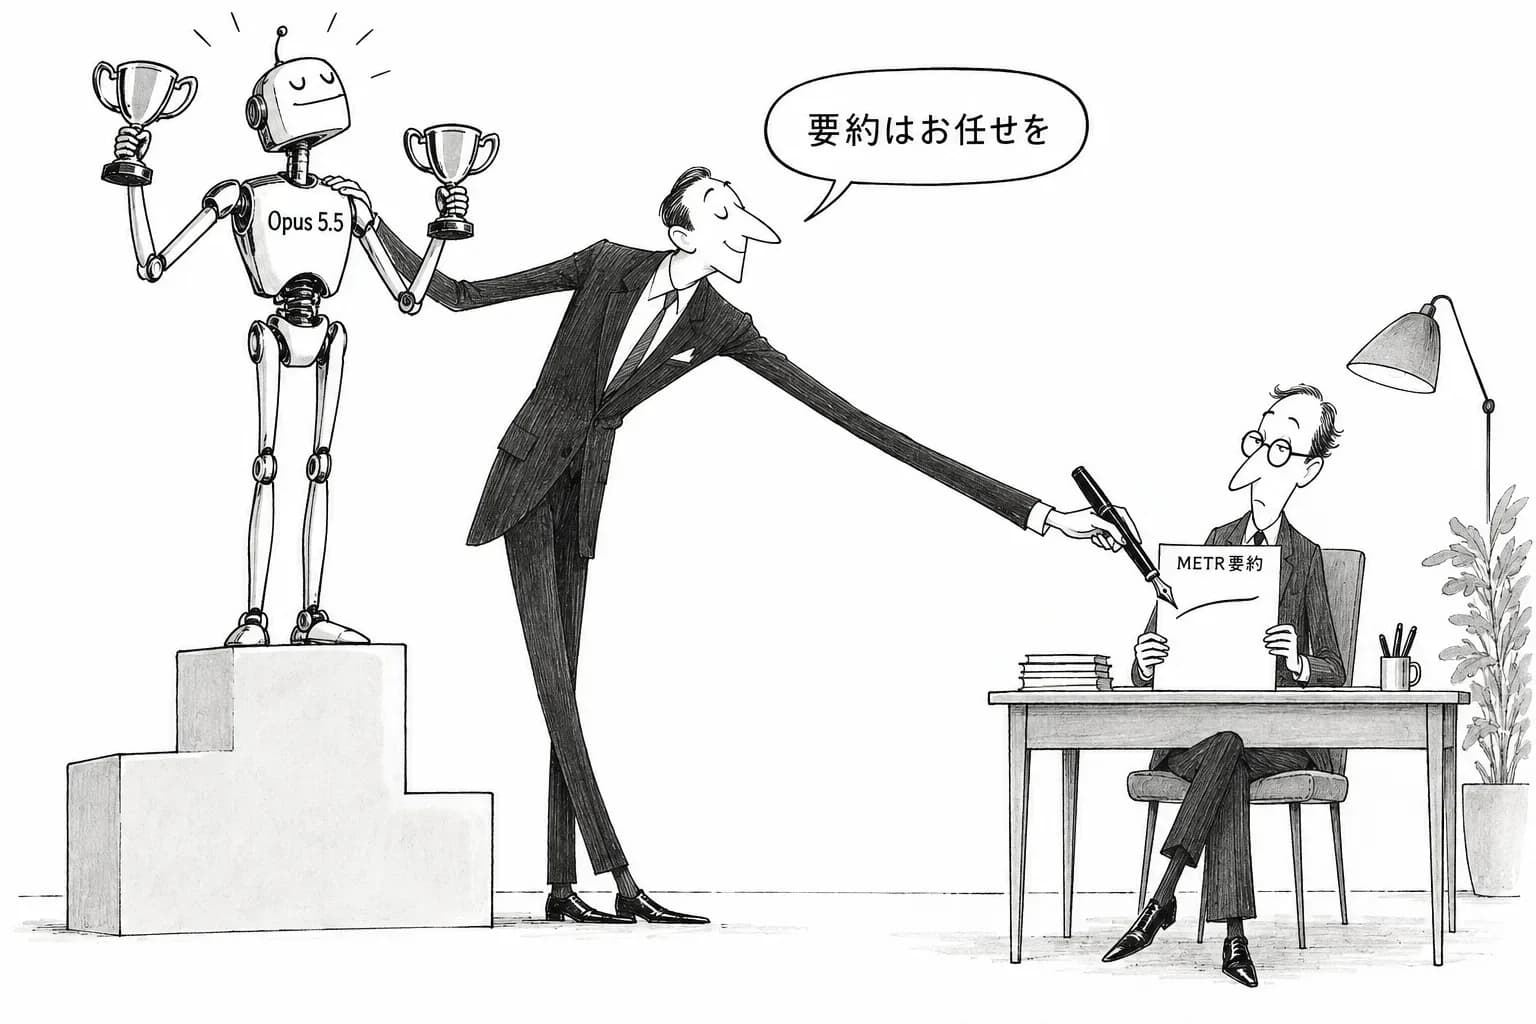
一方、同じ日に読めるようになった METR の報告本文からは、別の事実が分かった。システムカードに載っていた「AI 研究の加速は約1.5倍」という数字には3つの条件が付いている。METR の要約は公表前に Anthropic が確認・編集していた。評価期間は10営業日だった。そして METR は、2倍の加速に達する確率を約30%と見ている。本紙は前日、この1.5倍を「ラボが初めて外部評価者の数字で RSI の問いに答えた事例」として報じた。この評価は撤回しないが、読み方を改める必要がある。
能力面:自社発表が外部の数字で裏付けられた
Anthropic が公開時に挙げた数字は、すべて自社測定だった。Terminal-Bench 4.0 で66.4%、GDPval-AA v2.1 で1846 Elo、OSWorld 2.0 で81.8%などである。自社が選んだベンチマークで自社が測った数字は、他社比較として割り引いて読むのが通例だ。
今回の3つの評価は、いずれも Anthropic が選んだ指標ではない。ARC-AGI-2 は ARC Prize 財団が運営する抽象推論の課題で、Opus 5.5 の発表資料には載っていなかった。Vals AI は業務領域ごとの独自タスクで各社モデルを横並びで測る評価機関だ。Artificial Analysis は10指標の合成指数である。測る対象も運営主体も違う3つで首位が揃ったことは、特定のベンチマークに合わせ込んだ結果という説明を難しくする。
ただし全勝ではない。自社発表の時点で、AutomationBench では GPT-6 Astra の41.4%に対して40.0%で負けていた。また LMArena は9月13日から更新が止まっており、Opus 5.5 にも GPT-6 Sol/Luna にも人間の選好による評価はまだない。指数の上位はコストも高い。Artificial Analysis によれば、努力量 max で指数タスク1件あたり5.98ドルかかり、low では0.55ドルだが指数は42まで下がる。エージェントを運用する側でトークンと計算コストをどう管理するかという問題は、首位になっても消えない。
METR の報告本文が示した3つの条件
前日の報道は、システムカード本体の PDF に届かず、二次要約2本を突き合わせて書いたものだった。そこでは「METR による展開前の外部評価が AI 研究の加速を約1.5倍と見積もり、完全自動化は見込まない」とだけ伝わっていた。METR 自身の報告本文を読むと、この一文には次の3つの条件が付いている。
1. 要約は公表前に Anthropic が確認・編集していた
システムカードに載った METR の要約は、公表前に Anthropic が目を通し、手を入れたものだった。METR 自身がそう書いている。どの箇所がどれだけ変わったのかは、本文からは分からない。編集が事実関係の確認にとどまったのか、表現や強調の置き方にまで及んだのかも判断できない。確かなのは、読者が「外部評価者の数字」として受け取った文言が、評価される側の確認を経て出たという点である。
2. 評価期間は10営業日
METR が展開前のモデルを評価できたのは10営業日だった。AI 研究の加速率は、長い時間をかけて進むエージェントの作業を観察して推定するものだ。2週間という期間は、この推定の不確実性に直結する。完全自動化を見込まないという判定も、この期間で観察できた範囲での判定と読むべきである。
3. 2倍の加速の確率は約30%
1.5倍は METR の見積もりの中心値であり、上限ではない。METR は2倍以上の加速に達する確率を約30%としている。およそ3回に1回は研究速度が倍になる、という見方だ。システムカード経由で1.5倍だけが伝わった結果、分布の右側の裾が落ちていた。RSI をめぐる今週の論争で本当に問われているのはこの裾の部分であり、ここが落ちたことの意味は小さくない。
「1.5倍」をどう読み直すか
この3つの条件は、前日に OpenAI が公開した「Priorities and principles for effective third party assessments」と照らし合わせると意味がはっきりする。この原則には、評価者の独立性や利益相反の開示と並んで、ラボに有利な条項も入っていた。公表前の是正期間と、ラボによる伏字の要請である。今回 METR の報告から分かった「公表前にラボが確認・編集する」という手順は、OpenAI が文章で提案した段階のものを、Anthropic がすでに実際に運用していたことを示している。
だから問題は Anthropic 一社の振る舞いにとどまらない。第三者評価をめぐる議論は、「外部評価者がいるか」から「外部評価者の文言を最終的に誰が決めるか」へ移るべきである。今回の件では、元の文言と公表された文言の差分が公開されていない。評価の中身がどれほど堅くても、読者はどこまでが METR の判断でどこからが Anthropic の調整なのかを切り分けられない。前日の本紙を含めて、1.5倍を「独立した外部の数字」として受け取った報道は、その切り分けができないまま書かれていた。
一方で、METR がこれらの条件を自ら本文に書いたことは評価すべきである。編集があったこと、期間が短かったこと、裾の確率を開示したことで、読者はシステムカードの要約を割り引いて読めるようになった。今後、本紙は Opus 5.5 の RSI に関する数字を「METR の見積もりは中心値約1.5倍、2倍の確率は約30%。評価期間は10営業日で、要約は公表前に Anthropic が確認・編集」とまとめて扱う。1.5倍だけを単独で引用することはしない。
次に見るべきこと
第一に、METR がシステムカードに提出した元の文言と、公表された版との差分である。METR か Anthropic のどちらかがこれを出せば、編集がどこまで及んだかは一度で決着する。
第二に、同じ基準を他社にも当てはめることだ。GPT-6 Sol/Luna は単独のシステムカードを持たず、GPT-6 Astra のシステムカードの付録に追記された。本紙はまだその付録本文を読めていない。外部評価者が関わったのか、関わったなら公表前にラボの確認を経たのかを、同じ問いで確かめる必要がある。
第三に、9月23日の国連安全保障理事会の AI 会合で Dario Amodei が何を語ったかである。「フロンティアのペース配分」を呼びかけた本人が、自社の最新モデルについて「2倍の加速の確率が約30%」という外部の見積もりをどう説明するのか。能力面で首位が確定した今、問われているのは速さではなく、その速さを誰がどの条件で測ったかである。