【追記 2026年11月9日 4:38】発表の日付は11月6日と分かっているので、「確かめられていないこと」から日付を外しました
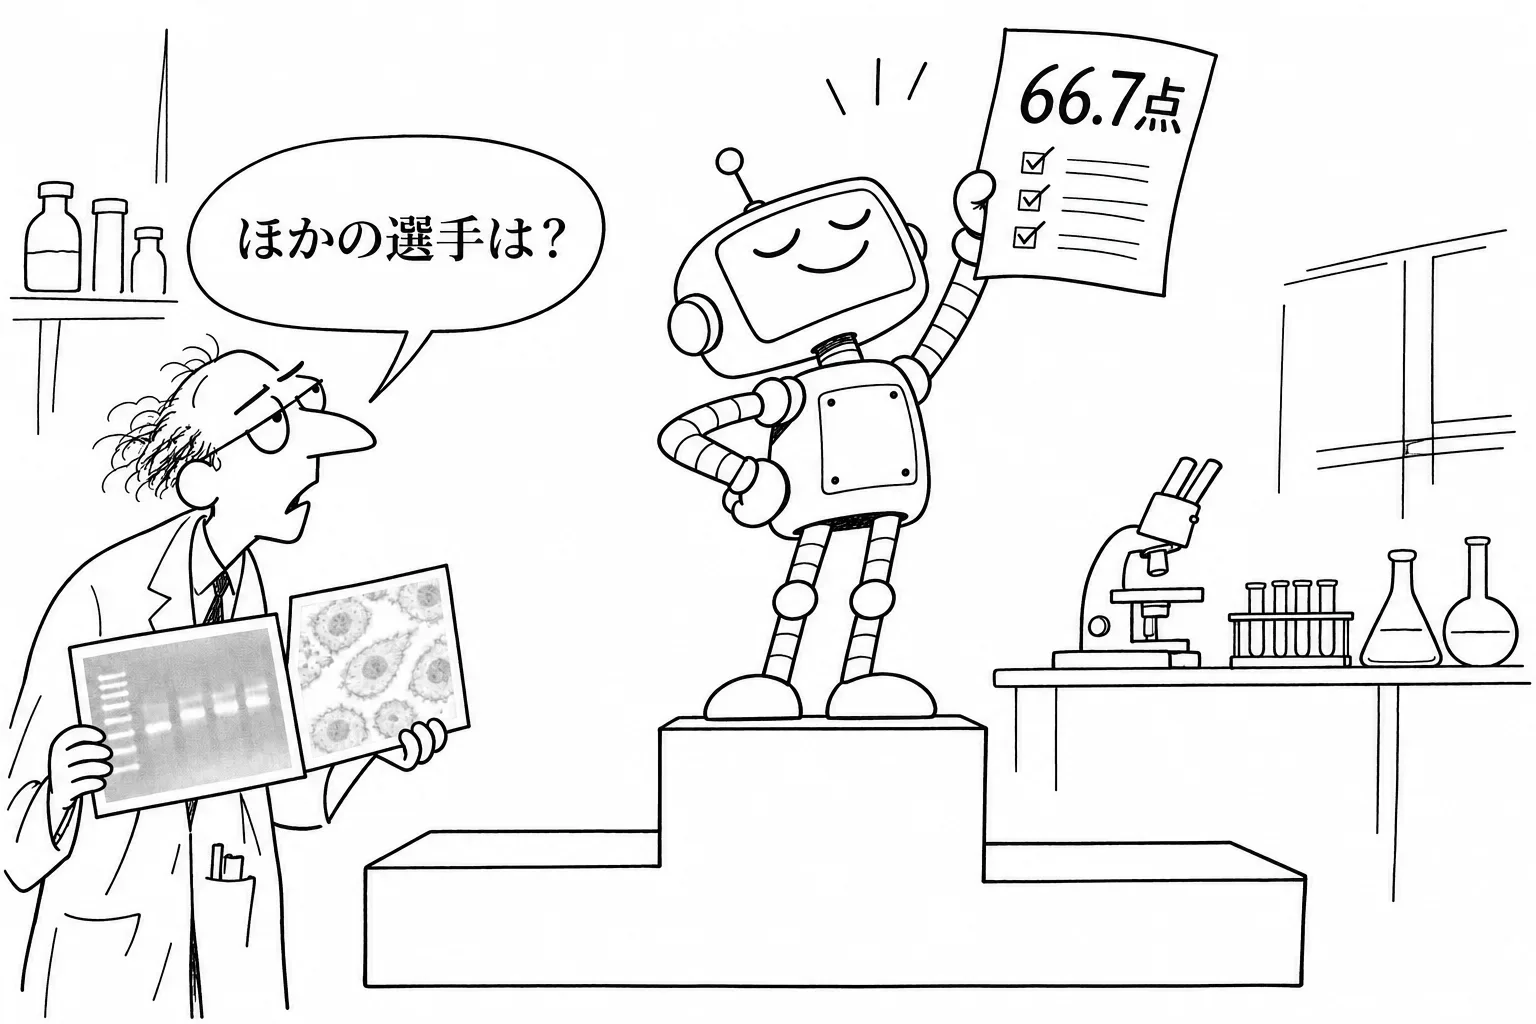
OpenAI が、AI が生物の実験のデータをどこまで読めるかを測る新しい試験『BioBasicsBench』を出したと、米国の研究開発の専門誌 R&D World が報じている。問うのは教科書の知識ではない。実験で実際に出てくるゲルの写真や顕微鏡の画像を見て、何が起きたかを読み取る力である。最もよかったのは OpenAI の主力のモデル GPT-6 Astra で、正答率は66.7%だったという。ただし、人の研究者が同じ試験を解いた点数も、他社のモデルの点数も示されていない。そのため、この数字だけでは、実験の現場で AI にどこまで任せられるかはまだ言えない。
日本の会社にとって:大半の会社には関係ありません。関係するのは、製薬・食品・化学・受託試験などで、実験の画像やデータの読み取りに AI を使おうとしている研究開発部門です。導入を考えている部門は、この67%を判断の根拠にせず、まず自社の過去の実験画像で、AI の読みと担当者の読みを突き合わせてください。今年度中に始めるなら、その試しを先に計画に入れておくとよいでしょう。いま使っている ChatGPT の法人版などの契約に、変わる点は伝えられていません。
何を測る試験か
これまで、AI の科学の力を測る試験の多くは、教科書や論文に書いてある知識を問う形だった。AI はそうした問題ではすでに高い点を取る。しかし、試薬や細胞を実際に扱う実験(ウェットラボ)の毎日の仕事は、知識を答えることではない。目の前の結果を読むことである。
たとえば、DNA やたんぱく質を大きさで分けるゲル電気泳動では、写真に写った帯の位置と濃さから、狙ったものができたかを判断する。顕微鏡の画像なら、細胞の形や数、染まり方を読む。BioBasicsBench は、こうした実験の生のデータを AI に渡し、正しく読めるかを確かめる作りだと報じられている。R&D World の記事の題によれば、日常的な実験の作業100件にわたる試験だという。
言いかえれば、AI に『生物学を知っているか』ではなく、『実験の助手として結果を見て判断できるか』を聞く試験である。研究の現場で AI を使う話が増えるなかで、測る対象を実務に近づけた点に意味がある。
67%という数字の読み方
最良の GPT-6 Astra でも66.7%ということは、およそ3問に1問は外した計算になる。実験の結果を読み違えると、その後の試薬の注文や次の実験の計画まで、まとめて無駄になりうる。この正答率のまま、人の確認なしに任せられる水準とは言いにくい。
ただ、低いとも決めつけられない。比べる物差しがないからである。報道によれば、試験には人の研究者が解いた基準の点数がない。経験の浅い院生ならどのくらい、熟練の研究者ならどのくらい、という比べ方ができない。もし熟練者でも7割台なら、AI はすでにかなり近いことになる。9割を超えるなら、まだ大きな差がある。どちらなのかは分からない。
他社のモデルも測っていないと伝えられている。Google の Gemini や Anthropic の Claude と比べて、OpenAI のモデルが進んでいるのか遅れているのかも、この試験からは読めない。
OpenAI が自社で作り、自社のモデルだけを測る試験を出すのは、これが初めてではない。11月2日には、育児や家計などの暮らしの課題を測る『LifeVal』を出したが、これも他社のモデルを測っておらず、課題もデータも公開していなかった。BioBasicsBench の課題がどこまで公開され、外の研究者が自分で確かめられるかで、この数字の重みは変わる。
OpenAI の生物の取り組みのなかで
OpenAI は生物の分野に力を入れている。10月30日には、審査を通った組織だけに、生物学向けのモデル GPT-Rosalind-6 を出した。中身は GPT-6 Astra と同じ重みで、デュアルユース(研究にも悪用にも使える)の生物の質問を断る回数を減らした版である。今回、最良の点を取ったのが同じ Astra だったことからすると、BioBasicsBench は、こうした研究向けの製品がどこまで実務の役に立つかを示す材料にもなりうる。
一方で、実験のデータを読む力は、安全の面では注意の要る力でもある。OpenAI 自身は、GPT-6 Astra を土台にした GPT-Rosalind-6 の生物・化学の危険度を、社内の基準で上から2番目の『High』と評価している。BioBasicsBench が測るのは日常の基本的な作業だと報じられており、危険な使い方とは別の話だが、生物の分野で AI の力を測る試験が増えるほど、どこまで公開するかの判断も問われる。
確かめられなかったこと
この記事は報道にもとづいている。OpenAI の発表のページは読めておらず、発表の時刻、課題の正確な数と種類、採点のしかた、GPT-6 Astra 以外のモデルの点数、課題を公開するかどうかは確かめられていない。100件という課題の数も、R&D World の記事の題から取ったもので、本文では確かめていない。
次に見るところ
焦点は3つある。1つ目は、人の研究者の基準の点数が出るかどうか。これがあって初めて、66.7%が実用にどれだけ近いかが分かる。2つ目は、Google や Anthropic のモデルが同じ試験で測られるかどうか。課題が公開されれば、第三者が測る道が開く。3つ目は、OpenAI が近く出すとみられている次のモデル GPT-6.2 Astra で、この点数がどれだけ上がるかである。研究開発の部門にとっては、こうした外の数字を待つあいだも、自社の実験データでの試しが最も確かな物差しになる。