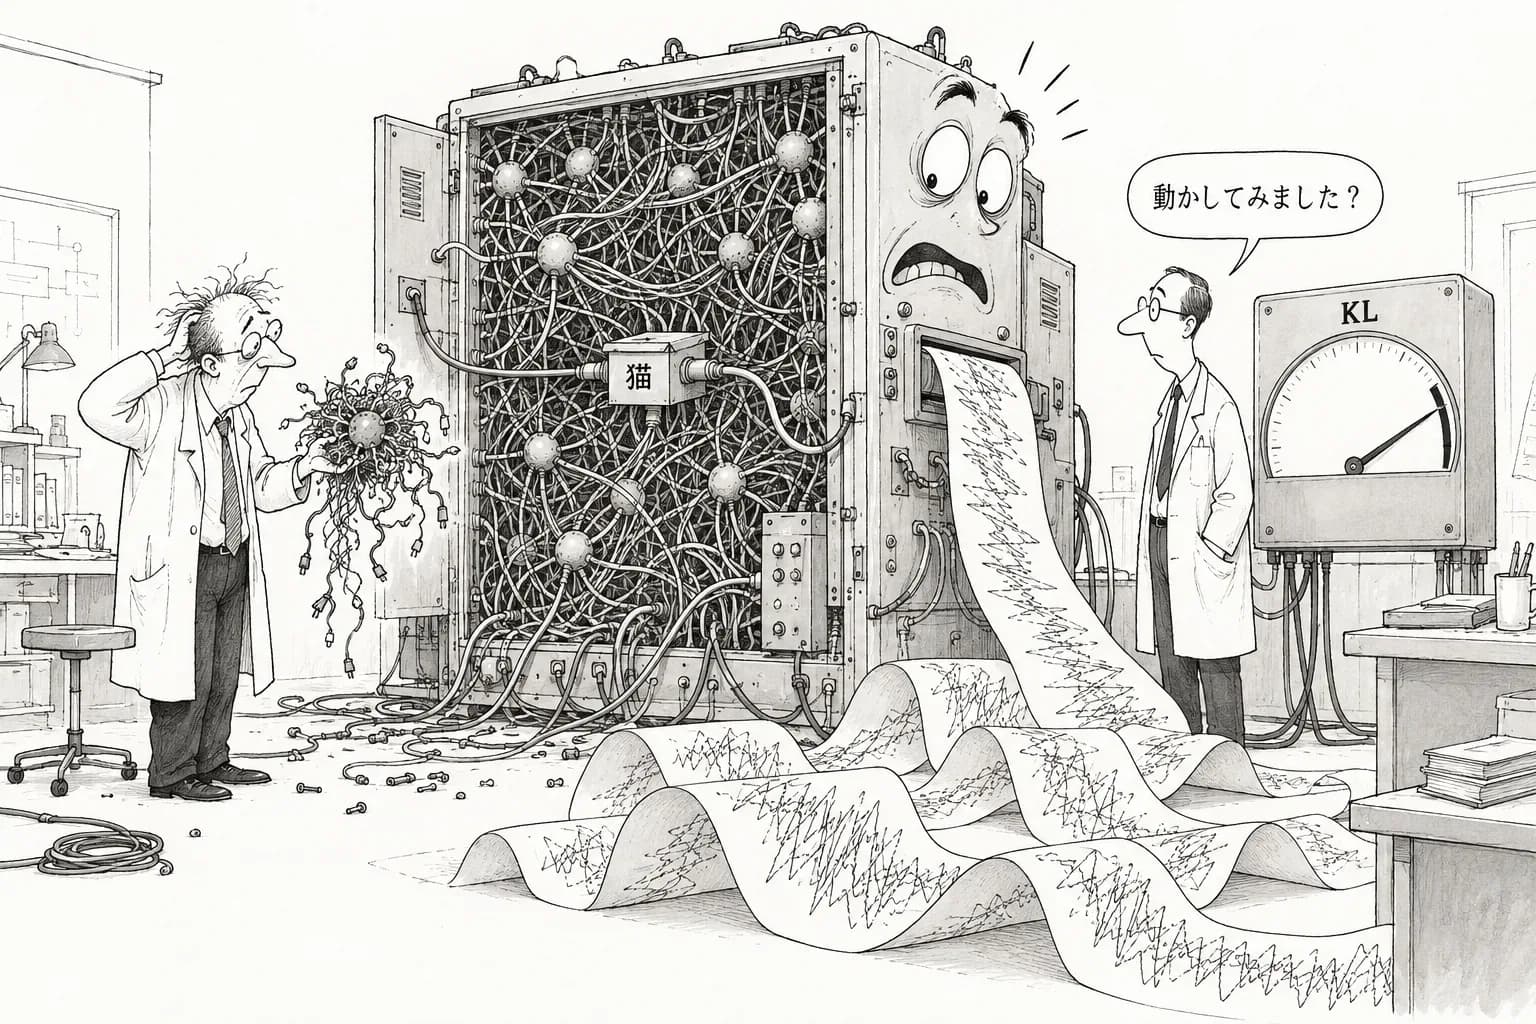
OpenAI で解釈可能性を研究する Leo Gao が、LessWrong に『Neural networks are not already clean』を投稿した(一次情報)。Chris Cammarata の『Already Clean』への反論である。Cammarata の主張は、ニューラルネットの中身はもう人間が読める程度にきれいに整理されている、というものだった。Gao はこれに真正面から逆らってはいない。ニューロンが思われていたより単純だという指摘は認めた。そのうえで、『きれいだ』と言える基準そのものを問い直した。
Neural networks are not already clean
訳: ニューラルネットワークは、まだきれいではない
題名にもなったこの一文は、ニューロンの中身が混沌としているという意味ではない。きれいだと言い切るには、まだ証拠が足りないという意味である。論点は、ネットワークが単純かどうかから、理解したと言うために何を示すべきかへ移った。
認めたこと:ニューロンは思ったより単純だった
Gao は、Cammarata の観察そのものは退けていない。ニューロンを1つずつ見ていくと、人が名前を付けられるものが予想より多い。解釈可能性の研究者の間では、重ね合わせ(superposition)のせいでニューロンはたいてい多義的で読めない、というのが長く通説だった。Gao の譲歩は、少なくともその通説が言うほど悲観しなくてよい、と認めたことになる。
この譲歩には重みがある。Gao が否定しているのは観察ではなく、そこから引き出された結論、つまり『だからもう十分にきれいだ』という部分である。反論は、事実をめぐる争いではなく、測り方をめぐる争いとして組み立てられている。
反論:上位の活性化がラベルに合っても、理解したことにはならない
ニューロンにラベルを付けるときの標準的なやり方は、そのニューロンが最も強く反応した入力を並べ、共通点を探すことである。上位の例がそろって同じ概念を指していれば、それがニューロンの『意味』として記録される。
Gao が問題にしたのはこの手順である。上位の活性化は、ニューロンのふるまいの端の一部にすぎない。ニューロンは、弱い活性化や中くらいの活性化として、はるかに多くの入力に反応している。ラベルが上位の例に合っていても、残りの大部分でニューロンが何をしているかは、ラベルからは分からない。そして、モデルの計算にとっては、その残りの部分も効いている。ラベルが当たっているように見えることと、そのニューロンがモデルの中で果たしている役割を説明できたことは、別のことである。
提案:ニューロンをシミュレーションで置き換え、モデルが劣化しないかをKLで測る
代わりに Gao が出した基準は、操作として定義できるものだ。ニューロンの説明が本当に正しいなら、その説明だけからニューロンの活性化をシミュレートできるはずである。そこで、実際のニューロンをシミュレーションの値に置き換えてモデルを走らせ、元のモデルとの出力分布の違いを KL ダイバージェンスで測る。モデルがほとんど劣化しなければ、説明はそのニューロンの役割を捉えている。大きく劣化するなら、ラベルがどれほどもっともらしくても、理解は足りていない。
この発想には前例がある。OpenAI は2023年に、言語モデルに書かせたニューロンの説明から活性化をシミュレートし、実際の活性化との相関で説明を採点する手法を示していた。Gao の提案は、比べる相手を活性化の相関からモデルの出力へ移すものだと読める。活性化がだいたい合っていても、モデルの答えが変わってしまうなら説明として不十分だ、という立場である。上位の例を眺めるのと違い、この基準はニューロンのふるまいの全域を、しかもモデルの機能にとって重要な度合いで重みづけして評価する。
なぜいま、測り方が問題になるのか
解釈可能性は、もはや学術的な興味だけの分野ではない。今月だけでも、隠れ状態の線形な読み出しで許可のない行動を実行前に予測する研究や、重みの中に能力を隠せることを示す研究が出ている。モデルの内部を読むことは、評価や監視、さらには事案の後の調査の道具として期待されている。
そうした使い方では、『ラベルが付いた』と『理解した』の差がそのまま危険になる。上位の例ではきれいに見えるニューロンが、残りの入力でラベルにない仕事をしているなら、内部を読んで安全だと判断した監査は、その仕事を見落とす。ニューロンが単純に見えるという楽観が、監査の側の油断として広がることを、Gao の反論は警戒している。
『もう十分きれい』か『まだきれいではない』かは、印象で決着がつく問いではない。Gao は、ニューロンを置き換えたときのモデルの劣化という数字で決着をつけようと言った。どちらの陣営も、この基準のもとで自分の主張を確かめ直せる。Cammarata 自身や、ニューロン単位よりも辞書学習の特徴量を重んじる Anthropic の解釈可能性チームが、この土俵に乗って答えるかどうかが次の焦点になる。