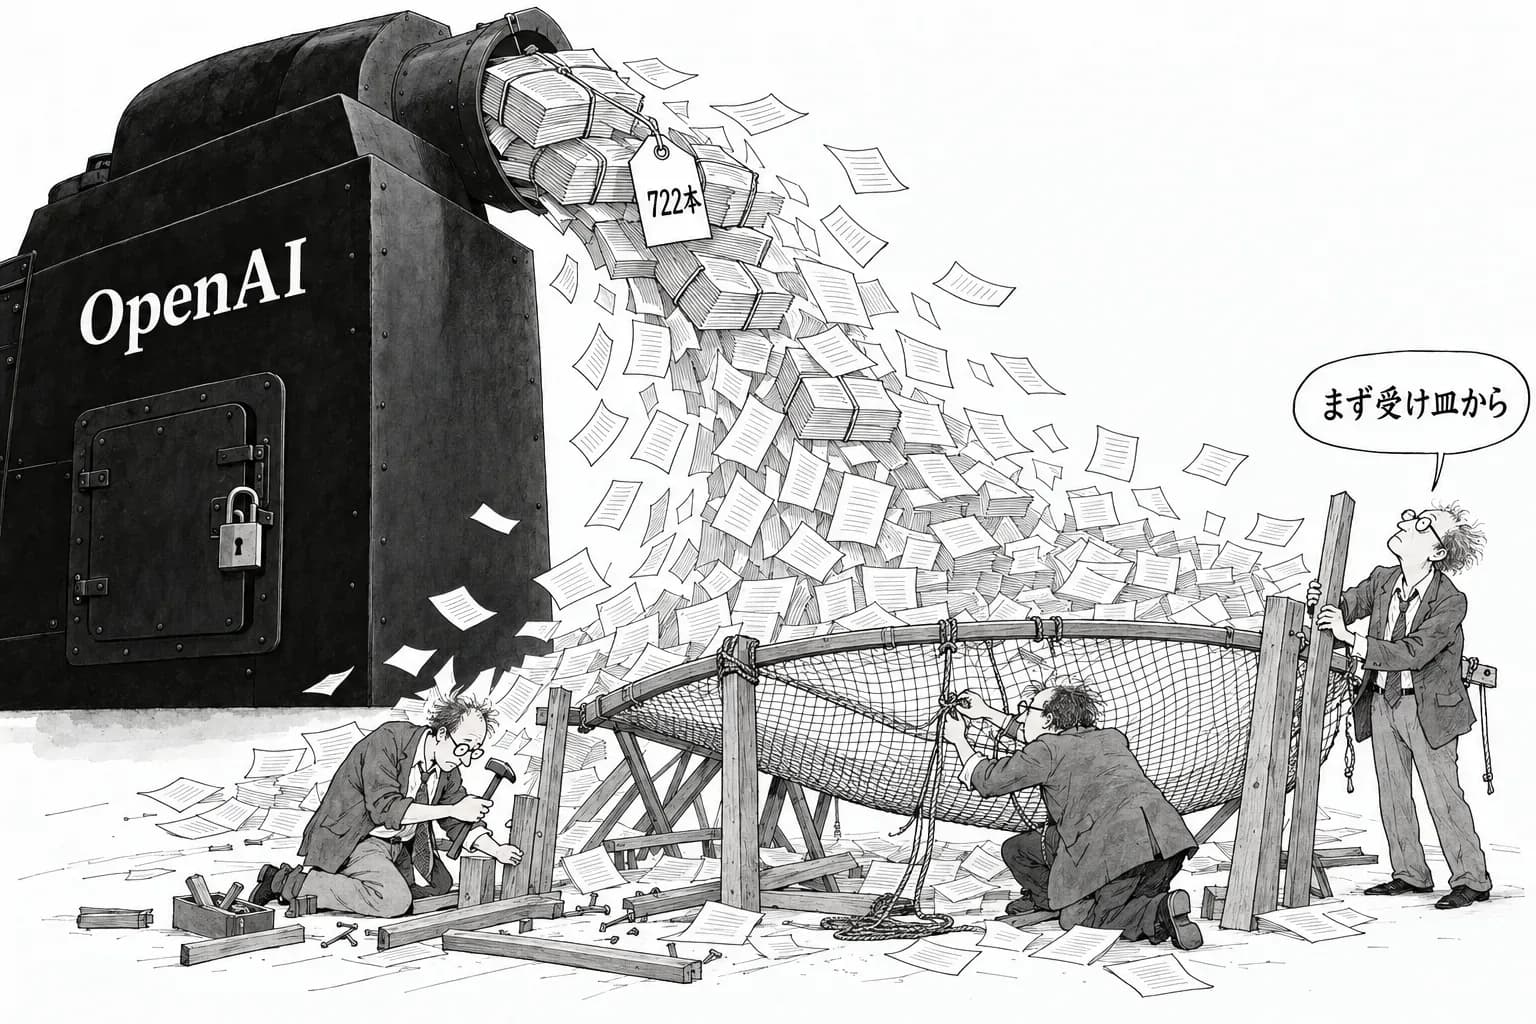
OpenAI が、社内のモデルで作った数学の原稿722本を公開した(OpenAI のブログ、一次情報)。どのモデルを使ったのかは明かしていない。どう作り、どの結果を出すかをどう選び、どこまで検証したのかという手順も、示していない。数学者から出ている批判の中心はここにある。成果が正しいかどうかを論じる以前に、何がどういう経緯で出てきたのかが分からない。そのため数学者たちは、個々の結果を確かめるより先に、結果を受け止めて検証する仕組みを自分たちで作り始めている。
出てきたのは「数」で、「手順」はない
OpenAI は9月上旬にナビエ・ストークス方程式の結果を発表した際、社内モデルが数学の100件を超える未解決問題を片付けたと述べていた。今回の722本は、それを原稿という形でまとめて外に出したものである。Scientific American は、すでに衝撃を受けている数学の分野に、さらに数百の結果が流し込まれたと報じている。
ただし公開されたのは成果物だけである。モデルの名前、使った計算資源、採用しなかった試みの数、人間がどの段階で手を入れたかは書かれていない。ナビエ・ストークスのときには、OpenAI は約1万のエージェントが88時間動いたという規模を自ら明かしていた。今回はそれもない。数学では、結果が正しいかどうかに加えて、どういう方法で得たかが評価や引用の土台になる。手順が分からなければ、原稿を1本ずつ読む人は、それが全体のなかで選び抜かれた一部なのか、それとも代表的な一部なのかを判断できない。
反応の温度差も大きい。経済学者の Tyler Cowen(ジョージ・メイソン大学)はブログ Marginal Revolution で、短くこう書いた。
OAI doing math again
訳: OpenAI がまた数学をやっている
この「また」という一言に、受け止め方の変化が表れている。ナビエ・ストークスのときは驚きをもって迎えられたが、数百本の原稿がまとめて出てくることが、すでに繰り返し起きる出来事として扱われ始めている。一方で、数を受け止める側の作業量は減っていない。むしろ増えている。Gary Marcus も今回の公開について論評を出しており、ニュースレターの AINews もこの件を取り上げた。
批判は「正しいか」より「どう作ったか」に向いている
数学者の批判は、OpenAI の結果が誤りだという主張ではない。ナビエ・ストークスの証明についても、技術的には正しいというのが大方の見方だった。問題にされてきたのは、検証できる形で出されているかどうかである。Martin Hairer は9月、AI 企業が出す数学の成果を「受け入れ可能な数学的慣行に遠く及ばない」と書いた。ブラウン大学の Javier Gómez-Serrano は、ナビエ・ストークスの論文を「人間向けに書かれていない」と評した。
722本という数は、この問題を大きくする。1本の重い証明なら、専門家が時間をかけて読み込める。数百本となると、どれを優先して読むかを決めるだけでも情報が要る。どのモデルが、どれだけの試行の中から、どういう基準で選んだ結果なのか。その情報がなければ、検証の手間をどこに割くかを決められない。
数学者は先に「受け皿」を作っている
そこで数学者の側は、個々の結果を判定する前に、結果の受け止め方そのものを作り直している。この数週間の動きは、どれもその方向を向いている。
Erdős 問題のサイトは窓口を閉め、手柄の扱いを変えた
10月6日、Terence Tao のブログに Thomas Bloom のゲスト投稿が載った。Erdős 問題のサイトは、AI が作った説明のない証明が、先取権を主張するために投稿される場になっていた。そこで問題ごとの新しいコメントを止め、投稿はメールで受けることにした。解決数の集計もやめ、結果を解いた人(人間か AI か)の手柄にしない。代わりに、人間が読める解説と、リンクした Lean の証明を重んじる。結果を受け止めて記録する入り口を、AI の出力の量に合わせて作り替えたことになる。
AGMAI は「公開のしかた」への助言から始まった
9月に立ち上がった数学と AI の諮問グループ AGMAI は、OpenAI から外部の諮問委員会を作らないかと打診されたが、それを断って独立した組織として作られた。最初の任務は、結果の検証ではない。OpenAI が社内モデルで得たと報告している多数の結果を、どう公開調整するかへの助言である。今回の722本は、まさにその対象にあたる。ただし AGMAI の憲章には、検証の方法は書かれていない。OpenAI も、社内の進捗のペース配分は助言の対象外だとしている。
検証できる環境と、計算資源の透明性を求める声
国際産業応用数学評議会(ICIAM)は9月24日付の声明で、誰でも検証できる環境、使った計算資源の透明性、公平な利用機会を求めた。今回 OpenAI が示していないのは、まさにこの計算資源と手順の部分である。Amit Sahai は、AI の結果を人間が確かめられるよう、数学者を「いつでも動員できる知的な予備役」として厚く育てるべきだと論じた。ハーバードでは、AI 時代の数学の博士教育をテーマにしたサミットも開かれている。Tao のブログでは、その後も AI と数学をめぐる投稿が続いている(10月6日、10月7日)。
検証の費用を誰が負うのか
こうした動きに共通するのは、出す側が手順を明かさない分、受け止める側がその穴を埋める仕組みを作っているという構図である。Lean による形式化、人間が読める解説の重視、投稿の窓口の制限、査読する人材の育成は、どれも数学者の時間と制度の側の費用として積み上がる。
OpenAI は722本を公開したが、それらの結果を数学の知識としてどう位置づけるかという作業は、数学の共同体に任されたままになっている。モデルの名前と作り方が示されない限り、数学者は今後も、結果の真偽より先に、それを受け止める仕組みのほうに手間をかけ続けることになる。