NVIDIA は10月15日、マルチモーダルのモデル Nemotron 3.5 Super VL の重みを公開した。同じ日に、もっと小さい Bolt 74B-A9B も出した。第三者の評価機関 Artificial Analysis は、Super VL に Intelligence Index で26点を付けた。公開した時点では、米国のオープンウェイトで最も高い点である。出力も毎秒約630トークンと速い。
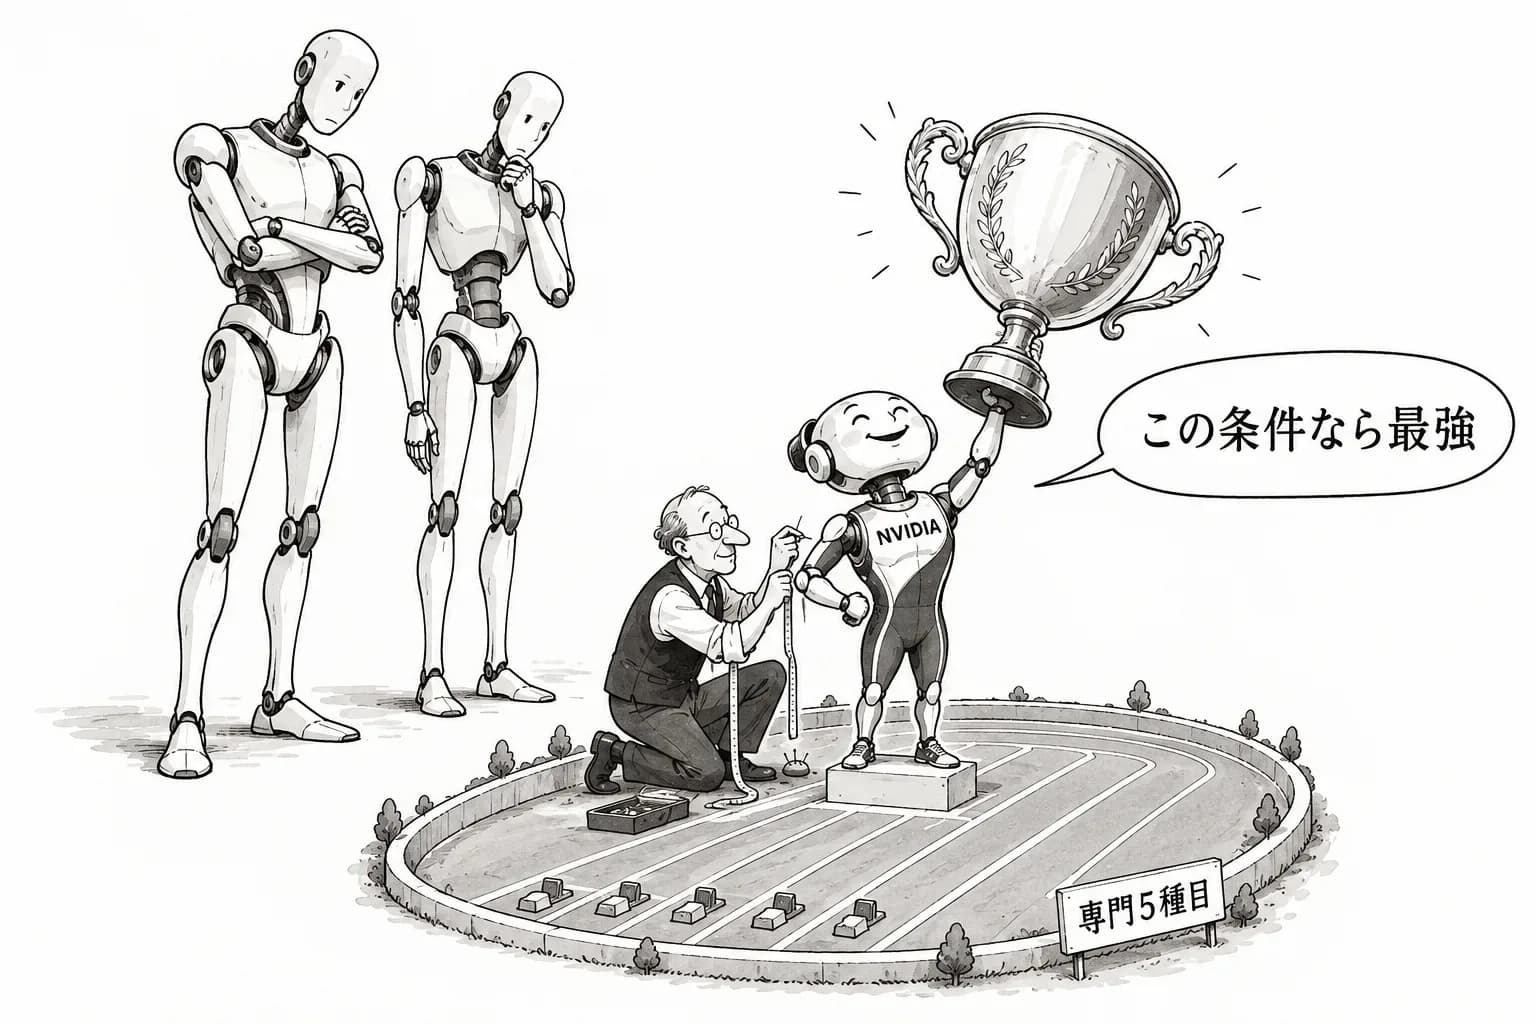
ただし、報道の見出しになった『Claude Opus 5 や GPT-6.1 Sol を上回った』という数字には条件がある。利用企業が自社のデータで追加学習した後に、5つの専門的なタスクで測ったものに限られる。この記事では、第三者が測った素の実力と、NVIDIA の見せ方とを分けて読む。
何が出たのか
NVIDIA の公式ブログと開発者向けのブログ(いずれも一次情報)によれば、Nemotron 3.5 Super VL は総120B・アクティブ12B のモデルである。Mamba と Transformer を混ぜた作りで、画像も読める。文脈は100万トークンまで扱える。
Bolt 74B-A9B も同じ日に重みが出た。さらに小さい Bolt E4B は、10月23日に出す予定である。NVIDIA がこのモデル群に付けた題は『専門のエージェントを動かす』で、汎用のチャットの首位を狙ったものではない。まずこの点を押さえておきたい。
第三者の点数は26。米国のオープンウェイトでは公開時点の首位
Artificial Analysis は、公開と同じ日に評価の記事を出し、次のように書いた。
Nemotron 3.5 Super VL is the highest-scoring open weights model from the US, at 26 on the Intelligence Index. It edges out Thinking Machines' Inkling Small (26) and passes NVIDIA's previous flagship, Nemotron 3 Ultra (23), and Meta's Muse Glimmer (17).
訳: Nemotron 3.5 Super VL は Intelligence Index で26点を取り、米国のオープンウェイトで最も高い。Thinking Machines の Inkling Small(26)をわずかに上回り、NVIDIA の前の旗艦 Nemotron 3 Ultra(23)と Meta の Muse Glimmer(17)を抜いた。
これは、NVIDIA の自己申告ではなく第三者が測った点数である。前の Nemotron 3 Super は13点だったので、倍に上がった。前の旗艦の Nemotron 3 Ultra(23)も上回った。総120B という大きさで、米国勢の同じ規模のモデルの中ではっきり前に出たといえる。
ただし『米国首位』は1日しか続かなかった。Artificial Analysis は翌10月16日、Meta の Muse Spark Open に39点、Reflection AI の Beam に30点を付けた。米国のオープンウェイトの首位は Muse Spark Open に移り、Nemotron は3位に下がった。とはいえ、Muse Spark Open は総816B・アクティブ42B、Beam は総501B・アクティブ23B である。どちらも Nemotron の4倍以上の大きさで、比べる土俵が違う。Nemotron の強みは小ささと速さにある。
国の外にも目を向けておく。中国勢のオープンウェイトの首位は、MiMo-V2.6-Pro の46点と DeepSeek V4.1-Flash-1017 の45点である。閉じたモデルでは、Claude Opus 5 が51点、GPT-6.1 Sol(max)が52点、Opus 5.5 が58点である。汎用の点で見れば、Nemotron 3.5 Super VL はフロンティアの半分ほどにとどまる。
毎秒約630トークンという速さ
Artificial Analysis の記事によれば、出力の速さは毎秒約630トークンである。同じ機関が測った Muse Spark Open は毎秒118トークンなので、およそ5倍になる。アクティブのパラメータが12B と小さいことと、Mamba を混ぜた設計が、速さと長い文脈を両立させる狙いとみられる。
エージェントの仕事では、1つの課題のために何十回もモデルを呼ぶ。そのため、1回の答えの質より、呼ぶたびの速さと値段が全体の費用を決める場面が多い。課題ごとに安くて速いモデルを選ぶ『AIトークノミクス』の考え方からすると、この速さは点数以上に効いてくる。
『Opus 5 超え』は、どんな条件の数字か
VentureBeat の記事(二次情報)は、見出しで『追加学習をした Nemotron 3.5 Super VL が、専門タスクのベンチマークで Claude Opus 5 と GPT-6.1 Sol を上回った』と書いた。注意すべき点は3つある。
1つ目は、比べたのが追加学習の後のモデルだという点である。利用企業が自社のデータで鍛え直した後に測った数字で、ダウンロードしたばかりの素の Nemotron の点ではない。素のモデルの汎用の実力は、先に見た26点のほうである。
2つ目は、測ったのが5つの専門的なタスクだけだという点である。狙った狭い仕事に合わせて鍛えたモデルが、その仕事で汎用の大きなモデルに勝つことは珍しくない。この結果から『Opus 5 より賢い』とは言えない。
3つ目は、比べ方が NVIDIA の側の発表に基づいている点である。この5つのタスクでの勝ち負けを、第三者が同じ条件で測り直した結果はまだない。
そのうえで、この数字には実務上の意味もある。Opus 5 や GPT-6.1 Sol は重みが公開されておらず、利用企業が手元で追加学習することはできない。重みを持てるオープンウェイトなら、自社のデータで鍛え直し、狭い仕事では大きなモデルに並ぶところまで持っていける。NVIDIA の発表は、その使い方を示したものと読むのが正確である。
どう読むか
今回の発表は、2つの数字に分けて読む必要がある。第三者が測った汎用の点数26は、米国の同じ規模のモデルでは強いが、フロンティアの半分ほどにとどまる。一方、『Opus 5 超え』は、企業が自社データで鍛え直した後に、5つの課題に限って出た数字である。毎秒約630トークンの速さと、自社で鍛え直せる重みを組み合わせて、狭い仕事向けのエージェントを安く速く作る。NVIDIA が売ろうとしているのはこの使い方で、汎用の頭のよさで首位に立ったわけではない。
次の確認点は、10月23日に出る予定の Bolt E4B と、この5つの専門タスクでの比較を第三者が測り直すかどうかである。