何が出たか
中国のラボ Nanbeige が、Nanbeige4.3-33B の重みを Hugging Face に出した。パラメータは33B で、MoE ではない密なモデルである。ライセンスは Apache 2.0 で、商用でも使える。リポジトリの更新履歴にアップロードの記録がある。
この1か月に出たオープンウェイトの大型モデルは、ほとんどが MoE だった。Meta の Muse Spark Open は総816B・アクティブ42B、Reflection AI の Beam は総501B・アクティブ23B、MiniMax の M3.1 Flash は総約428B・アクティブ23B である。どれも、1トークンごとに動くのは全体の一部だけだ。Nanbeige はその流れから外れ、33B すべてが毎回動く密な形をとった。
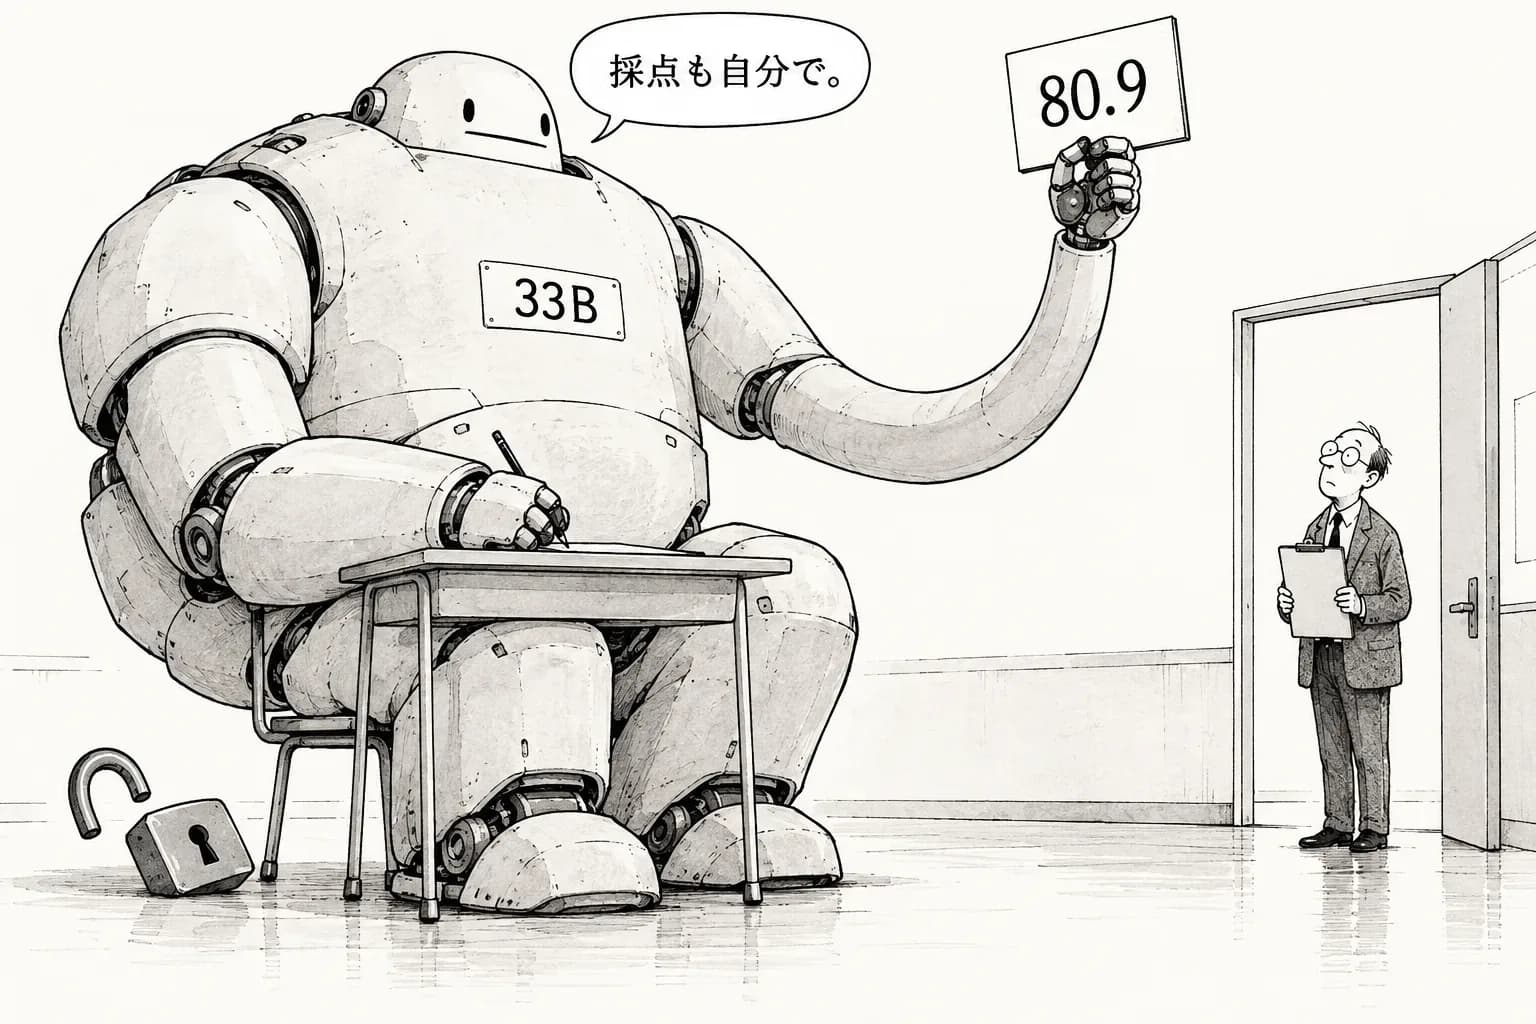
自社の数字:Terminal-Bench 2.1 は80.9
モデルカードの自己申告では、Terminal-Bench 2.1 が80.9である。Nanbeige は、同じくらいの大きさのオープンなモデルを、ほとんどの項目で上回るとしている。
同じベンチマークの既報の数字と並べると、この数字の大きさが分かる。どれも各社の自己申告である。
・Reflection AI の Beam(総501B・アクティブ23B)は80.1%(VentureBeat の報道、二次情報)。
・Meta の Muse Spark Open(総816B・アクティブ42B)は76.4(Meta のモデルカード)。
・Recursive の Flint(総40B・アクティブ約2.5B)は54.9%(自社の数字、二次情報)。
そのまま受け取れば、33B の密なモデルが、総パラメータが15〜25倍ある MoE と同じ水準に並んだことになる。ただし、ハーネス、試行の回数、時間の制限といった測り方は、社ごとにそろっているとは限らない。違う会社の自己申告の数字を並べても、順位を決めたことにはならない。
第三者の評価はまだない
この記事を書いた時点で、Artificial Analysis、Arena、Epoch などの第三者は、まだこのモデルに点数を付けていない。自社の数字と第三者の数字は、ずれることが多い。Anthropic は Haiku 5.5 の Terminal-Bench 4.0 を39.2%と申告したが、Artificial Analysis が測ると33%だった。Beam は、自社の数字では強かった一方で、Artificial Analysis の Terminal-Bench 4.0 では3.0%にとどまった。Terminal-Bench 2.1 の80.9が、別の測り方や新しい版のベンチマークでも保てるかは、まだ分からない。
確かめるべき点
密な33B なら、1つのリクエストで動く計算は、上に挙げた MoE のアクティブパラメータ(23〜42B)とほぼ同じになる。一方で、重みの全体は MoE よりずっと小さい。量子化すれば少ないアクセラレータに載せられ、手元で動かしたり追加学習したりする用途には向く。自社の数字が本物なら、ハーネスエンジニアリングを試す開発者にとって、扱いやすい選択肢が増える。
ここから見るべき点は3つある。Artificial Analysis の Intelligence Index と、自前で測った Terminal-Bench の数字が出るか。オープンウェイトの上位にいる DeepSeek V4.1-Flash-1017(45)や、11月4日までに重みが出る予定の Kimi K3.1 Pro(55)と比べてどうか。そして、安全の評価をどこまで出すか。Epoch AI は10月16日、オープンウェイトのサイバー能力は閉じたモデルより6〜7か月遅れていると見積もった。コーディングのエージェントとして強いモデルが Apache 2.0 で出れば、守る側にも攻める側にも同じように届く。いまのところ、手元にあるのは Nanbeige 自身の数字だけである。