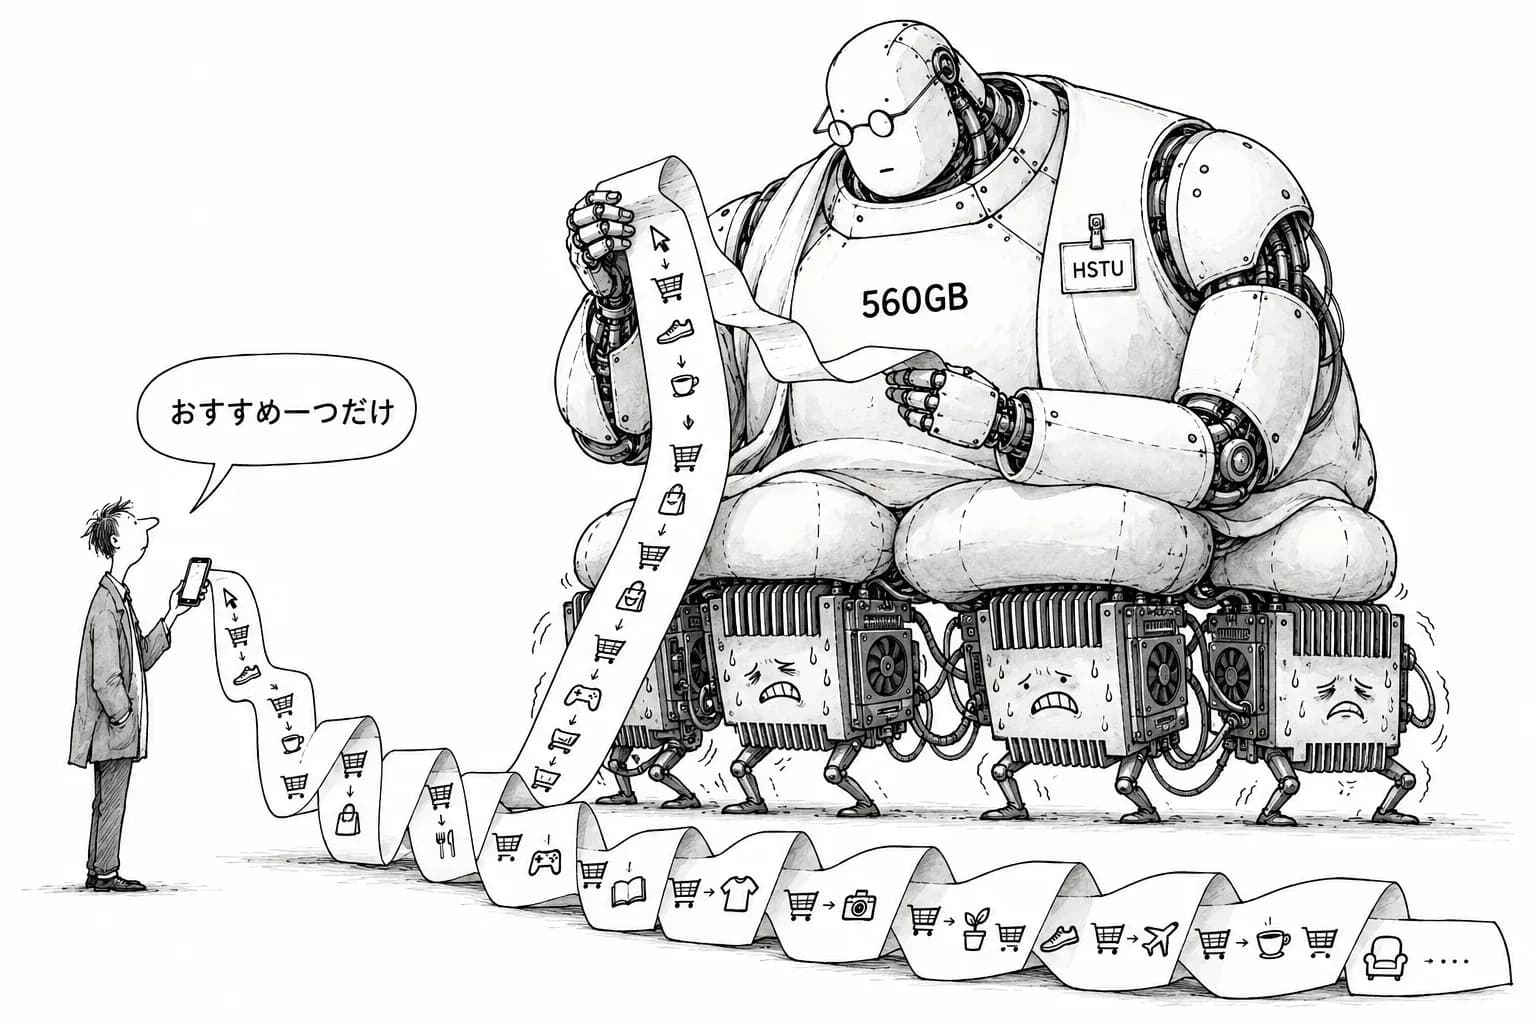
MLCommons は10月1日、業界標準のベンチマーク MLPerf Training の推薦モデルのテストを、DLRMv4 に改めると説明した(MLCommons のブログ、一次情報)。これまでの DLRM は、利用者と商品の特徴をまとめ、それらを掛け合わせて推薦を出す設計だった。DLRMv4 はこの部分を、利用者の行動履歴をそのまま系列として読む HSTU に置き換える。その結果、ベンチマークで測る中身も変わる。埋め込みだけで560GBあり、複数のアクセラレータに分けて載せる「生成型推薦」の負荷になる。
記事は MLCommons の DLRMv4 タスクフォースが書いた。Chris Cai、Linjian Ma、Nan Zhang、Haolei Pei らで、AMD、Meta、NVIDIA、ByteDance の共同執筆である。推薦を大規模に動かす事業者と、その計算基盤を売る半導体企業が、一緒にものさしを作り直したことになる。
何が替わるのか——特徴の掛け合わせから、履歴の系列へ
タスクフォースは、まず本番の現場がすでに変わったと書いている。
production recommendation systems at hyperscale operators have shifted from compressing user behavior into a small set of aggregated dense features to representing each user's recent interaction history as a per-event token sequence.
訳: ハイパースケール事業者の本番の推薦システムは、利用者の行動を少数の集約済み密特徴に圧縮するやり方から、直近の操作履歴を1回の操作ごとのトークン列として表すやり方へ移った。
旧来の方式は、ある利用者が直近にどの動画を見て、どの商品を買ったかを、少数の数値にまとめてしまう。まとめた特徴を掛け合わせ、クリックの確率を出す。一方で新しい方式は、1回の操作を1つのトークンとして扱う。言語モデルが文章を読むのと同じように、履歴を順番どおりに読む。順序や間隔といった情報を、まとめる段階で捨てずに済む。
この新方式の中心が HSTU である。タスクフォースはこう説明する。
DLRMv4 fills that gap by replacing the feature-interaction stack with HSTU, a transducer that reads a user's interaction history directly as a sequence
訳: DLRMv4 はこの差を埋めるため、特徴交差の層を HSTU に置き換える。HSTU は利用者の操作履歴をそのまま系列として読むトランスデューサーである。
ここで「この差」と呼んでいるのは、本番で動いている推薦と、ベンチマークが測っている推薦とのずれのことだ。MLPerf の推薦テストが旧来の特徴交差型のままでは、点数が良くても、事業者が実際に回している負荷での速さを示さない。DLRMv4 は、ものさしを現場に合わせ直す改訂である。HSTU は、Meta の研究者が2024年に「生成型推薦」の土台として発表した構造だ。
なぜ今か——計算を足すほど伸びる
切り替えの理由として、タスクフォースはもう1点を挙げる。規模を大きくしたときの伸び方である。
Models built this way keep improving as compute and parameters grow, while earlier feature-interaction designs flatten out.
訳: この方式のモデルは計算量とパラメータを増やすほど性能が伸び続ける。以前の特徴交差型の設計は頭打ちになる。
LLM で見慣れた、計算量とパラメータを増やすほど性能が伸びる性質が、推薦でも系列型にすると表れるという主張だ。特徴交差型は、どこかで頭打ちになる。事業者がこれから推薦にかける計算資源を増やしていくなら、伸び続ける方式を基準に据えるのが自然になる。ベンチマークの改訂は、推薦が「計算をつぎ込むほど得をする」分野へ移ったことを、業界の共同作業として認めた形でもある。
560GB の意味——1台に載らない負荷を測る
見出しの数字は、ハードウェアの読者にとって最も重い点である。DLRMv4 は、埋め込みだけで560GBある。現在のアクセラレータ1基のメモリには収まらない。そのため、埋め込みの表を複数のアクセラレータに分けて載せることが前提になる。
推薦の学習では、計算そのものよりも、巨大な埋め込みの表から必要な行を引いてくる処理が重くなりやすい。表を分けて載せれば、どのアクセラレータがどの行を持つかを決め、ほかのアクセラレータに問い合わせる通信が生じる。テストの成績は、演算の速さだけでは決まらない。メモリの容量、メモリの帯域、アクセラレータ間をつなぐ回線の太さ、表の分け方を決めるソフトウェアの出来が、そろって点数に表れる。
そこに、系列を読む HSTU の計算が加わる。履歴が長ければ、注意機構に似た計算が増えていく。つまり DLRMv4 は、埋め込みを引く負荷と、トランスフォーマーに近い系列の計算を、1つのテストで同時に問う。LLM の学習でも推論でもない、生成型推薦という第3の負荷を、名前の付いた形で測ることになる。
誰にとっての改訂か
共同執筆の顔ぶれには意味がある。Meta と ByteDance は、系列型の推薦を本番で大規模に回す側である。AMD と NVIDIA は、それを動かすアクセラレータを売る側である。今後の MLPerf の結果で、推薦の欄の数字は、どの社のシステムがハイパースケールの推薦を速く学習できるかを示す材料になる。各社のシステムが560GBの埋め込みをどう分け、どれだけの台数で回すのかが、比べどころになる。
ただし、この記事で確かめられたのは、方式の切り替え、HSTU の採用、埋め込みの規模、複数のアクセラレータに分けて載せる前提までである。どの回の MLPerf Training から正式に使うのか、品質の目標値、データセットの中身、各社の最初の提出結果は、今後の公表を待つ必要がある。MLCommons の Insights のページに続報が載るかを追う。