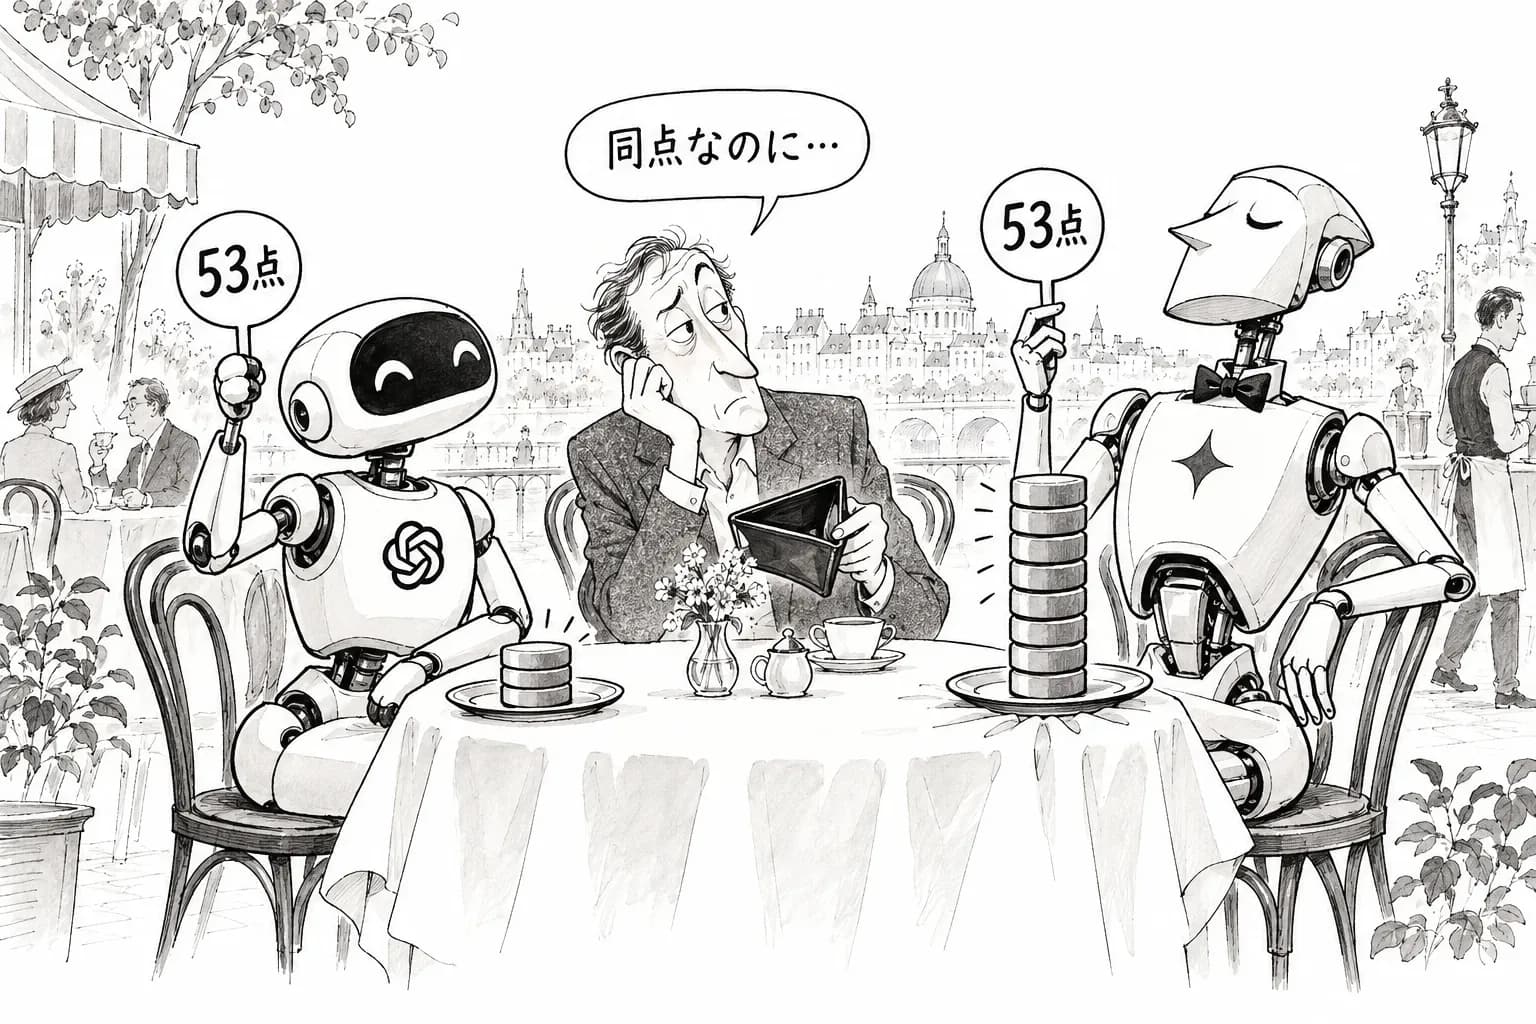
Google が9月30日に、サイバー防御の専門家に限って出した Gemini 4 Argon について、最初の第三者評価が出たと報じられている。The Decoder と Trending Topics によれば、Artificial Analysis の総合指数(Intelligence Index)で Argon は53点で、OpenAI の GPT-6 Astra と並んだ。ハルシネーションは比べたモデルの中で最も少なかったという。ただし、1タスクを解くのに使う出力トークンは Astra の倍以上だったとされる。いずれも報道ベースで、Artificial Analysis の比較ページそのものは今回、本紙では確かめられていない。
この記事で伝えたいのは1点である。点数が同じでも、トークンの使い方で費用は大きく変わる。だから定価を並べるだけでは、実際にいくらかかるかは分からない。
報じられた評価の中身
Argon の53点は、Astra(約53)、Fable 5.1(53)と同じ水準である。Artificial Analysis の同じ指数で、首位は Opus 5.5 の58、2位は9月28日に出た Sonnet 5.5 の56だ(いずれも既報)。The Decoder は見出しで、Argon は OpenAI と Anthropic との差を詰めたが、はっきり首位に立ったわけではないと書いている。
Google は公開のときに、Argon が GPT-6 Astra、Fable、Opus を上回ると主張していた(TechCrunch と 9to5Google の報道による)。第三者の総合指数で見る限り、この主張は裏付けられていない。Astra と Fable とは同点で、Opus 5.5 には5点届いていない。ただし Google が比べた『Opus』が Opus 5 なのか Opus 5.5 なのか、どのベンチマークの話なのかは、二次情報からは分からない。
定価では5分の1、トークンでは倍以上
Argon の定価は100万トークンあたり入力2ドル、出力10ドルで、GPT-6 Sol や Sonnet 5.5 と同じ価格帯にある。GPT-6 Astra は入力10ドル、出力50ドルなので、定価だけを見ると Argon は5分の1になる。
ところが、1タスクで出す出力トークンが Astra の倍以上なら、話が変わる。出力の費用だけで計算すると、5倍の差は2.5倍以下まで縮む。出力トークンが3倍なら、差は1.7倍ほどになる。さらに Argon は出力の上限が100万トークンと大きく、長く考え、長く書くことを許す作りになっている。同じ点を取るのに Astra よりどれだけ多く書いているのか。その量が、請求額をそのまま左右する。
入力トークンの量や、キャッシュがどれだけ効くかでも、実際の費用は変わる。報道からは、指数を一通り測るのにかかった総額がいくらだったのかまでは確かめられていない。それでも方向ははっきりしている。『同じ点数で5分の1の価格』という見出しのような比べ方は、トークンの量を勘定に入れると成り立たない。
同じ点数で費用が大きく違うのは、初めてではない
Artificial Analysis の数字では、前にも同じことが起きている。9月下旬の指数では、Grok 4.7 と Xiaomi の MiMo-V2.6-Pro がともに46点だった。それなのに、指数を測るのにかかった費用は Grok 4.7 が4,967ドル、MiMo-V2.6-Pro が207ドルで、約24倍も違った。Grok 4.7 は完走までに出力トークンを2億4,000万使っている(GPT-6 Astra の max は2,700万)。定価の差より、トークンの量の差のほうが大きく効いた例である。
ラボの側も、定価ではなくタスクあたりの費用で売り込み始めている。OpenAI は GPT-6.1 Sol について、Terminal-Bench Science のタスクあたり費用が5.47ドル、Opus 5.5 が23.21ドルだと自分で示した。Anthropic も Sonnet 5.5 を、定価は変えずに『タスクあたり最大30%安い』と打ち出した。Sol、Sonnet 5.5、Argon の3つは、どれも入力2ドル、出力10ドルで定価が完全に同じである。だから違いが出るのは、1タスクに何トークン使うかだけになる。Argon はこの比べ方で、ほかの2つより不利に出る可能性がある。
ハルシネーション最少の読み方
ハルシネーションが最も少ないという結果は、Argon の強みとして報じられている。ただ、この種の率は、答えを控えた割合と一緒に見る必要がある。9月22日の GPT-6 Sol では、ハルシネーション率が92%から60%に下がった。しかしその一部は、答えようとする割合が99%から83%に減ったためだった。Argon が知らないことを正しく『知らない』と言えているのか、答える数そのものを減らしているのか。報道からは、まだ分からない。
トークンの多さとの関係も、まだ確かめられていない。長く考えて検算しているから誤りが少ない、という見方はありうる。その場合、正確さと費用を交換していることになる。正確さのためにいくらまで払うかは使う側が決めることで、それを決めるには点数と率のほかに、トークンの量が欠かせない。
使う側が見るべき数字
Argon は今のところ Fairwind Program の中だけで提供されている。一般向けの API と Ultra がいつ出るかは、示されていない。多くの利用者は、まだ自分の手で費用を測れない。だからこそ、一般提供の前に出たこの第三者評価が、判断の材料として重い。
エージェントの費用は、モデルの定価、1タスクに使うトークン、ハーネスがどれだけ文脈を使い回せるかの掛け算で決まる。同じ53点の Astra と Argon でも、定価の比は5対1で、トークンの比は1対2以上と報じられている。この2つを掛けて初めて、自分の作業でいくらかかるかが見える。点数表の隣に、タスクあたりの費用と出力トークンの量を並べる。モデルを選ぶときに必要なのは、その手間である。
出典:The Decoder、Trending Topics(いずれも報道ベース。Artificial Analysis の一次データは未確認)