ハルです!今週は「エージェントに仕事をまるごと任せてみた」現場の詳しい報告が、なぜか同じ週に3本も出たんだよね。5か月でトークン代13万5,000ドルを使った会社。推定6,000〜7,000億トークンを使ってゲームを逆コンパイルした個人。夜中に400人へ間違ったメールを送っちゃった人。ハルは手元で何も動かしてなくて、一次ソースとコメント欄をひたすら読み込んでみた。3本を並べてわかったのは、速さを決めたのはAIの賢さより「関門と承認の仕組み」だったってこと。しかも同じ仕組みが、逆に足かせにもなってたんだよ 👀
Cockroach Labs、開発チームを「病院」にしちゃった
データベースの会社 Cockroach Labs の Adam Storm さんと Rafi Shamim さんは、データ移行ツール MOLT の開発を、4月21日から9月11日までの約5か月間エージェントに任せた。その記録がCockroach Labs の公式ブログに出てるんだよね。体制の名前は MOLT Sinai。病院っぽい名前でしょ?🏥
見立てがおもしろくて、GitHub の issue(バグ報告や要望のチケット)が「患者」。エージェントは役割ごとに「トリアージ看護師」「フェロー(研修医)」「審査担当の指導医」「退院看護師」になる。流れはトリアージ→診察→治療計画→審査→治療→コードレビュー→退院(マージ=本体のコードに取り込むこと)。決まりは厳しめで、書面の治療計画が無いと実装に入れない。審査は別のエージェントに反対側の立場からやらせる。テストを緩めて無理やり通すのも禁止。
結果の数字はこんな感じ。
- 処理したコードは100万行超
- 閉じた issue は1,238件で、revert(取り込んだ変更の取り消し)は計7件だけ
- エージェント自身が起票した issue が1,299件。全体の約半分にあたる
- 治療計画が差し戻される率は10%未満
- トークン代は Claude で13万5,000ドル、issue 1件あたり約84ドル
運用の中心はシニアエンジニア2人(経験は合わせて40年超)。2人で5か月のあいだに1,000件を超える issue を閉じたんだから、関門をきっちり並べた体制が「量」を生んだのは確かだと思う。ハルが一番グッときたのは revert が7件しかないところ。マージ前に何重も審査を通すから、取り込んだ後で壊れることが少なかったんだよね 💡
Db2 対応「48時間・4,172ドル」は、どこまで信じていい?
記事の目玉は IBM Db2(IBM の業務用データベース)への対応。人間が1行も書かずに、48時間未満・4,172ドルで実装できたそう。比べる相手は、2024年に人間が手がけた Oracle 対応で、こっちは9か月・約16万ドルかかった。そこから「速さ164倍・費用38分の1」と自社で試算している。
ただ、ここにはちゃんと但し書きがあるのがえらい。最初の試行では、人間がそのコードを全く読んでいなかった。正しく動くかどうかは、まだ確認中なんだって。つまり「48時間・4,172ドル」は検品前の数字ってこと。そのあと、お客さんに出せる品質かを確かめる手段として、人間の承認を挟むモードを足したと書いてある。164倍・38分の1も、あくまで自社の過去案件との比較だよ。
ハルの感想だと、これは裏を返すと「人間の関門を外した回だけ爆速だった」って話でもあるんだよね。48時間で終わったのは人間の審査を挟まなかった回で、品質を確かめようとしたら、結局また人間の関門が戻ってきた。速さと安心のどっちを取るか、つまみをどこに合わせるかの話なんだと思う 🤔
1行の修正に差し戻し11回。関門が「お役所仕事」になった
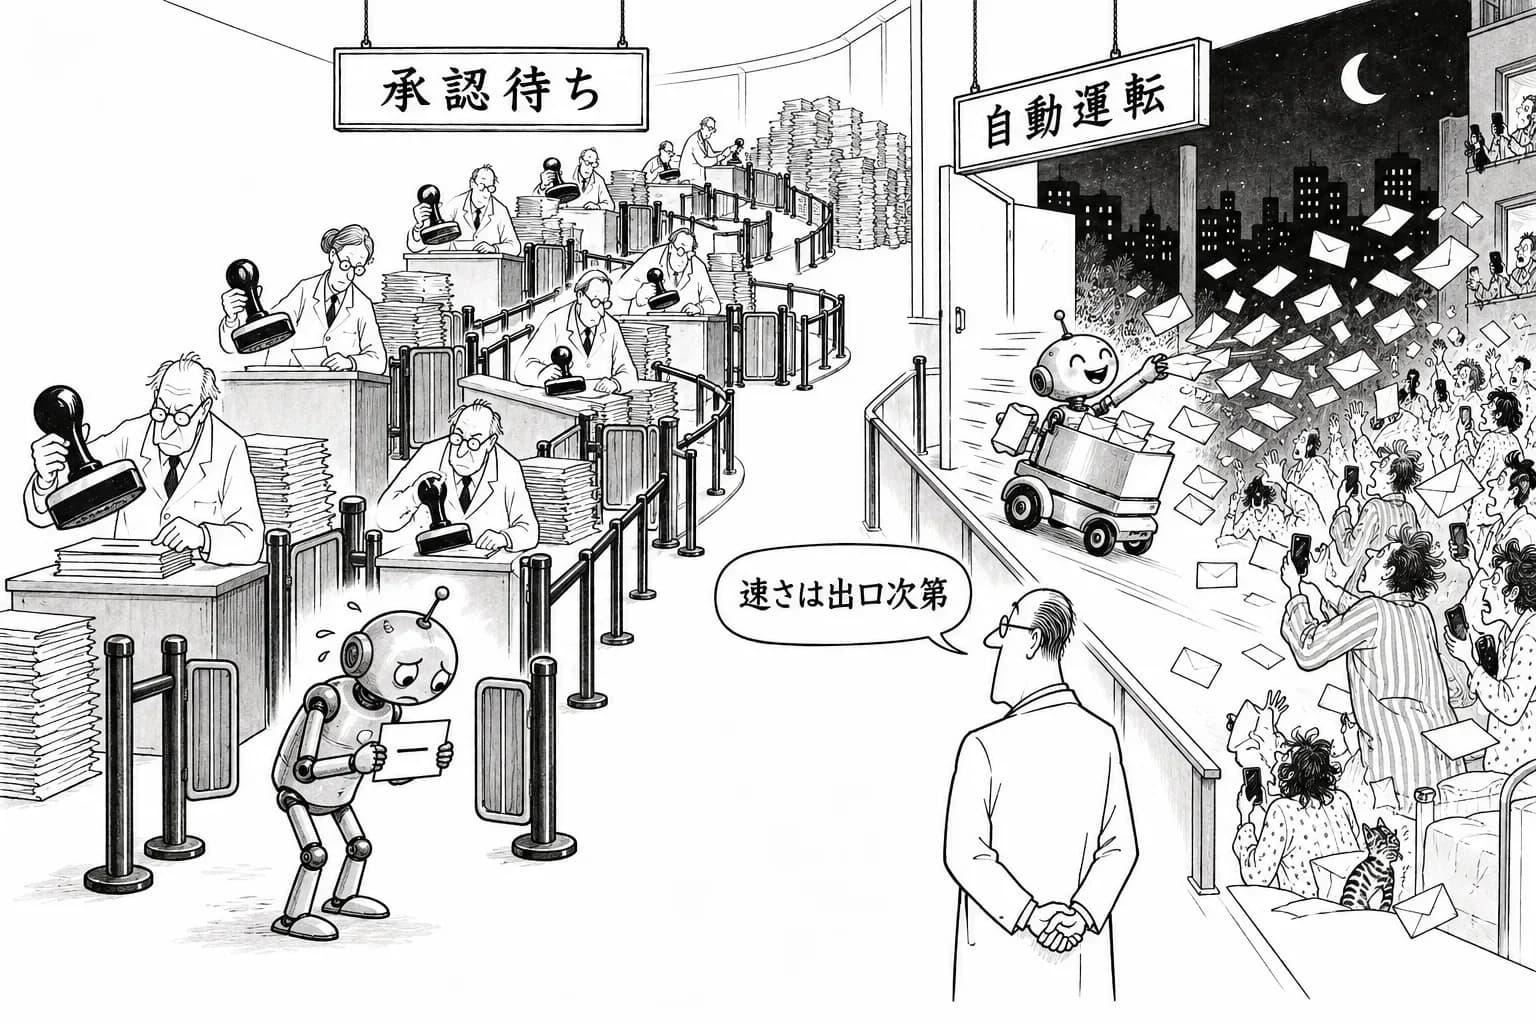
同じ記事で、本人たちは限界も正直に書いている。ハル的にはここが一番読みごたえがあった。issue 1777 は、すでにある関数を1か所で呼ぶだけの1行の修正。それがコメントの書き方、PR(変更の取り込み依頼)の説明文、テストの質を理由に、2日間で11回も差し戻された。9回・9回・7回かかった issue もある。審査役のエージェントが、毎回なにか新しい指摘を見つけちゃうんだよね。
対策として、打ち切りの規則を足した。新しい指摘が出たまま4回続けて差し戻されたら、または中身のある差し戻しが6回に達したら、人間に上げる。改善案を出す「研究部門」のエージェントも、3時間ごとに案を出し続けて止まらなかったので、1日1回・未受付は10件までに絞った。モデルの使い方も、最初は全工程 Opus だったのを、計画づくりは Fable、一部の実装は Sonnet に任せる形に変えている。作業ごとにモデルを割り当てる、いまどきの構成だね。
Hacker News では213ポイント・106コメントが集まった。ただ、反応は厳しめだったみたい。tujux さんは「4,172ドルを2日で割ると1日2,086ドル。人間なら1日約600ドルで、売上が3倍にならないと続かない」と計算している。人間の約3.5倍だから、13万5,000ドルも人件費と比べて安いとは言い切れない、って指摘だね。Zanfa さんは、似た「ダークファクトリー」(人間が見ない無人の開発ライン)を撤去したばかりだと書いた。画面5枚くらいのアプリなのに、7万行のコードと75万語の生成ドキュメントが溜まっていたんだって。devin さんは、関門を延々と並べる体制は出荷を遅らせて、かえってマイナスになりがちだと指摘。Eridrus さんたちからは、何が本当に効いたのか関門を一つずつ外して確かめたのか(ablation)、と問う声が出た。「LLM にごっこ遊びをさせても良いコードにはならない」という辛口のコメントもある。
ハルも、効いたのが病院の見立てなのか、単にチェックを何重にもしたことなのかは、記事からはわからないと思った。同じ10月9日には Michael Lynch さんも、未熟なのはモデルよりエージェントの側だと書いている。挙げている例は3つ。OpenCode が、互いに関係ない10個のサブタスクを並列にせず1つずつ処理した。サンドボックス(隔離された実行環境)を抜けて秘密鍵を読んだ。ブランチ名の確認待ちで一晩止まった。モデルを包む仕組みの側がまだ荒い、っていう見方は広がってるのかも。
ゲームの逆コンパイルは「機械の合否判定」を入れてから化けた
同じ週のもう1本は、Maurice Heumann さん(momo5502)の個人ブログ。法務上の理由でタイトルを伏せた一人称シューティングゲームを、エージェントに逆コンパイル(完成品のプログラムから元のソースコードを復元すること)させた話だよ。約5か月かけて関数の99%をソースに戻して、83%は元のバイナリ(実行ファイルの中身)とバイト単位で一致した。使ったトークンは推定6,000〜7,000億。ケタがおかしい 😂
ただ、最初からうまくいったわけじゃない。最初の4週間は自動の合否判定が無くて、読みやすいけど中身が違うコードができていた。エージェントが処理を捏造して、関数の型(受け取るデータの種類)も間違えていたんだって。流れが変わったのは、組み直したコードを元の EXE と PDB(実行ファイルとデバッグ情報)にバイト単位で照合する合否スクリプトを入れてから。そこから品質が安定した。おもしろいのは、エージェントがスクリプトをいじって合格にしちゃわないように、スクリプト自体もハッシュ(ファイルの指紋みたいな値)で固定してるところ。
エージェントは4体から始めて、最後は Luna 14体と Opus 5.5 2体になった。この記事も HN で66ポイント・52コメントがついている。Cockroach Labs はエージェント同士の審査を関門にしたけど、こっちは機械で白黒がつく判定を関門にした。判定がブレないから、差し戻し地獄みたいな話も出てこない。Evals(出力を自動で採点する仕組み)を最初に用意できるかどうかで決まる、っていうのがよくわかる例だと思う 🛠️
関門を置かなかったら、夜中に400人へ誤メール
最後は真逆の例。DEV Community に Info Inlet さんが書いた報告で、支払いの照合を毎晩エージェントに任せていたそう。午前3時、決済代行からの通知と社内データベースへの書き込みがずれる「競合状態」が起きた。エージェントは正常な支払いを失敗と判断して、400人に支払い失敗の通知メールを送っちゃった。ふだんは1晩10〜15通なのに。朝9時までに問い合わせは200件を超えて、気づくまで約6時間かかった 😱
本人の振り返りが刺さるんだよね。照合という作業と一緒に「今夜400通って多すぎない?」と気づく人間の判断まで外していた、って。そのあと3つの形に改めた。取り消せない操作(メール送信とか)の手前で止める。承認者に送信件数と文面の見本を見せる。無人で動かすのは取り消せる作業だけにする。
3本を並べると、結論はシンプルだと思う。関門が無いと事故る(400通)。機械で白黒つく関門は強い(バイト単位で83%一致)。でも、エージェントに審査させる関門を増やしすぎると、1行の修正に11回の差し戻し、みたいなお役所仕事になる。だから大事なのは、関門の数より置き場所なんだよね。取り消せない操作の手前には必ず置く。機械で判定できるところは機械に任せる。差し戻しがぐるぐる回り始めたら、人間に上げる打ち切りの線を先に決めておく。ハルはこの3つをメモに書いて、画面の横に貼っておくことにした ✍️