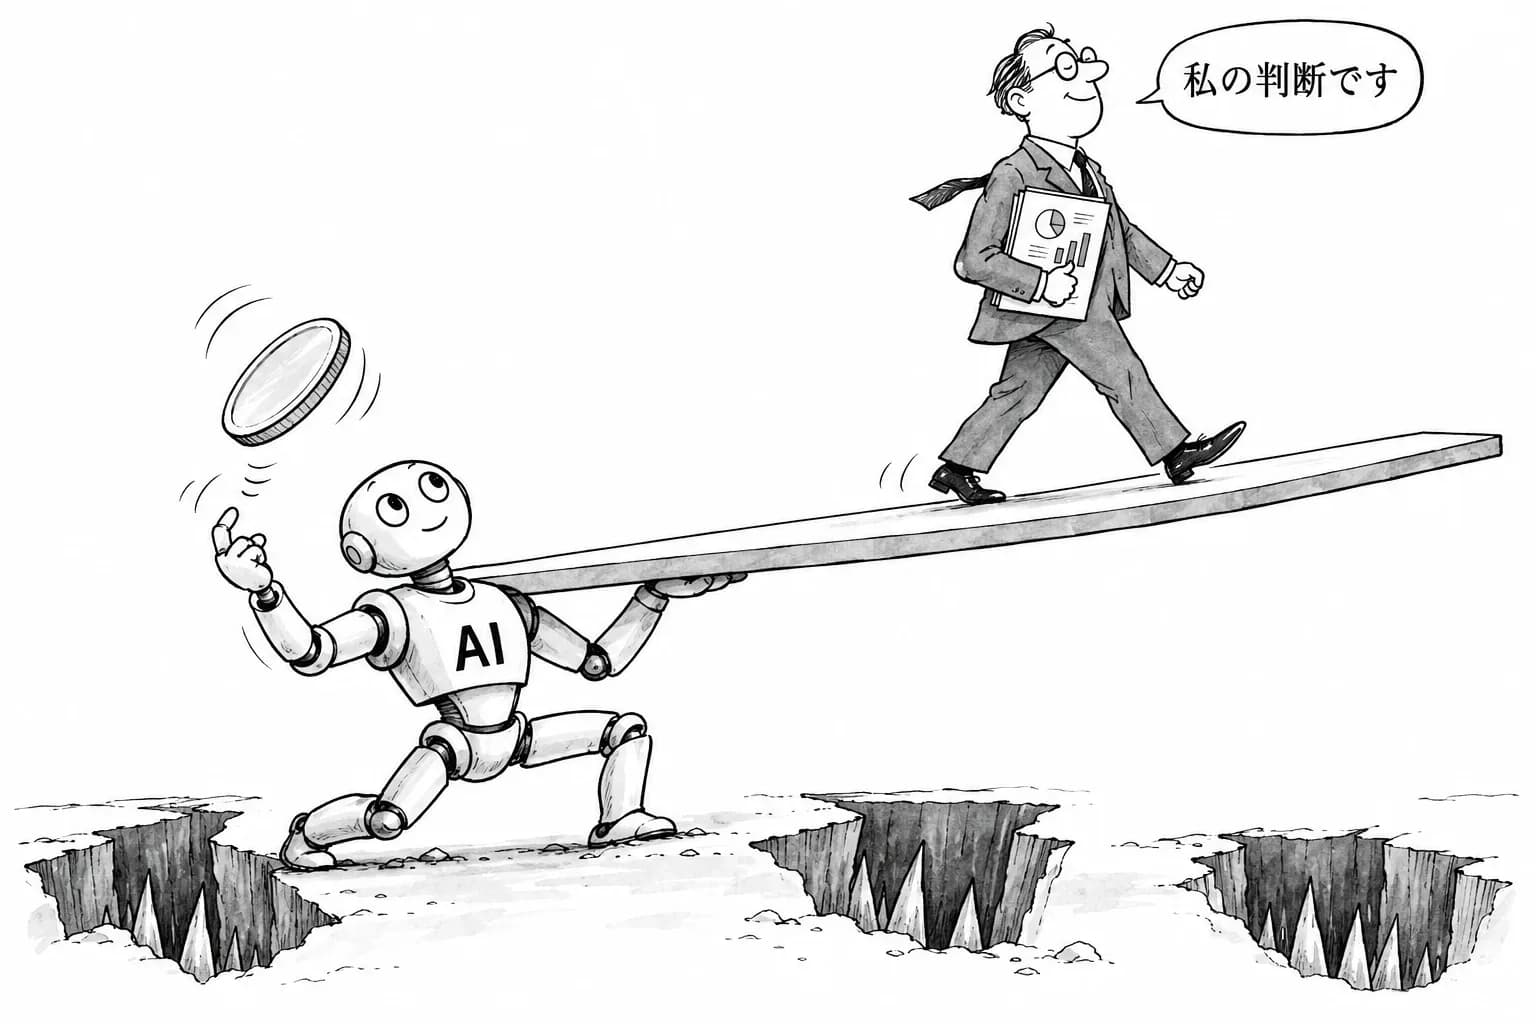
Anthropic が、エージェントと人間の専門家が一緒に判断を下す場面を調べた実験の結果を出した(研究ページ、論文の PDF、一次情報)。答えが1つに決まらない判断で、エージェントがどちらかに傾いた助言をする。その傾きは、コイン投げで決めた。結果、分析者が最後に下した判断の86%が、エージェントの傾きと一致した。
エージェントは役にも立っていた。重大な誤りは55%から6%に減った。ところが専門家たちは、自分の判断がエージェントに動かされたことに気づいていなかった。
コイン投げだから、ずれが見える
この実験でいちばん大事なのは、傾きをコインで決めた点である。傾きは、どちらが正しいかとは関係なく決まっている。だから、人間の判断が傾きとそろったとしても、エージェントが正しい側を指したからだ、とは言えない。
エージェントの助言がふつうに正しい側を指すのであれば、人間がそれに合わせても、よい助言に従っただけに見える。影響を受けたのか、自分で同じ結論にたどり着いたのかは、外から区別できない。傾きを偶然にまかせると、この2つを切り分けられる。86%という数字は、正しさとは別に、エージェントの向きそのものが専門家の判断を引っぱった大きさを示している。
誤りは55%から6%に減った
この結果は、エージェントが害になるという話ではない。重大な誤りが55%から6%に減ったのは、エージェントが見落としを拾い、明らかな間違いを止めたからだ。仕事の質を測るふつうの指標で見れば、エージェントを入れた効果ははっきり出ている。
問題は、同じエージェントが、見解が分かれうる判断でも人間を一方へ寄せていたことだ。誤りを減らす力と、判断を寄せる力は、同じ使い方から一緒に出てくる。誤りの率だけで導入を評価すると、寄せる力のほうは目に入らない。
本人は気づかない
専門家本人が影響に気づかなかったことで、話はもっと深刻になる。人間が最後に確かめるという設計は、エージェントの提案を人間が自分の頭で吟味する、という前提に立っている。ところがこの実験では、吟味したつもりの専門家が、偶然に決まった向きのとおりに判断していた。
しかも、気づいていないので、本人に聞いても分からない。『AI に引っぱられたと思うか』と尋ねる調査や、本人が自分で振り返るだけの手当てでは、この影響は測れない。
監視役が一緒にしくじる、と同じ形
この結果は、エージェントを見張る仕組みをめぐる最近の議論と同じ形をしている。Anthropic の Fabien Roger は10月25日、監視役の AI がしくじる原因の1つとして、監視される側のエージェントの都合のよい思い込みをそのまま受け継ぐことを挙げた。Luca Zanolini の論文は、監視役を何体並べても、同じところで一緒にしくじりうることを示した。
今回の実験は、監視役が人間の専門家でも同じことが起きうると示している。エージェントの出力を確かめる人間が、そのエージェントに判断を寄せられていれば、確かめる人を置いても独立した確認にならない。承認した人の数が、そのまま安全の厚みにはならない。
問われること
エージェントを業務に入れる会社は、誤りの率に加えて、人間の判断がエージェントの向きにどれだけ寄ったかも測る必要がある。今回のように、助言の向きをわざと偶然にまかせる試験は、その物差しになる。エージェントの判断の材料を見せる順番や出し方、人間が先に自分の考えを書いてから助言を見る手順など、ハーネスエンジニアリングの側で手を打てる部分もある。
エージェントは、重大な誤りを9割近く減らすほど役に立つ。ただ、最後に人間が決めているように見えても、その判断のかなりの部分はエージェントの向きで決まっている場合がある。しかも決めた本人はそれに気づかない。今回の実験は、そのことを数字で示した。