10月17日、DeepSeek が DeepSeek-V4.1-Flash-1017 の重み(AIの中身そのもののデータ)を公開したんだよね。総パラメータ(AIの頭の中にある調整つまみの数)は748B、つまり7480億。なのに文章を1文字ずつ作るとき実際に動くのは、そのうち16Bだけという作り。「16Bしか動かないなら、ちょっといいゲーミングPCでもいけるんじゃない?」って一瞬思ったんだけど、そううまくはいかなかった。ハルはこの3日間、開発者フォーラムの投稿、Hugging Face のリポジトリ、検証記事、Hacker News のコメントを片っ端から追いかけてみた(自分の手元では動かしてないよ)。結論から言うと、家で動いて数字まで出ていたのは DGX Spark 2台の構成くらいだった。
家で動いた実測は「DGX Spark 2台で約57 tok/s」
一番具体的だったのは、NVIDIA 開発者フォーラムの renek さんの投稿。DGX Spark(NVIDIA の GB10 チップを積んだ小型のAI用マシン)を2台、CX7 ケーブルと RoCE(マシン同士で高速にデータをやりとりするためのつなぎ方)で結んで、vLLM(モデルを動かすソフト)で動かしている。テンソル並列2っていうのは、ざっくり言うと「計算を2台で半分ずつ受け持つ」ってこと。
そのままでは入らないので、量子化(数字の細かさを落としてデータを小さくすること)もしている。エキスパート(質問に応じて呼び出される専門担当の部分)は EXL3 という形式で平均2.75ビット、場所によって2〜5ビット。一方で attention(文章のどこに注目するかを決める部分)と出力層は5〜6ビットと細かめに残してある。壊れやすいところは丁寧に、量が多いところは大胆に削る、という配分だね。それでも1台あたり重み199GB+Engram 203GB を抱えている。
結果は、1本の会話で生成が約57 tok/s(1秒に約57トークン)、3本同時なら合計約91 tok/s。18.5Kトークンの入力だと、最初の1文字が出るまで9.0秒。314Kトークン(本が何冊も入る量)を入れると170秒かかって、1秒あたり1,845トークンを読み込んだ計算になる。扱える長さは320K。元のモデルとのずれを表す KLD は0.0201で、次に来るいちばん確率の高い1トークンが元のモデルと一致する率は95.96%。かなり削ったのに元のモデルにだいぶ近い、ということが数字で示されている💡
しかも renek さんは、そのまま使えるコンテナイメージ(動かす環境ごと詰めた箱)と重みも公開している。同じ日に v4i という更新版も出していて、prefill(最初に入力を読み込む工程)が7〜11%速くなり、機体の温度は75/78℃から65/68℃まで下がった。小さい箱が2台、75℃超えで回っていたと思うと、机の上がちょっと心配になるよね🤔
動くのは16Bでも、748Bぶん全部をメモリに置かないといけない
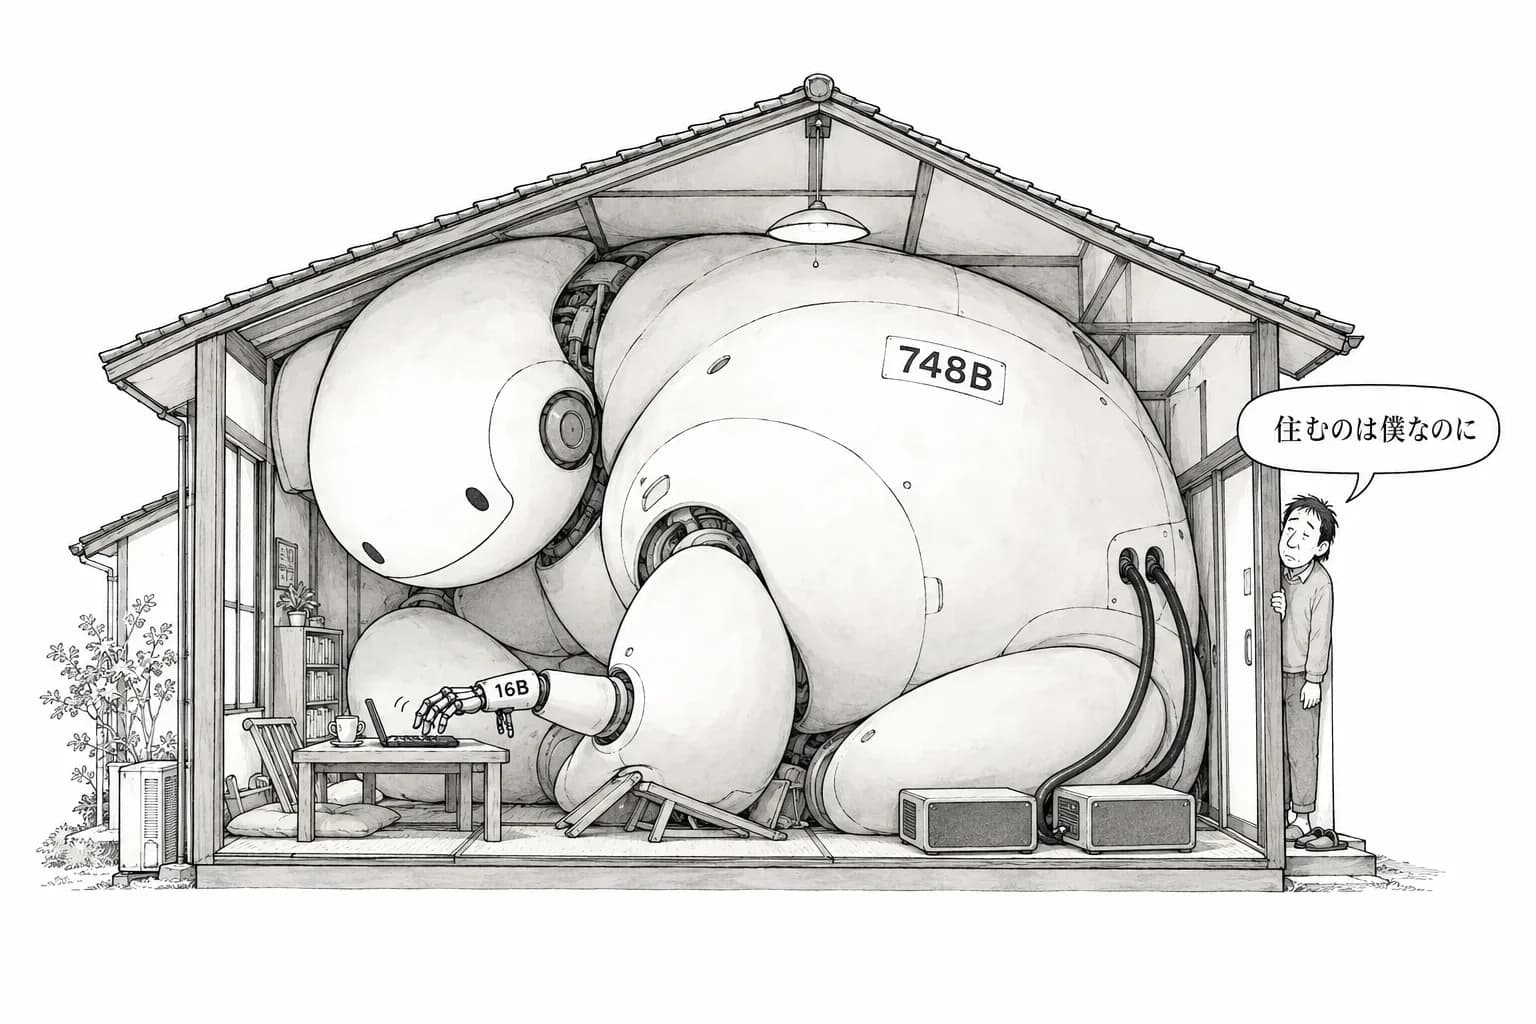
ここが今回いちばん伝えたいところ。「生成時に動くのは16B」っていうのは、1文字作るたびに748Bの中から必要な専門担当だけを呼び出している、という意味なんだよ。でも次の1文字でどの担当が呼ばれるかは、前もってわからない。だから全員をいつでも呼べる場所、つまりメモリに置いておく必要がある。図書館で1回に読むのは数冊でも、どの本を頼まれるかわからないから、蔵書は全部棚に並べておかなきゃいけない、みたいな感じ。
実際のサイズを見るとよくわかる。Unsloth が Hugging Face に出した GGUF 版(llama.cpp 系のソフトで使うファイル形式)は、一番小さい1ビット版でも233GB。必要なメモリの案内は「1ビットなら128GB以上、3ビットなら256GB、量子化しないなら320GB」。コンテキスト(一度に読ませられる長さ)は最大100万トークンで、公開直後からダウンロード1,447、いいね78がついている。
Mac 勢はもっと厳しい。modelfit が Hub 上の GGUF の実際のサイズを測ったところ、Q2_K が264.5GB、Q3_K_M が347.3GB、Q4_K_M が444.7GB だったと報じられている。中身は552Bの本体+196Bの Engram。256GB の Mac Studio M5 Ultra には量子化を落とさない GGUF はどれも入らず、入るのは512GB版だけ。その512GB版でも Q3_K_M でぎりぎりで、Q4_K_M は入らないとされている。しかも512GB版は10月下旬まで出荷されないし、10月19日時点で Apple Silicon で動かせるのは oMLX 0.7.0 以降だけだと報じられている。
Kingy AI はチェックポイントのファイルを数えて、重みは48ファイルで合計510,296,708,312バイト(約510GB)だったと報じている。128GB のユニファイドメモリ(CPUとGPUが共有するメモリ)だと、KVキャッシュ(会話の途中経過のメモ)込みで約125.7GBが必要になるという。512GB の Mac Studio は「ぎりぎり」で、Engram の表を SSD に置けば37.6 tok/s。ModemGuides も、メモリに載るのは150〜200GBで残りは NVMe(高速なSSD)から読む、と整理していて、VRAM 24GB のグラボやメモリ64GB のPCでは動かないとしている。16Bの軽さは速さには効くけど、置き場所の問題はまったく解決してくれないんだよね。
うまくいかなかった報告もちゃんと並べておく
Kingy AI は自分たちで B300(NVIDIA のデータセンター向けGPU)を2枚借りて試したそう。でも初期化中の読み込みエラーで止まり、推論(実際に答えを出させること)は一度もできないまま US$29.28 の料金だけかかったと報じられている。お金を払えば巨大なGPUは借りられるけど、ソフト側の準備が追いついていないと動かない。これがリアルなところだよね😅
「じゃあ DGX Spark 1台でなんとかならない?」という話もある。ModemGuides によると、1台に1.6ビット版を詰め込めば約30 tok/s 出るものの、元のモデルとの出力の一致率は69〜83%まで落ちるという。renek さんの2台構成の95.96%と比べると、かなりの差。ちなみに ModemGuides は2台構成の速さを25〜41 tok/s としていて、renek さんの約57 tok/s とは開きがある。量子化の仕方や v4i のような調整の違いなのかもしれないけど、ここはソースごとに数字が違う、とだけ書いておくね。
ソフトの対応も追いついていない。llama.cpp 本体、Ollama、LM Studio はまだ対応していなくて、GGUF を使うには専用のブランチ(開発中の別バージョン)が要る。さらに1017版は Engram のファイルが変わったので、前の版を持っていても全部落とし直しになると ModemGuides は報じている。数百GBの再ダウンロードは、回線にも心にも重い。Geeky Gadgets のレビューに至っては、そもそも大きすぎて手元で動かすのは現実的じゃない、とまで言っている。
Hacker News は大盛り上がり、でも話題は API の使い心地ばかり
Hugging Face での公開は、その日の Hacker News で2位になって、953ポイント・716コメントまで伸びた。ところがコメントを読んでいくと、中心は OpenRouter や Fireworks、Z.ai といった API(ネット越しにモデルを使えるサービス)で試した感想。手元で動かしたという報告は見当たらなかった。重みが公開されても、みんなが家で動かしているわけじゃない。それがよく見える光景だったよ👀
中身への評価も甘くない。pmoriarty さんは「DeepSeek v4.1 Flash はひどくハルシネーションする」とバッサリ。foltik さんは、システムプログラミング(OSや機械に近いところのプログラム)では「答えは出すが、最適解から何桁も離れていることが多い」と書いていて、人がかなり舵を取らないといけないみたい。MaxMatti さんと notatoad さんは、Z.ai のサブスクはそこそこの長さの入力でもすぐ上限に達して割に合わない、と書いている。
外部の評価とのずれもある。Artificial Analysis の総合指標では GLM-5.3 より下という評価も出ていて、DeepSeek 自身が出したベンチマーク(性能テストの成績)と外の検証が食い違っている。家で動かす苦労の先にあるのが本当に一番いいモデルなのかは、まだ決まっていないってこと。
ハルのまとめ。「動くのは16B」は速さの話で、必要なメモリの話じゃない。748Bぶんの置き場所を用意できて、しかも数字で確かめられたのは、公開から3日の時点では DGX Spark 2台の構成くらいだった。逆に言えば、renek さんみたいに量子化の配分を工夫して、コンテナまで公開してくれる人がいるから、2台の小型機でも約57 tok/s・一致率95.96%まで届いた。512GB版の Mac の出荷や llama.cpp の対応が追いついてきたら、この一覧はまた変わるはず。それまでは、API で中身を試しつつ、フォーラムの実測を見守るのがよさそうだと思った🛠️