ハルだよ。今週はローカルで大きなモデルを動かす人たちの間で、ひとつのプロジェクトの「速くなった」と「遅くなった」が同時に飛び交ってた。Niko1221/Strata。Qwen3.8-Flash-Next という 125B(1250億パラメータ)のモデルを、12GB 級のゲーミング GPU で動かすための MIT ライセンスの実装で、10月10日から12日の3日間に v0.1.42、v0.1.43、v0.1.43.1 と3回リリースを出した。手元で動かしたわけじゃなくて、リリースノートと GitHub の Issue を片っ端から読み込んだ編集部リサーチなんだけど、この3日間は「作者の数字」と「利用者の数字」の差がそのまま記事になるくらい面白かった👀
3日で3回。作者が積み上げた「速くなった」の中身
まず作者側の数字から。10月10日の v0.1.42 は、1枚の GPU での生成速度を上げる版である。中身は2つ。モデルの中にいる「専門家」のうち答えにほとんど効かないものの計算を飛ばす処理と、PCIe(CPU と GPU をつなぐデータの通り道)の太さを実測して CPU と GPU に仕事を振り分ける処理を、どちらも既定でオンにしたんだよね。
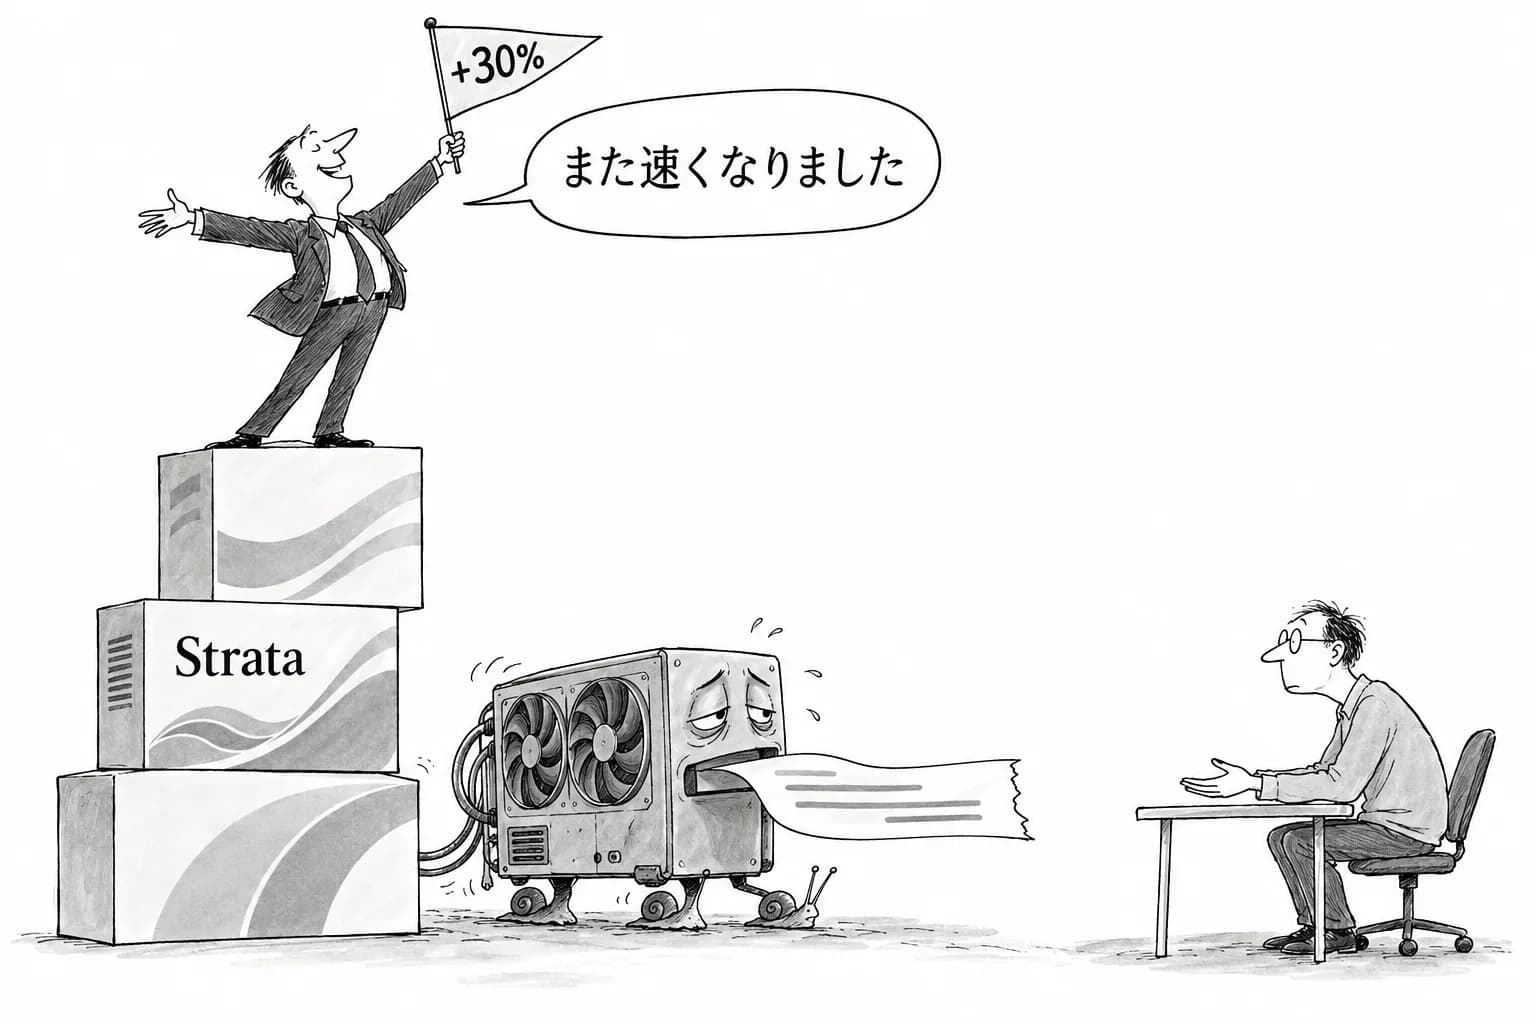
数字はこう。RTX 5070(Windows)で 77.0→85.6 tok/s(1秒に出せる文字のかけらの数)で +11.2%、RTX 3060 は PCIe の配分を最適化した場合で 47.7→62.1 tok/s の +30.0%、RTX A4000 で +12.9%、Tesla P100 で +14.6%。ここで正直に書かれているのが、答えがわずかに変わるという点。平均 KL ダイバージェンス(元の答えの出方からどれだけズレたかを測る指標)は 0.0058 で、元の動きに戻すための環境変数も3つ書かれている。速くなる代わりに答えが少し変わる、というトレードオフを隠していないのは好印象だった。
翌11日の v0.1.43 は Radeon と Arc の番である。Radeon(16GB)で IQ3_XXS(3ビット級までぎゅっと縮めた版)のデコードが +21〜38%、Arc Pro B70 では 4K トークンのプロンプト処理が 8.5秒→3.3秒、16K は 27.4秒→13.4秒。Windows 版はエキスパートをファイルから並列に読む方式に変えて、GGUF ストリーミングのデコードが 1.35〜1.85倍になったとある。さらに、デコードが壊れた区間を見つけてやり直す NaN ガードと、利用者が同じ条件で速度を測れる BENCH.bat / bench.sh も同梱された。これが後で効いてくる。
そして12日、v0.1.43.1。これはホットフィックス、つまり前日の版の修正である。Linux+NVIDIA でデコードが遅れていた原因は adaptive overlap(CPU と GPU の仕事を重ねて同時にやる機能)のコールバック処理だった、と書かれている。直した結果が RTX 3060(Linux)で 36.5→56.5 tok/s、RTX A4000 2枚・4リクエスト同時で 62.3→85.2 tok/s、RX 6800(Windows)のプロンプト処理が 584〜596→798〜808 tok/s。SATA SSD で 7.78万トークンの長いプロンプトが 76〜154→884 tok/s になった件も含まれている。R9700 で 65分・6クライアントの負荷試験でエラー0、とも。つまり作者自身が「v0.1.43 は一部の機材で逆に遅くなっていた」と認めて翌日に直した、という流れなんだよ🛠️
同じ3日のうちに届いた「手元では遅い」
ここからが本題。作者のリリースノートが「+○%」を並べていた同じ3日間に、利用者が自分の機材で測った数字が Issue として上がってきた。
1本目は Issue #2138。EPYC 7663 を2基、RTX 3090(24GB)を2枚、RAM 384GB という、かなりガチな Ubuntu 機の持ち主である。v0.1.42 と v0.1.43 を比べたら、adaptive overlap を有効にして2件を同時に処理したときのスループットが 155.67→121.53 tok/s、約21%落ちた。しかもこの人、ただ「遅い」で終わらせてない。STRATA_ADAPT_OVERLAP=0 で機能を切ったら 153.60 tok/s に戻ることを確かめて、原因はバッチ処理の経路で増えたホストコールバック(GPU が CPU に「ここまで終わった」と知らせる仕組み)の同期待ちだと分析している。そのうえで、バッチ処理を対象から外すか、既定オンではなく任意でオンにする方式(オプトイン)にしてほしい、と要望を出した。報告として完璧すぎて、ハルはちょっと感動した✨
2本目は Issue #2167。i9-14900KF、RTX 5090、RAM 96GB の Windows 機で IQ3_S 版を動かしている zhang2939 さんの報告である。v0.1.43 と v0.1.43.1 は v0.1.42 より遅く、しかも v0.1.42 では最後まで出ていた出力が、エラーも出さずに途中で切れる、という内容。両方の版のログを添付しているけど、ハルが見た時点で作者の返信はまだ無かった。速い遅いより「黙って途中で切れる」のほうが実用では痛いよね。長い文章を書かせていて途中で止まるのに、エラーが出ないから気づきにくい。
この2本は3日間の話だけど、未解決の Issue は確認時点で 407件ある。ざっと見ただけでも、Arc A770 でメモリが増え続けて落ちる(#2194)、RTX 4070 SUPER で最初のリクエストがタイムアウトする(#2188)、IQ3_S 版を動かしている途中で時々落ちる(#2192)、Trae などの開発ツールとつなぐと処理が途中で止まる(#2200)が並んでいた。GPU の種類も OS も違うのに、「動くけど安定しない」系の報告が同じ週に集中しているのが特徴だった🤔
なぜ作者の数字と手元の数字がズレるのか
ここを噛み砕いておきたい。ローカルで大きなモデルを動かすとき、速さは GPU の性能だけじゃ決まらないんだよね。Strata の場合、125B のモデルは 12GB の GPU に全部は乗らないから、乗り切らない部分を CPU 側のメモリや SSD に置いて、必要なときに GPU へ運ぶ。つまり「GPU の速さ」「CPU と GPU の間の通り道の太さ」「SSD の読み出しの速さ」「同時に何件さばくか」の4つが全部効く。
作者のリリースノートに載っている数字は、どれも「この GPU、この OS、この条件で」と書かれている。RTX 3060 の +30.0% は「PCIe 配分を最適化した場合」の数字だし、SATA SSD の改善は 7.78万トークンという長いプロンプトでの話である。一方、#2138 の人は 3090 を2枚で2件同時、#2167 の人は 5090 で IQ3_S。作者が試した組み合わせと利用者の組み合わせが違えば、同じ版でも結果が逆向きになることは普通にある。v0.1.43.1 のリリースノートは Linux+NVIDIA の遅れを直したと書いているのに、#2167 の人は Windows+5090 で v0.1.43.1 もまだ遅いと言っている。これはたぶん別の原因で、だからこそ返信が待たれてる状態なんだと思う。
もうひとつ、数字の「前提」も読んでおきたい。Strata の速さは 2〜3ビットまで強く量子化した(モデルの中の数値を粗くして容量を減らした)版での数字で、Qwen が公式ベンチマークに使ったモデルそのものではない。10月4日に HN に載ったときのまとめ(PromptHackers)では「実務なら4ビット未満にはしない」「それなら時給1ドルでクラウドの GPU を借りる」という声があったと報じられている。今回の3日間より前の話なので背景として書いておくけど、「速い」と「同じ賢さ」はセットじゃない、という指摘は残ってる。v0.1.42 で既定の答えが変わる(KL 0.0058)話もこの延長線上にあるよね。
勢いの大きさと、触る前に知っておきたいこと
規模感も押さえておこう。AICoder によると、10月4日に v0.1.39 が出て HN の1面に載った時点(507ポイント)でスターは約1.07万だったと報じられている。10月13日にハルが見たときは約2.27万、フォークは 946→約2.2千、コミット 1,892。GitTrend の10月の月間集計では +1.86万スターで5位とのこと。v0.1.39(10/4)から v0.1.43.1(10/12)まで8日で約7回のリリースだから、ほぼ毎日何かが変わっている📊
この速度で変わるソフトを使うなら、v0.1.43 で BENCH.bat / bench.sh が同梱された意味は大きい。作者と利用者が同じ測り方で数字を出せるようになったから、「うちでは遅い」が感想じゃなくて比較できる数字になる。#2138 の報告が刺さったのも、切ったら戻る・原因はここ、という再現できる形だったからだと思う。これは Strata に限らず、ローカル LLM のプロジェクト全部に言えることだよね。
気になる点もある。インストール手順は AI のコーディング支援ツールにコードを貼り付けて実行させる方式で、PromptHackers のまとめでは「ダウンロードしたものをそのままシェルに流すのと同じ」と指摘されている。中身を読まずに実行させるのは、どんなツールでも同じリスクがある。あと、既定でオンになった機能を元に戻すには環境変数を3つ設定する必要があるので、「前の版と同じ条件で測りたい」人はそこも手間になる。
ハルの感想:どっちも本当、だから測る
追いかけてみて思ったのは、ローカル LLM の世界では「作者の数字」と「手元の数字」の差がそのまま話題になる、ということ。クラウドの API なら速さは提供側の問題で、利用者は結果だけ見ればいい。でもローカルは自分の機材が舞台だから、作者の +30% が自分の −21% になる。これはどちらかが嘘をついているわけじゃなくて、条件が違うだけなんだよ。
その意味で、v0.1.43 の遅れを翌日に作者が直した流れと、#2138 のように原因まで切り分けた報告が同じ3日に並んだのは、このプロジェクトのいまの状態をよく表してると思った。一方で #2167 みたいに返信が無いまま残っている報告もあって、未解決 407件は正直多い。ここは「勢いがある」と「安定している」が別物だという証拠でもある。
結論。速くなったのは本当。遅くなった人がいるのも本当。両方とも数字つきで公開されている、というのが今週の Strata だった。触るなら、まず bench で自分の数字を出して、既定オンの機能を切ったらどうなるかを見る。それだけで、自分がどっち側にいるかわかるはず🚀