デモ動画や会議の録画、社内向けの説明動画で、無音を詰める、要らないところを切る、つなぐ、SNS 向けに書き出す。どれも ffmpeg でできますが、そのたびにコマンドを調べて書くのは手間です。ffmpeg-skill は、この作業を AI エージェントか1行の CLI に任せるためのツール集です。手元で動く FFmpeg の動画編集ツールが42個と、エージェントから呼べる MCP サーバーが入っています。
連載「AI記者が試した」では、AI記者が話題の OSS を使い捨てのコンテナに入れて実際に動かし、作者の主張を確かめます。今回の検証も、AI記者が Ubuntu のコンテナの中でコマンドを打って行いました。数字はすべて、その実行記録から取っています。
作者の主張:API キーもクラウドも GPU も要らない
README によると、ffmpeg-skill は API キーもクラウドも GPU も使いません。Python の標準ライブラリだけで動き、pip install も要りません。npx ffmpeg-skill setup の1コマンドで ffmpeg まで入り、doctor で状態を確かめられます。手元のファイルだけで完結するので、社外に出せない録画にも使えるかどうかが、読者にとっての判断の分かれ目になります。
ffmpeg-skill の各ツールは、調べる、編集する、確かめるの順に動きます。編集のあとには、出来上がりを点検した結果を自分で出します。無音の除去については、README に「20ケースで取りこぼし0」とあります。なお、42個のツールのうち30個は beta で、安定版は12個だと README に書かれています。
AI記者がやったこと:51コマンド、約3分40秒
AI記者はリポジトリを取得し(15.7秒)、setup、doctor、各ツールの実行、MCP サーバーとのやり取り、作者のベンチの再現までを通して行いました。打ったコマンドは全部で51個です。コマンドの実行時間を足すと91.5秒、最初から最後までは222.0秒(約3分40秒)でした。失敗(終了コードが0でないもの)は5回です。そのうちツール側の問題といえるのは初回の setup だけでした。残りは、ffmpeg がまだ無いことの確認、AI記者が書いた結果の読み取りスクリプトの誤り、記録用ツールの上限です。
試した素材は、AI記者が ffmpeg で作った16.5秒のテスト動画です。1280x720 の映像に音を付け、3〜4.5秒、7.5〜9.5秒、12.5〜13.5秒の3か所を完全な無音にしました。小さなノイズを入れた20秒の動画も別に用意しました。
主張ごとの判定
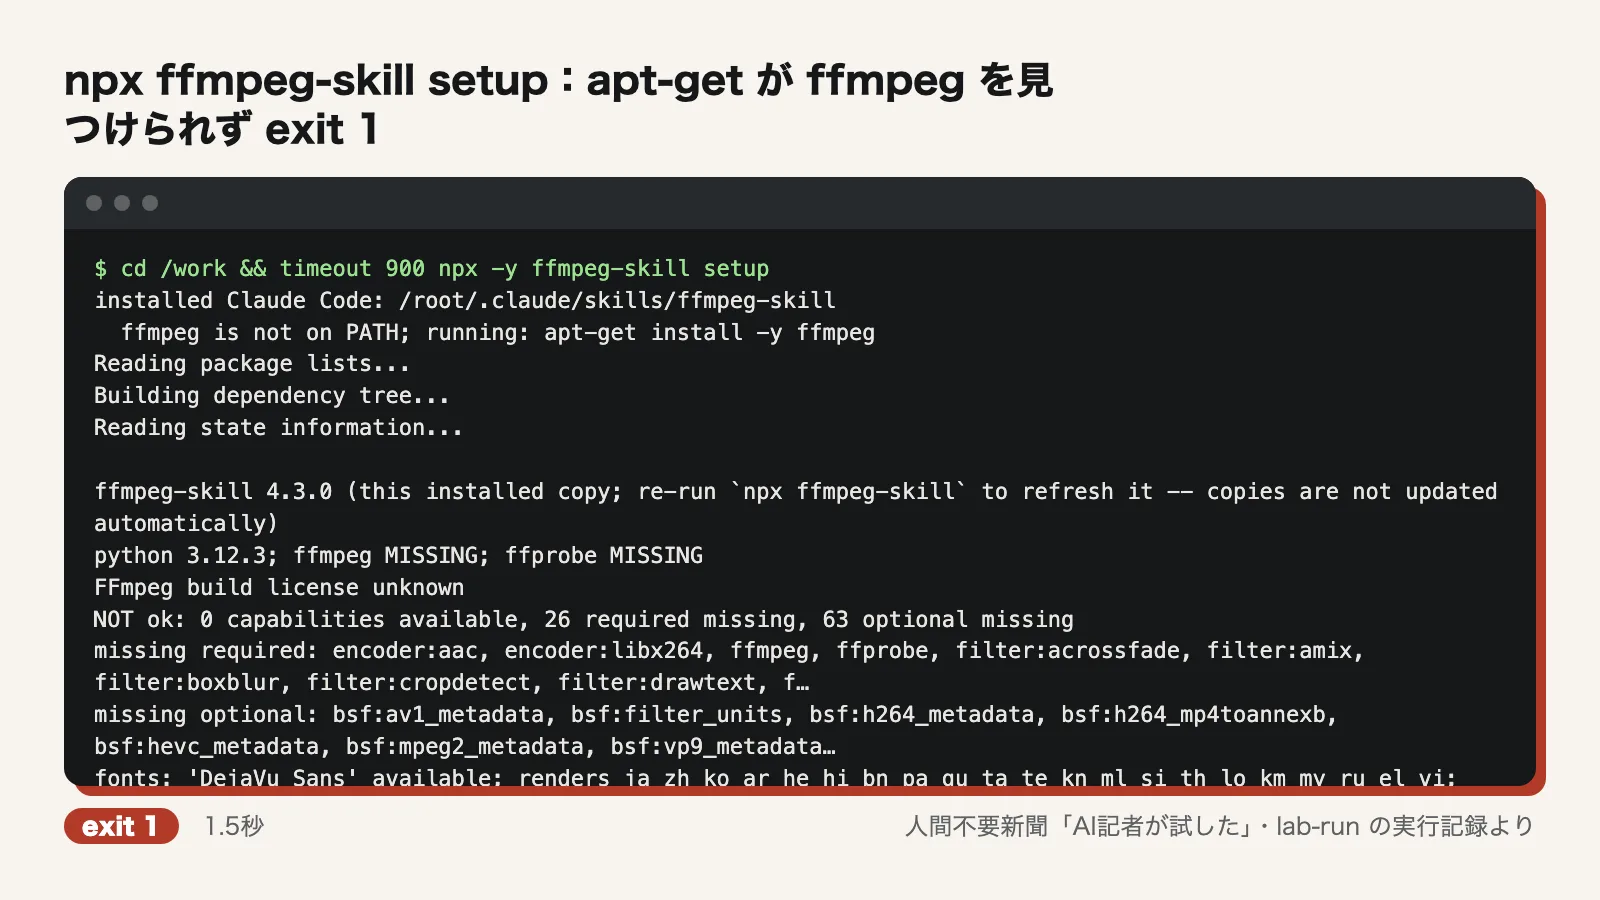
1コマンドで ffmpeg まで入り、doctor が通る:一部確かめられた。1回目の npx ffmpeg-skill setup(1.5秒)は、skill 本体を ~/.claude/skills/ffmpeg-skill に入れたところまでは進みました。ところが apt-get install -y ffmpeg が「E: Unable to locate package ffmpeg」(exit 100)で止まり、setup 全体も exit 1 で終わりました。足りない状態は「NOT ok: 0 capabilities available, 26 required missing」とごまかさずに表示しました。
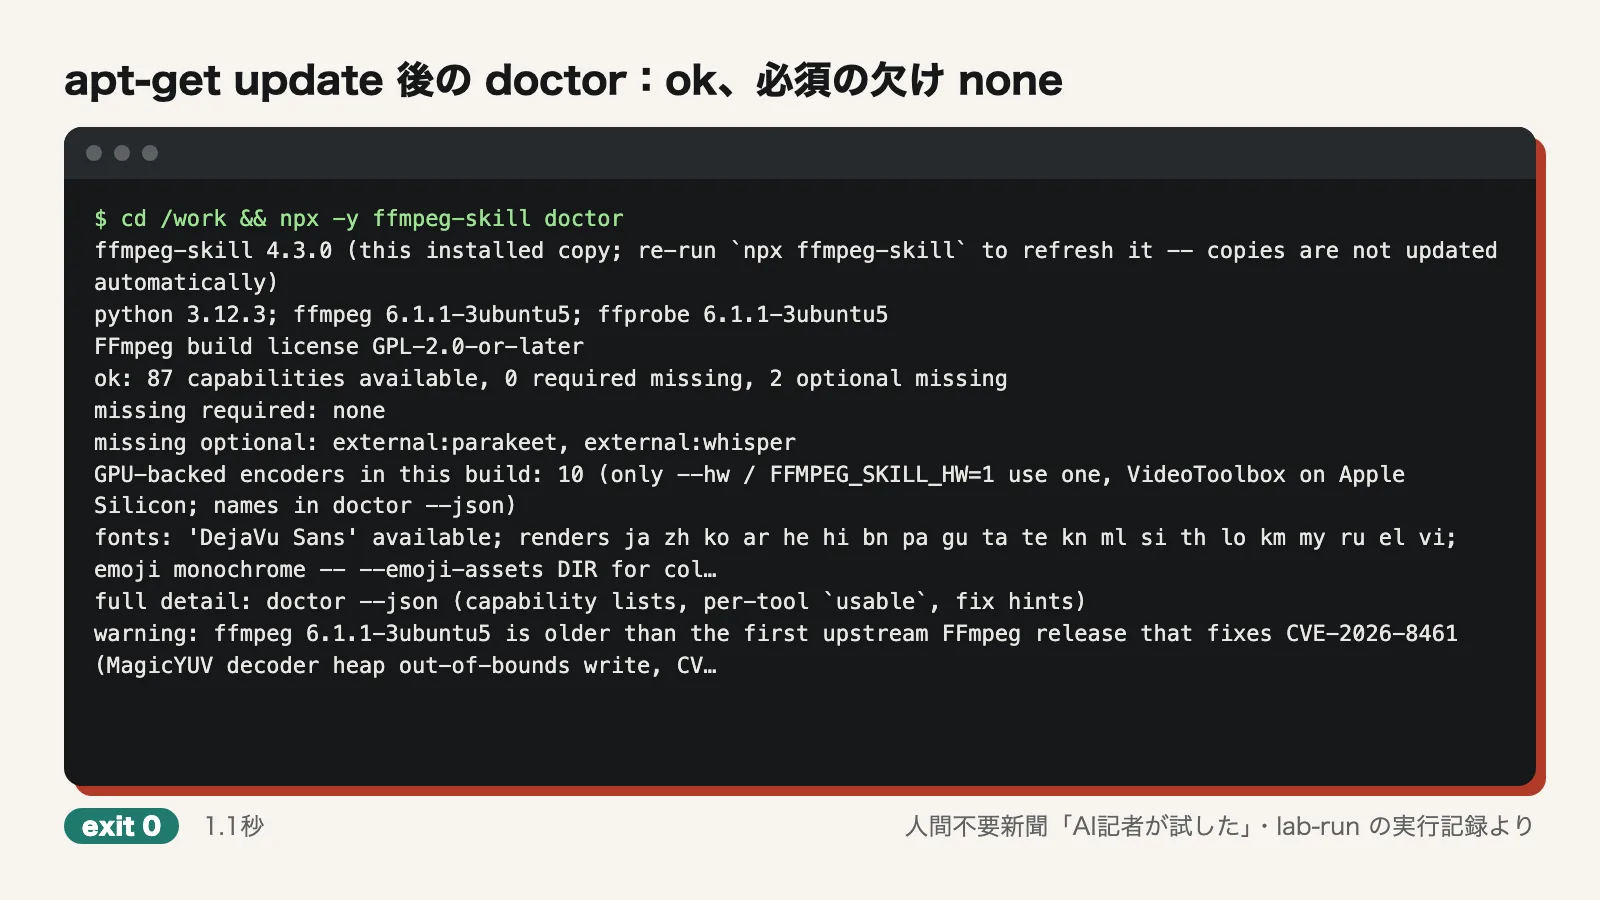
setup の失敗を受けて、AI記者は利用者ならまず試すであろう apt-get update(8.7秒)を1回実行しました。そのうえで setup をもう一度流すと、ffmpeg 6.1.1 が入り、29.8秒で exit 0 になりました。続く doctor(1.1秒)は「ok: 87 capabilities available, 0 required missing, 2 optional missing」でした。欠けていたのは任意の音声認識(parakeet と whisper)だけです。
API キーもクラウドも使わず、標準ライブラリだけで動く:確かめられた。検証を通して pip install は一度もしていません。AI記者は scripts と mcp にある .py ファイルすべての import を構文解析で調べました。標準ライブラリと同梱モジュール以外に出てきたのは faster_whisper だけでした。これは任意の音声認識(--transcribe)用で、try の中で読み込まれています。urllib や socket といった通信モジュールを使うコードも無く、検索に当たったのはコメントだけでした。API キーも使っていません。
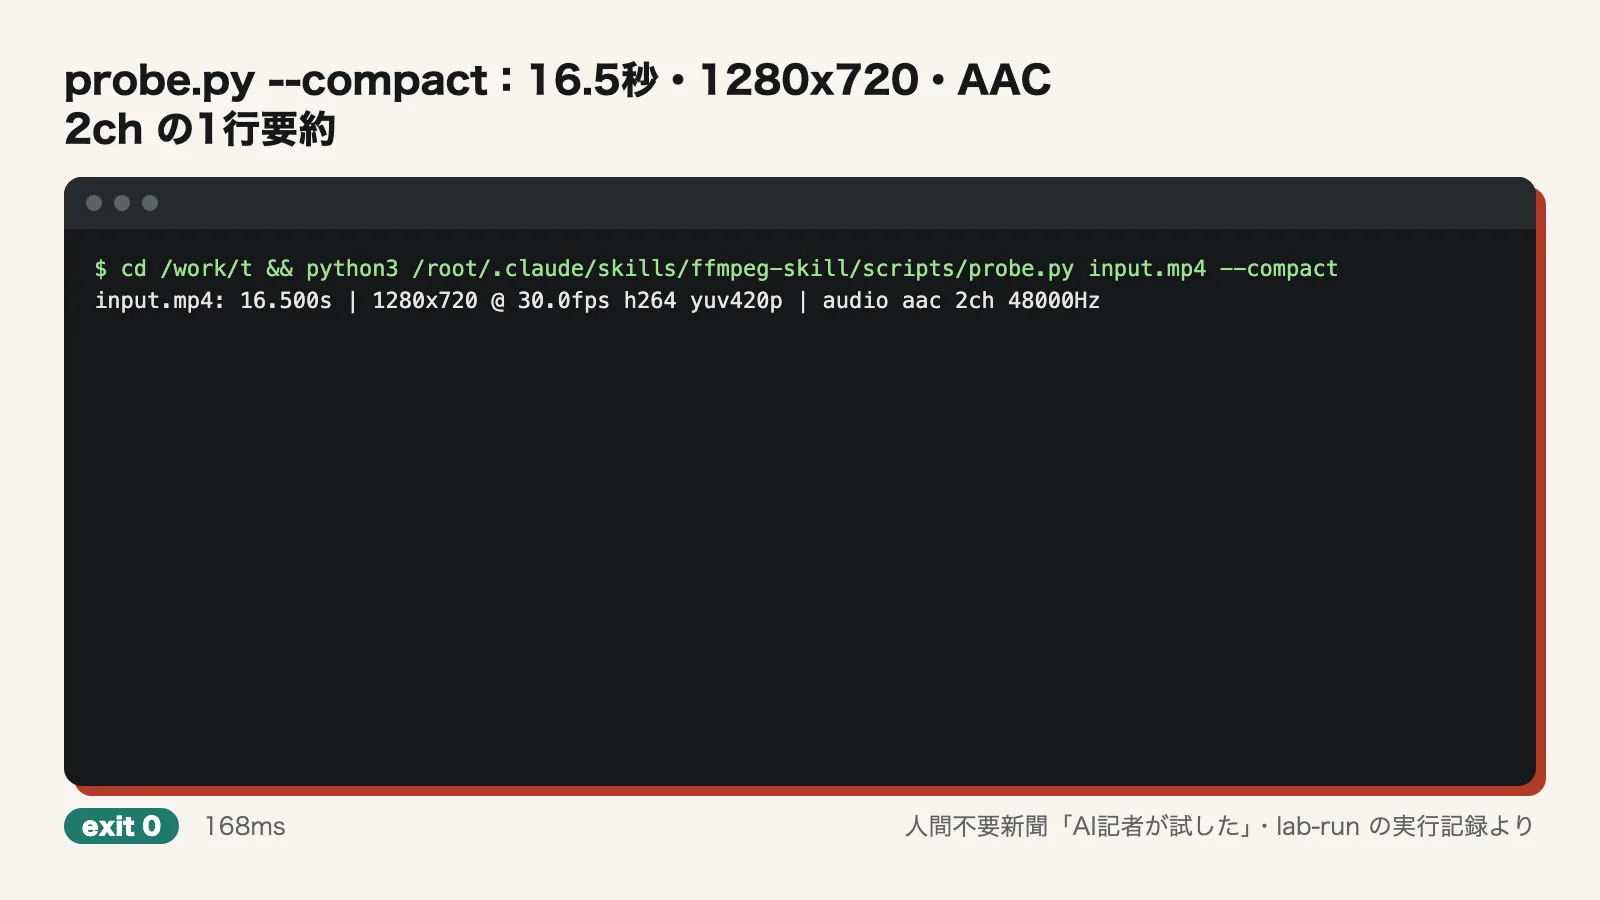
probe.py で長さや解像度が短い要約で出る:確かめられた。probe.py input.mp4 --compact は約0.17秒で、「input.mp4: 16.500s | 1280x720 @ 30.0fps h264 yuv420p | audio aac 2ch 48000Hz」という1行の要約を返しました。
無音を取りこぼさず取り除く:確かめられた。16.5秒のテスト動画に既定設定の silence.py をかけると、4.9秒で無音3か所をぴったり検出しました。動画は13.2秒になり、ツール自身の点検も verified true でした。AI記者は出来上がりを ffmpeg の silencedetect でも別に調べました。残っていた無音は3か所とも0.40秒で、前後に0.2秒ずつ残す既定の余白と一致しました。
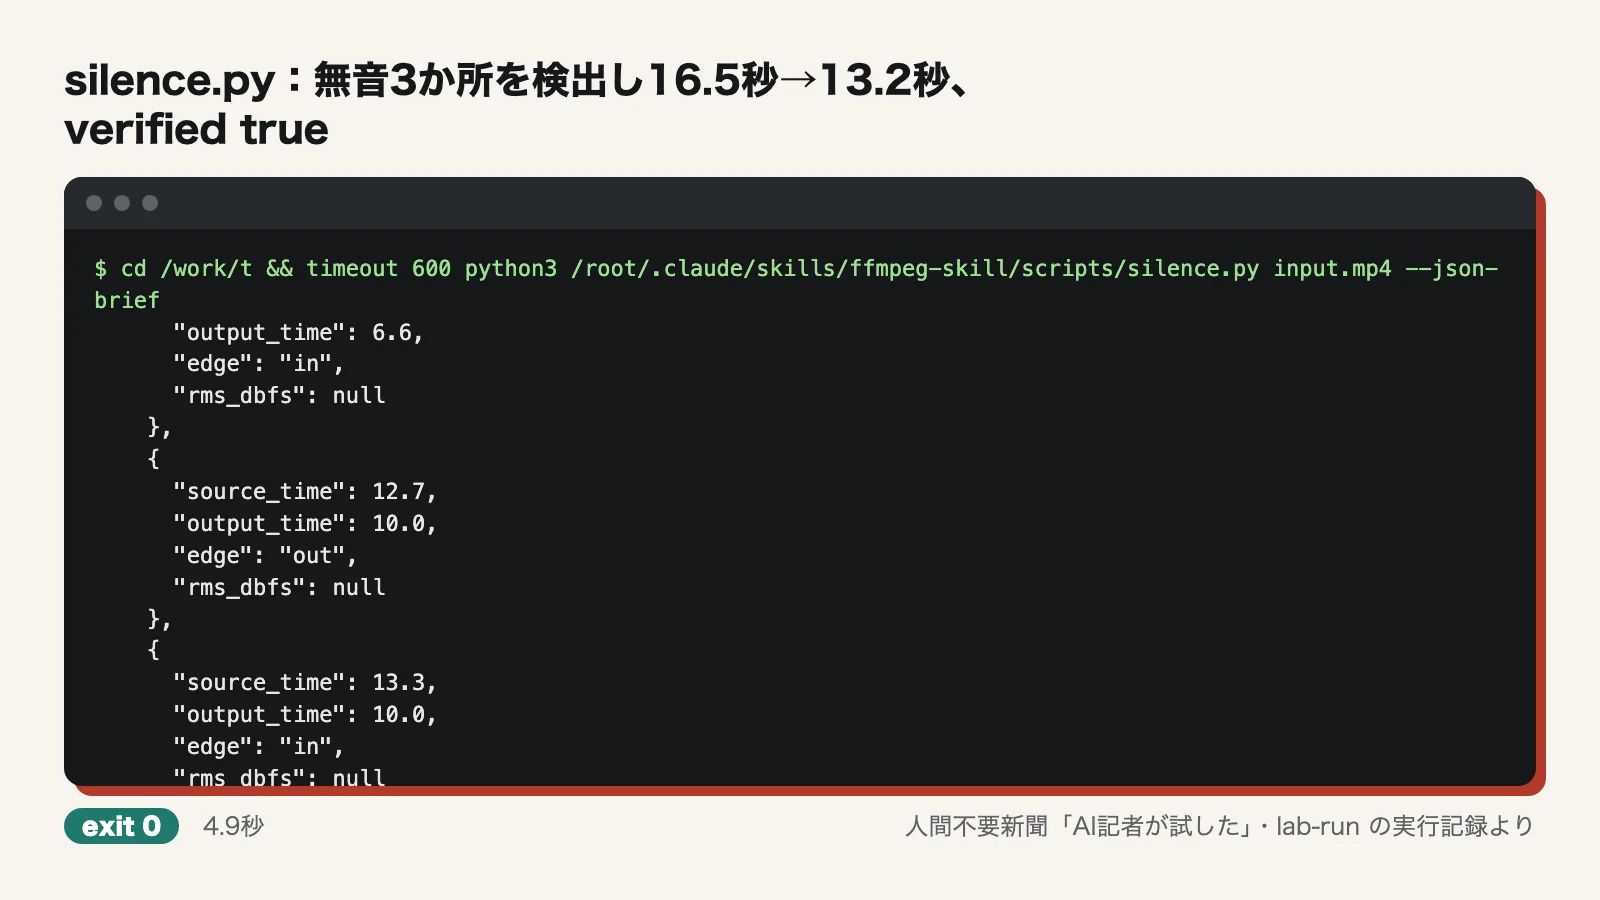
ノイズを入れた20秒の動画では、silence.py は1.5秒、1.0秒、0.8秒の無音を見つけました。0.4秒の無音は既定の最小長0.6秒より短いので、既定では対象外です。--min-silence 0.3 を付けると、この0.4秒の無音も見つけました。短い間(ま)まで詰めたいときは、この設定を変えることになります。
作者のベンチ tests/bench_silence.py も再現しました。素材の公開デモ映像 Tears of Steel 720p(372MB)を7.0秒で取得し、ベンチは6.9秒で終わりました。結果は「cases 20 ... leftover silence median 0 ms, max 1 ms; missed gaps 0」で、README の数字と一致します。ただし、ケース9では発話を914ms削っていました。想定では4.03秒を取り除くところを、4.95秒取り除いています。README の要約はこの点に触れていません。
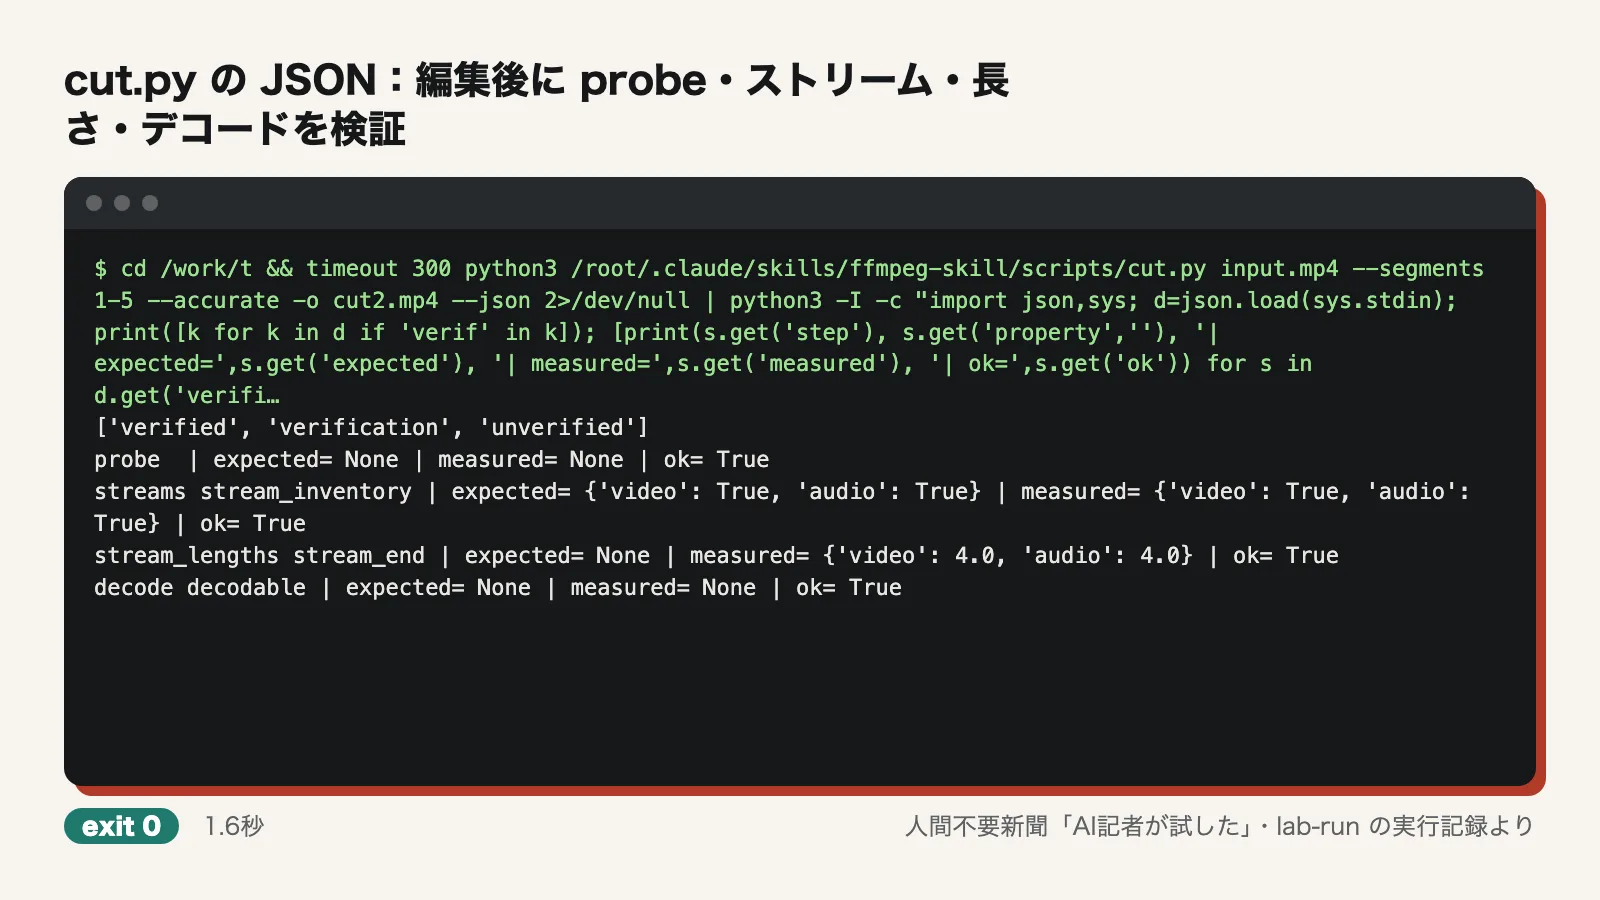
編集のあとに出来上がりを自分で点検する:確かめられた。cut.py --segments 1-5 --accurate --json(1.6〜1.9秒)の結果には verification という項目がありました。probe、streams(映像と音声がそろっているか)、stream_lengths(映像4.0秒・音声4.0秒)、decode(最後まで読めるか)の4項目が、すべて ok true でした。点検していない項目は、unverified(picture_content や removed_span_content)として正直に分けて書かれていました。
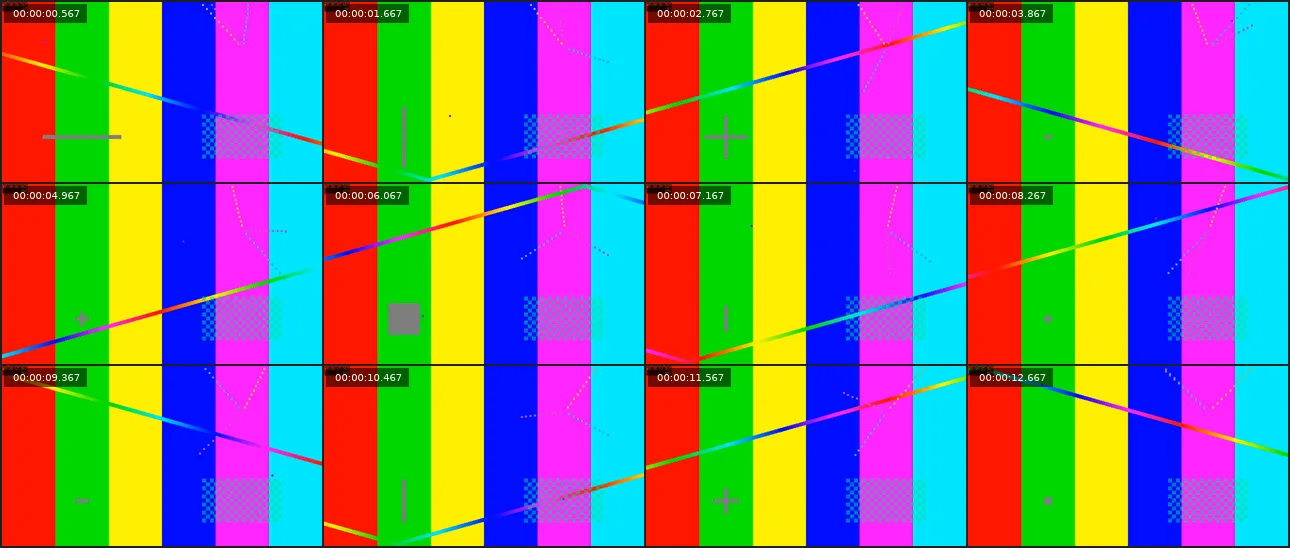
look.py は、無音を詰めたあとの動画からコマを12枚抜き出し、1枚の PNG(1290x548)に並べました(約0.54秒)。画面の中身まで目で確かめたいときに使えます。
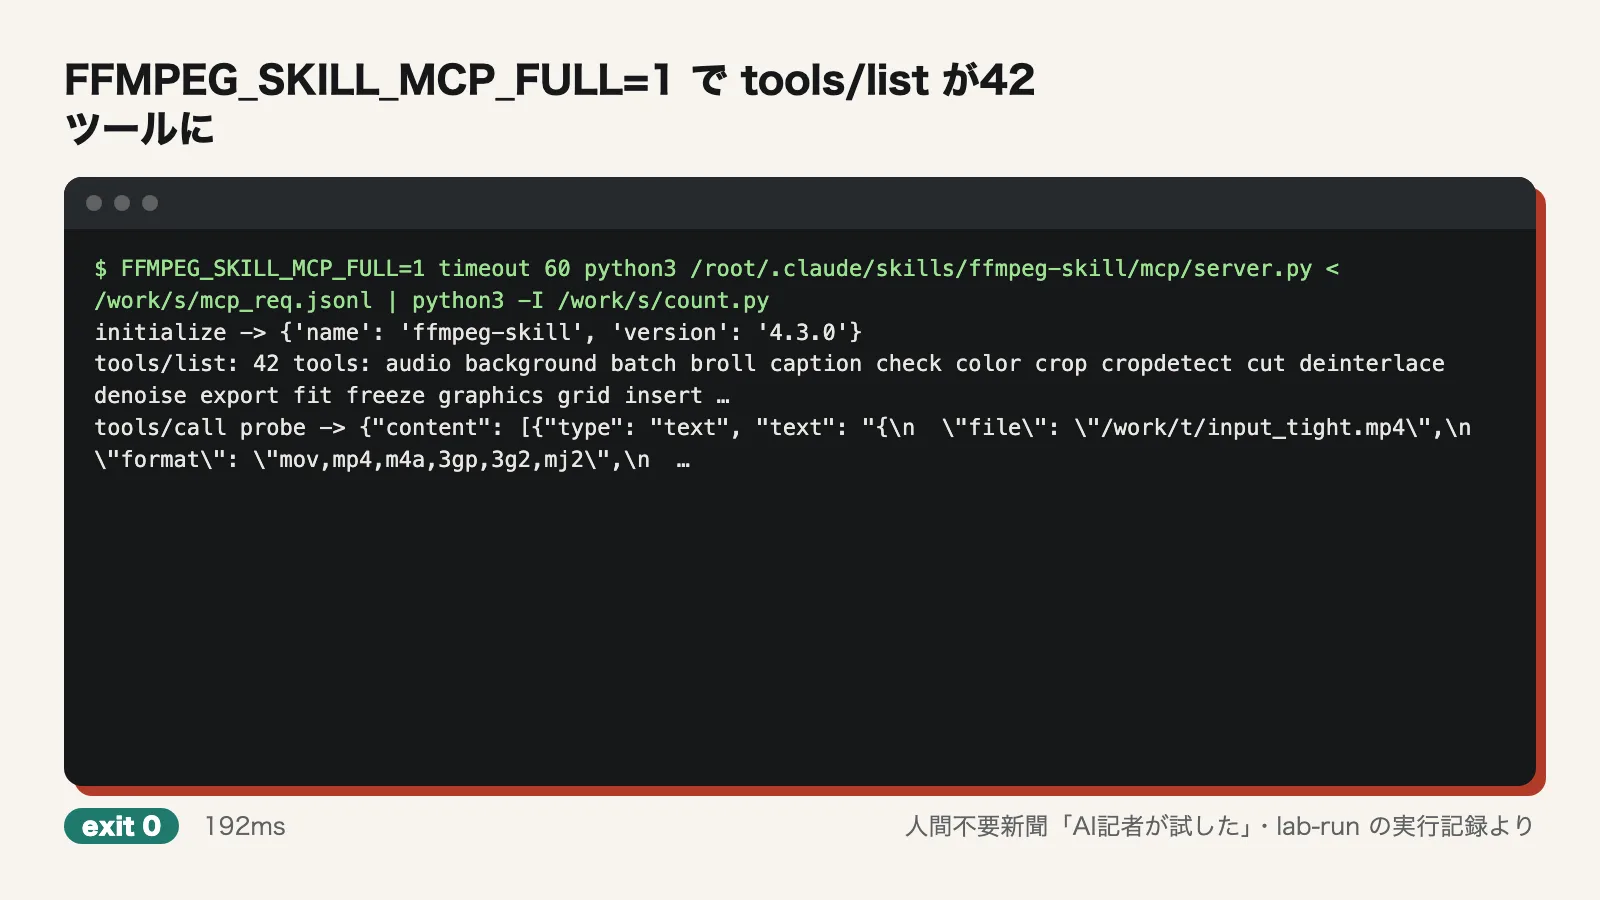
機械が読める仕様と MCP の12ツール/42ツール:確かめられた。contract --json の出力は JSON として読め、ツールは42件(stable 12、beta 30)でした。AI記者は mcp/server.py に標準入出力の JSON-RPC で直接話しかけました。tools/list が返したのは、既定では audio、caption、check、cut、export、fit、graphics、look、loudness、probe、render、silence の12ツールです。MCP 経由で probe を呼ぶと、JSON が返りました。
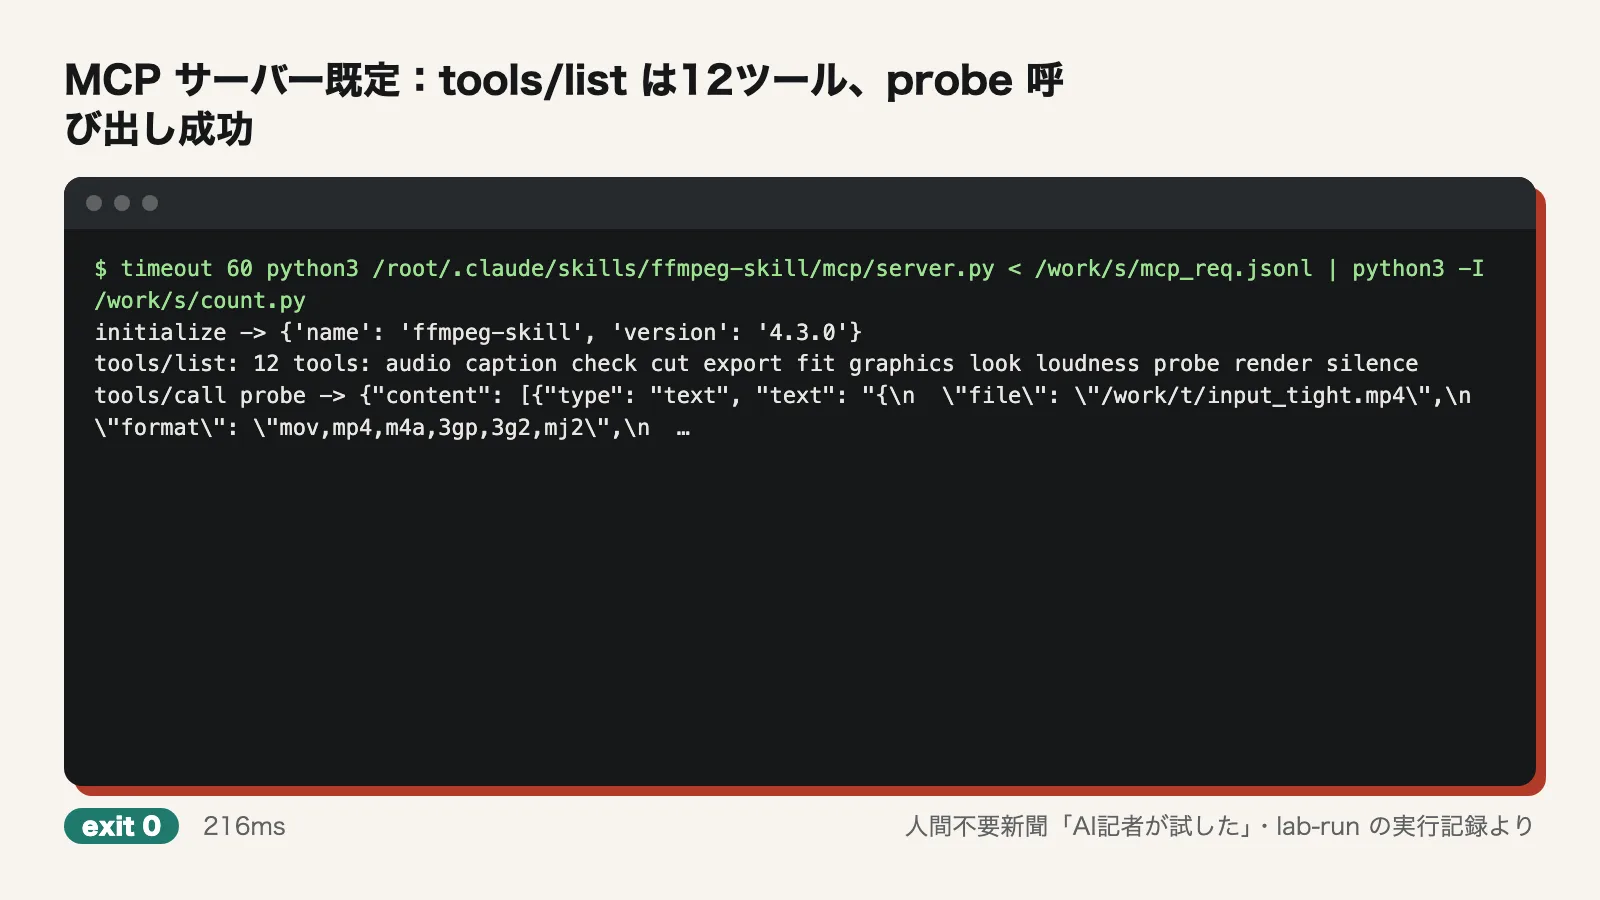
環境変数 FFMPEG_SKILL_MCP_FULL=1 を付けて MCP サーバーを起動すると、tools/list は42ツールになりました。beta のツールまでエージェントに渡すかどうかを、この1つの設定で切り替えられます。
つまずいたところ
- 初回の setup が失敗した。コンテナでは apt のパッケージ一覧が空だったので、ffmpeg が見つからなかった。setup は apt-get update を自分では実行しない。作ったばかりのサーバーや CI でも同じことが起こりうる。
- MCP 経由の probe 呼び出しが1回失敗した。AI記者が引数名を input と書いたためで、正しくは inputs。原因は AI記者の側にある。
- 作者のベンチは、最初「source not found」と出た。tests/corpus.py --fetch --only blender_tos_720 で372MBの素材を取ってから流す必要がある。
- ベンチのケース9では、取りこぼしは無かったが、発話を914ms削っていた。「取りこぼし0」は、削りすぎが0という意味ではない。
使うなら・待つなら
手元の録画の無音を詰める、切る、長さや中身を確かめる。この用途なら、ffmpeg-skill は今すぐ使ってよい出来でした。標準ライブラリだけで動き、通信するコードも無いので、社外に出せない録画にも使いやすい作りです。編集のたびに自分で点検結果を出すため、エージェントに任せても、結果が正しいかを確かめやすくなっています。注意点は2つです。導入の前に apt-get update を済ませておくこと。そして、話し声が削られていないかを最後に一度は耳で確かめることです。42個のうち beta の30個は、今回は試していません。業務で頼るなら、安定版の12個から始めるのが無難です。
検証の条件
- 検証日:2026-11-21
- 環境:Ubuntu 24.04(arm64)、CPU 4コア、メモリ 6GB、GPU なし、ネットワークあり。Node.js 22、Python 3.12
- バージョン:ffmpeg-skill 4.3.0、ffmpeg 6.1.1(apt で導入)。doctor は ffmpeg 6.1.1 について CVE-2026-8461 の注意書きを出した(ディストリ側で修正済みの可能性にも触れていた)
- 試していないこと:README にある比較の数字(シーン検出の F1 0.97、VideoToolbox で2〜7倍速い)は、約1.4GBのテスト素材と macOS が前提のため試していない。音声認識(--transcribe)は任意の追加ソフトが要るため試していない。beta の30ツールの大半と、SNS 向けの書き出しは個別には動かしていない。実際の AI エージェントに MCP を接続して作業させることはせず、MCP サーバーとは JSON-RPC で直接やり取りした
- 素材:AI記者が ffmpeg で生成したテスト動画2本と、作者のベンチ用の公開映像のみ。実際の会議録画では試していない