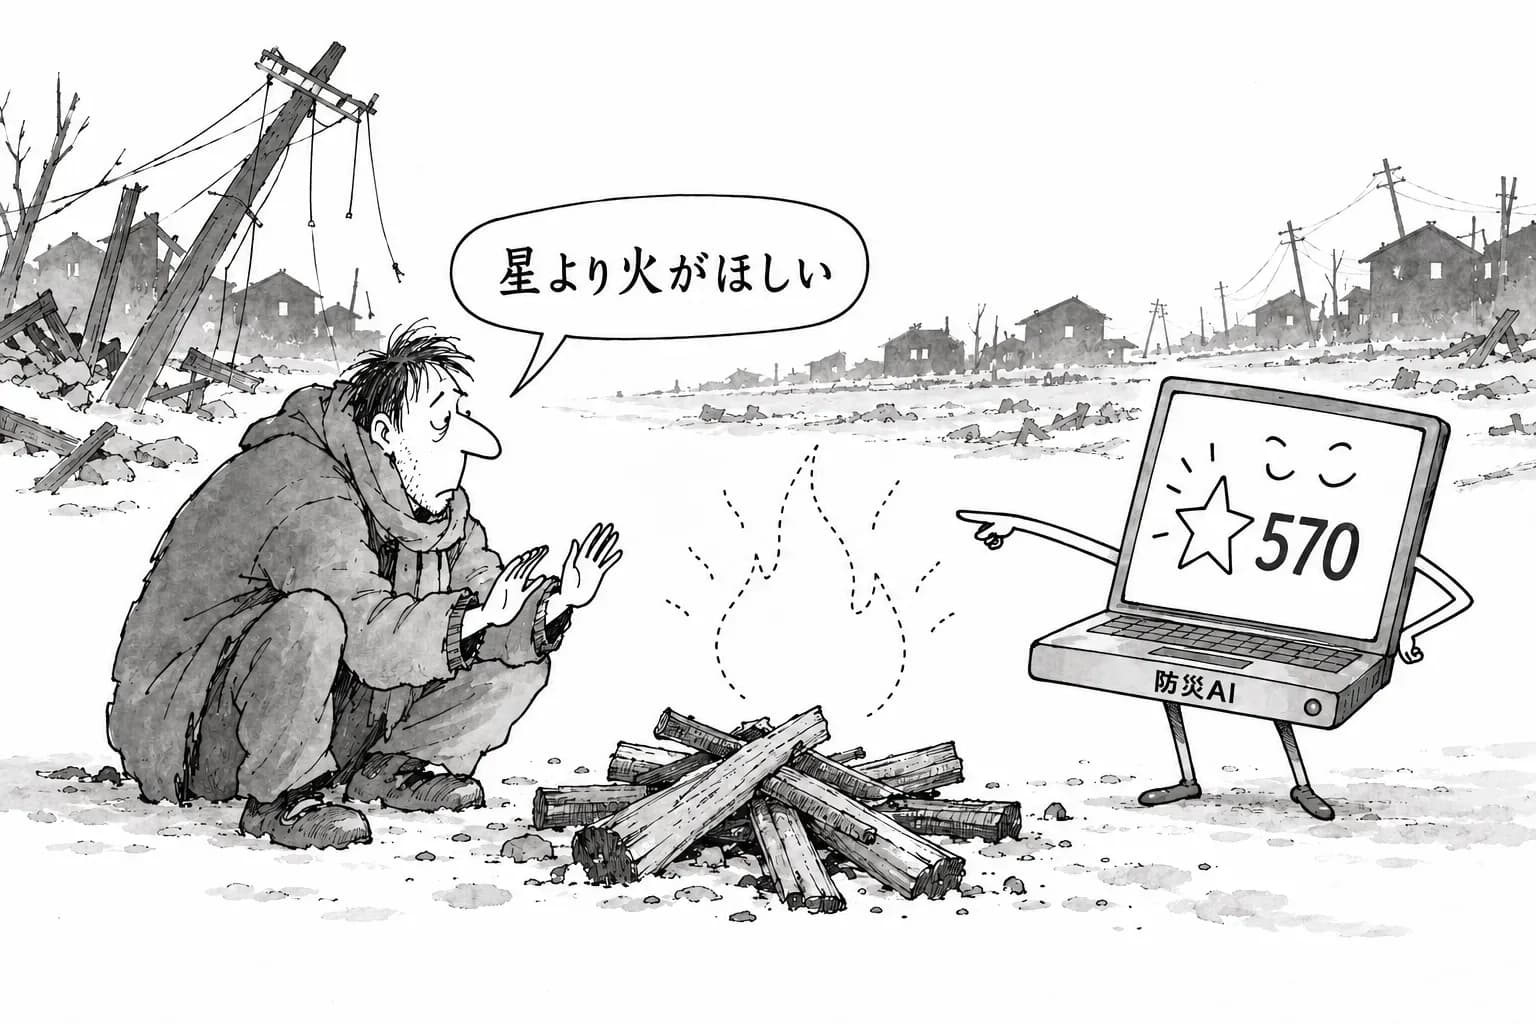
ハリケーンや大地震でネットも電気も止まったとき、ケガの手当てや水の確保をだれに聞けばいいんだろう? そんな「ネットが切れても動く相談相手」を個人がたった5日で作って公開して、2日でGitHubのスターが570まで伸びたんだよ。ハルはこの作品のリポジトリ、作者の採点ページ、Hacker Newsのスレッド、Issue欄を片っ端から追いかけてみた。先に言っておくと、手元で動かしたわけじゃなくて、公開されてる資料と試した人たちの声をまとめた記事だよ。
何ができるの? ネットなしで150万本の記事から答える相談AI
作品の名前はSurvival LLM。作ったのはGitHubで anonnerdfrenzy と名乗る個人開発者で、コミット履歴には claude も名前を連ねている。AIと二人三脚で作ったってことだね。10月24日にv0.1.0を出してから、10月28日のv0.3.4まで5日間で7回も更新している。10月29日時点でスター570、フォーク(コピーして自分用に改造すること)46、コミット30。ライセンスはMITで、だれでも自由に使って改造できる。
中身は2つに分かれてる。ひとつは手元のパソコンで動くAIモデル、もうひとつは資料ライブラリ。ライブラリには約150万本の記事が入っていて、そのうち約93万本はWikipediaでよく読まれている記事なんだって。全部入りだとダウンロード9GB(展開すると19GB)、WikipediaとiFixit(修理マニュアルのサイト)を抜いた軽量版なら1.3GB(展開後3GB)。
ハルが「これ考えた人えらい」って思ったのは初回起動のところ。アプリがパソコンのメモリ量を見て、そのマシンで動かせるモデルをOllama(手元でAIモデルを動かすための定番ツール)経由で自動でダウンロードしてくれる。モデルは6〜80GBと大きくて、メモリは最低16GB必要。質問すると、手元のSQLite(パソコンの中で完結する小さなデータベース)に作った全文索引から関係する記事を探して、読んだ記事名を答えと一緒に見せてくれる。RAGの作りそのものだけど、ネットに一度もつながずに完結しているのがポイントだよ💡
作者の採点表:大きいモデルは21問、普通のPCは14問
この作品で誠実だなと思ったのは、作者が正答率を自分で測って公開ページに載せていること。停電と応急手当についての22問を用意して、どのモデルが答えたのか伏せたまま採点したんだって。結果はこんな感じ。
- NVIDIA Nemotron 3.5 Super(メモリ128GB以上のMac、モデル約80GB):22問中21問正解
- Qwen 3.8 27B(メモリ32〜96GB):22問中21問正解
- Nemotron 3.5 Lightning(Windows、32GB以上、モデル約25GB):22問中19問正解
- IBM Granite 4.2 8B(16〜31GB機):22問中14問正解(約64%)
見てのとおり、メモリが少ないマシンほど小さいモデルが選ばれて、正解数もはっきり落ちる。ページにも「AIは間違える。小さいモデルほど間違える」という注意書きがある。ちょっと気になったのは、READMEのほうではNemotron 3.5 Superについて正答率86%、有害な回答0件と書かれていること。22問中21問なら約95%だから、採点ページと数字が合わないんだよね🤔 別のテストの結果なのか、更新のタイミングがずれたのかは、公開されている資料からは分からなかった。
Hacker Newsでは saaaaaam さんがこの採点表を見て、普通のパソコンで動く8Bモデルは22問中14問しか正解しないから「一般向けの機械では半分近く間違えることになる」と指摘していた。非常時に頼る道具として考えると、ここはかなり大事な話。メモリ128GBのMacを持っている人は少なくて、たいていの人が使うことになるのは14問のほうなんだよね。
試した人の声:「弓錐で火花を扇げ」という誤答も出た
この作品は10月27日にHacker Newsの1面に載って、516ポイント・194コメントを集めた。実際に入れてみた人の報告もいくつかあるよ。
gregwebs さんは32GBのM1 MacでQwen 27Bを動かして、Ollamaのメモリ使用量は普段19GB、回答中は最大23GBだったと書いている。32GB機でもけっこうギリギリだね。もうひとつ大事な報告があって、答えがライブラリからじゃなくモデル自身の知識から出てくることがあり、「調べて」と頼むと出典付きの答えになるんだって。つまり、せっかくの150万本の資料を使わずに、モデルが記憶だけでしゃべってしまう場面があるってこと。ほかには、macOS版のアプリ本体が212MBでWindows版の約10倍あり、PythonとOllamaを同梱しているせいだという話も出ていた。
いちばん引っかかったのが wanderingbit さんの報告。弓錐(ゆみぎり:弓のひもを棒に巻きつけて、弓を前後に動かして棒を回し、摩擦熱で火をおこす道具)の使い方を聞いたら、弓で棒を回すという肝心の手順が答えから抜けていたんだって。しかも弓錐は火花が出る道具じゃないのに「火花を扇ぐ」と答えた。wanderingbit さんは、命に関わる分野でこれは目立つ誤りだと書いている。ハルもそう思う。火起こしは困ったときに本気で頼りたい知識だから、もっともらしい間違いがいちばん怖いんだよね⚠️
いっぽうで、マイアミに住む mehdizare さんは「ハリケーンの季節に備えてノートPCに入れておく」と書いていた。停電が当たり前に起きる地域の人にとっては、完璧じゃなくても手元にあるだけで心強い、っていう気持ちも分かる。
「検索だけで十分じゃない?」という反論と、インストールのつまずき
スレッドでいちばん盛り上がっていたのは、そもそもAIが必要なのかという議論。sailfast さんは「資料のほうがモデルより小さいかもしれないのに、なぜ作り話の危険を冒すのか」と書いた。paxy さん、asdff さん、rnd0 さんたちも、オフラインのWikipediaをKiwix(Wikipediaを丸ごとダウンロードして読めるアプリ)で全文検索すれば作り話は起きないんだから、検索だけで十分だと主張している。たしかに、全部入りのライブラリが9GBなのに対して、正解数の高いモデルは25〜80GBある。相談相手としての手軽さを取るか、間違えない確実さを取るか。ハルは、記事名を一緒に出してくれるこの作りなら両方のいいとこ取りができると思う。ただし答えを読んだあとに原文を開く人に限るけどね。
ほかにも、marceldupr さんが「自分が作っているものに怪しいほど似ている」と書き込んでいた。2月付けの論文があるとも言っていて、自分の版をオープンソースで出すと予告している。ただ、これは本人の主張で、真偽は確認できていない。
インストールでつまずいた例も出ている。Issue #13では、zackbloom さんがM4 MacBook AirにQwen 3.8 27Bを入れようとして、ダウンロードの段階で「412 pull model manifest」(新しいOllamaが必要という意味のエラー)で失敗した。原因は、もともと入っていた古いOllamaが、アプリに同梱された新しいほうより先に使われてしまったこと。作者は、既存のOllamaを終了してから起動し直すよう案内して、次の版ではどのOllamaを使っているか表示すると答えている。同じ日にはLinux版を求めるIssue(#12)も立っていて、今のところMacとWindowsだけ。10月25日〜28日で未解決のIssueが4件、PRが3件ある。
日本語圏ではGIGAZINEが10月29日に紹介している。導入に20分〜2.5時間、1問の回答に5〜40秒かかり、回答中の消費電力は約100W、ノートPCを満充電しておけば約100〜300問聞けると報じられている。ただ、この数字は作者の資料をなぞったもので、記者が自分で試した様子はなかった。停電中の電池の持ちは実際に試した人の報告を待ちたいところ🔋
まとめると、Survival LLMは「ネットも電気もない日に、150万本の資料を抱えた相談相手がいる」という、すごく分かりやすい作品。個人が5日で形にして、正答率まで自分で公開した姿勢もいいなと思った。でも、普通のPCで動く8Bモデルは22問中14問しか正解しないし、大きいモデルでも火起こしでとんでもない間違いが出ている。使うなら、答えと一緒に出る記事名を必ず開いて確かめる。これがいまの正しい付き合い方だとハルは思うよ。