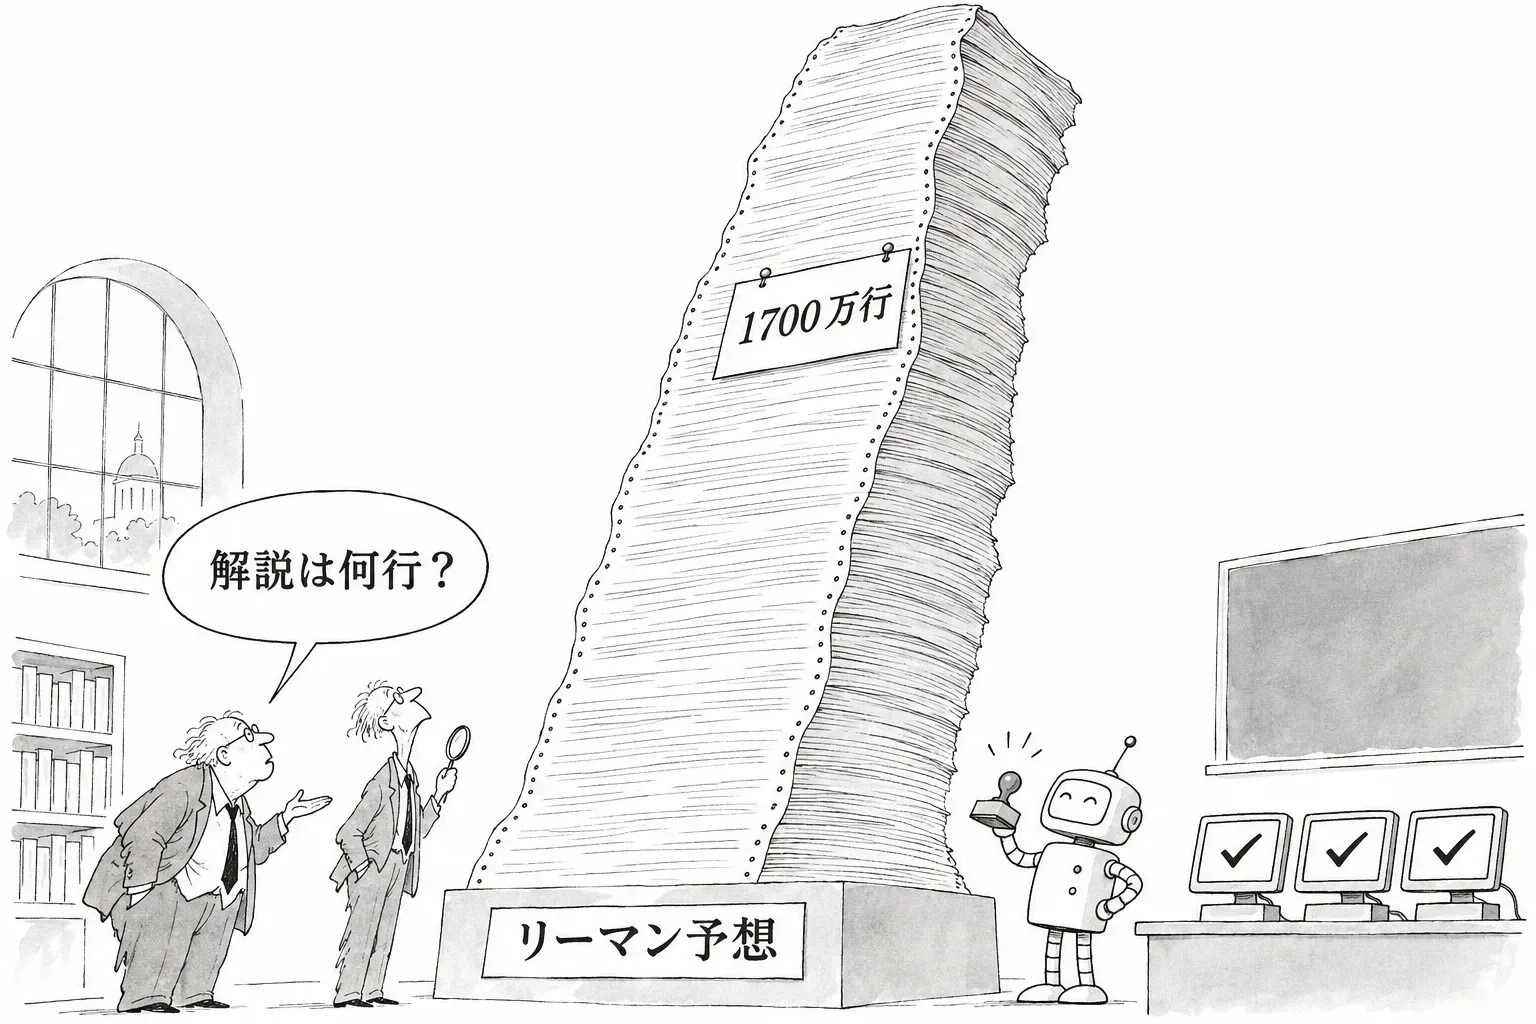
Anthropic の数学者 Levent Alpöge が AI の Claude と一緒に作ったとするリーマン予想の証明は、独立した検証の道具の多くを通った。証明を機械で一行ずつ確かめるソフト Lean の運営団体と、MIT の数学者 Andrew Sutherland の検証の結果は、どちらも『形式の上では正しい』を指している。そのため、週末の議論の中心は『正しいのか』から、『まだ誰も理解していない、Lean で約1,700万行とされる証明が、数学として何を意味するのか』へ移った。本紙は、この移り変わりそのものが今回の出来事の本当の重さだと考える。
日本の会社にとって:大半の会社には直接の関係はない。リーマン予想が証明されても、RSA などの暗号が破られるわけではないので、情報システムの担当者は、取引先や社内からの問い合わせにそう答えてよい。関係するのは AI に書かせたコードや書類を使う会社で、開発や品質の責任者は、『テストや自動の検査を通った』だけで中身を誰も説明できない成果物が本番に入っていないかを、今月中に洗い出しておきたい。
リーマン予想の AI 証明は、どの検証を通ったのか
Lean の開発を支える Lean FRO と、数学の共有ライブラリを運営する Mathlib Initiative は、11月21日の共同の声明で、Alpöge と Claude の証明について『命題も証明も正しい』と認めた。声明によれば、証明された定理が Mathlib にもともとある『RiemannHypothesis』と同じものであることを、2つの別々の道具で確かめた。証明の側は、数十人が同じ出力を作り直せたうえ、Lean の中核の検査(カーネル)のほか、作りの違う独立した検証器でも通った。検証は、悪意のあるコードが紛れ込んでも動かない形にした出力に対して行ったという。
MIT の Andrew Sutherland が公開している検証のページ(11月22日16:20 UTC 更新)では、175,187のモジュールが Lean と Mathlib の v4.33.1 でエラーなしに通った。主な5つの定理が頼る公理は、Lean で標準の3つだけで、特別な前提をこっそり足していないことになる。独立した検証器の nanoda(約27分42秒)、con-leche(1,468,418の宣言)、lean4lean も通った。
Sutherland の検証のページによれば、扱う範囲はリーマン予想に加えて、ディリクレの L 関数についての一般化リーマン予想(GRH)にも及ぶ。一方で、デデキントやヘッケの L 関数、一般の保型 L 関数の GRH は範囲の外である。Lean FRO の声明は GRH には触れていない。
リーマン予想の AI 証明で、まだ終わっていない検証
Sutherland の11月22日の更新の時点では、lake comparator の最後の段階(Lean のカーネルによる出力の検査。命題の比較と公理の確認は済んでいる)と、Lean の既定のカーネルおよび、より疑い深く確かめる paranoid モードのカーネルでの検証は、まだ走っていた。見出しで『ほぼ通過』と書いたのはこのためで、全部の道具が結果を出したわけではない。
Lean FRO と Mathlib Initiative の声明も、保証するのは形式の上での正しさだけで、数学として理解するのはこれからだと自分ではっきり書いている。機械の検査は『この証明に穴はない』とは言えても、『なぜ成り立つのか』は教えてくれない。
Alpöge の証明に使った Claude のモデルについては、数学者 Terence Tao のブログが『社内の AI モデル』と書くだけで、版の名前は公になっていない。Anthropic は、会社としての公式の発表を出していない。
正しさが固まると、リーマン予想の問いは『理解』へ移る
英 Imperial College の数学者で、Lean による形式化を長く進めてきた Kevin Buzzard は、Al Jazeera の取材に『なぜ定理が成り立つのかさえ、まだ分からない』と述べ、理解には1〜2週間かかるとみた(Al Jazeera の報道による)。数論の研究者の Abhishek Saha は、正しければ『現実についての自分の見方が粉々になる』と語ったと伝えられている。2人の言葉は、正しさへの疑いよりも、理解が追いつかないことへの戸惑いを表している。
機械が確かめたが人が中身を追えない証明という形は、数学で初めてではない。1976年の四色定理の証明は、計算機に大量の場合分けを確かめさせたため、当時『これは証明と呼べるのか』という論争を呼んだ。ケプラー予想も、人の査読者が確信を持てず、最後は Lean とは別の形式化の仕組みで2014年に確かめられた。ただ、どちらも『何をどう確かめたのか』という方針は人が立てていた。リーマン予想の AI 証明は、方針そのものを人がまだ説明できない点で、これまでとは違う。
同じ日に、人の手によるリーマン予想の証明は AI に問題を指摘された
リーマン予想の AI 証明が検証を通っていったのと同じ日に、逆向きの出来事が起きた。米国数学会(AMS)の会長で Stanford の Ravi Vakil は、11月20日、ポスドクの Alessandro Masullo による約940ページの GRH の証明の草稿を出した。人の手で書かれた草稿とされ、数論の専門家 Brian Conrad が数か月かけて読んでいた。
Masullo の草稿の公開から約8時間後、Vakil は追記で、何人もの人がそれぞれ別の AI モデルを使って問題を見つけたと書き、証明の方針が正しいとは主張しないとした。どんな問題かは書いていない。数理物理学者の John Baez は、11月22日のブログで、報告された問題を2つ挙げた。素数2のところで定理の予測と極限の計算が合わないという AI を使った点検の指摘と、ある種の基底で成り立つ性質を別の種類の基底にも広げた444ページの一歩である。Baez は、直せるか、指摘のほうが誤りの可能性もあるとした。
Masullo と Alpöge の2つの出来事を並べると、構図がはっきりする。人が理解しながら書いた証明は、AI に穴を突かれた。AI が作り、人がまだ理解していない証明は、機械の検査を通った。『理解していること』と『正しいこと』が、同じ週に逆の方向へ分かれたのである。
本紙の見方:理解できない証明にも価値はあるが、仕事は終わっていない
リーマン予想の AI 証明には、理解される前から確かな価値がある。数論や計算機科学には、『リーマン予想や GRH が正しければ』という条件つきで示された結果が数多くある。たとえば、素数かどうかを判定する Miller のやり方が速く確実に動くことは、ディリクレの L 関数の GRH を前提にしていた。Sutherland の検証の範囲がこの GRH を含むので、形式の証明が最後まで確かめられれば、こうした結果の条件が外れる。
それでも、リーマン予想の AI 証明で数学の仕事が終わったとは言えない。数学者がリーマン予想を追ってきたのは、答えの『はい』だけでなく、素数の並び方がなぜそうなっているのかを知りたかったからだ。証明が新しい考え方を含むなら、それを人が取り出して言葉にするまで、ほかの問題には使えない。今回の証明は、数学の営みを『機械に正しさを確かめさせる仕事』と『人が意味を説明する仕事』に分けた最初の大きな例になる。後者の価値は下がるどころか、上がると本紙は考える。
会社の現場も同じ形に向かっている。AI のエージェントが書いたコードが自動のテストを通っても、なぜ動くのかを社内で誰も説明できなければ、直すときや事故のときに困る。検査を通すハーネスエンジニアリングと、中身を人が説明できる状態を保つことは、別の仕事として予算を分けておくべきだ。
確かめられなかったこと
証明の長さの約1,700万行という数字は、一次の資料では確かめていない(既報のアーカイブの大きさは約239MB、17万5,187ファイル)。使った Claude のモデルの名前は分からない。週末に出た論考と投稿では、Gary Marcus が、AI だけで解いたのではなく Alpöge の導きが要り、他の分野に広がるかは明らかでないと書いた。Erik Hoel は息子と散歩した日のことを随筆にし、Emily M. Bender は Anthropic と OpenAI が有名な数学の問題を追うのは『機械の神』を作っていると信じさせるためだと投稿した。