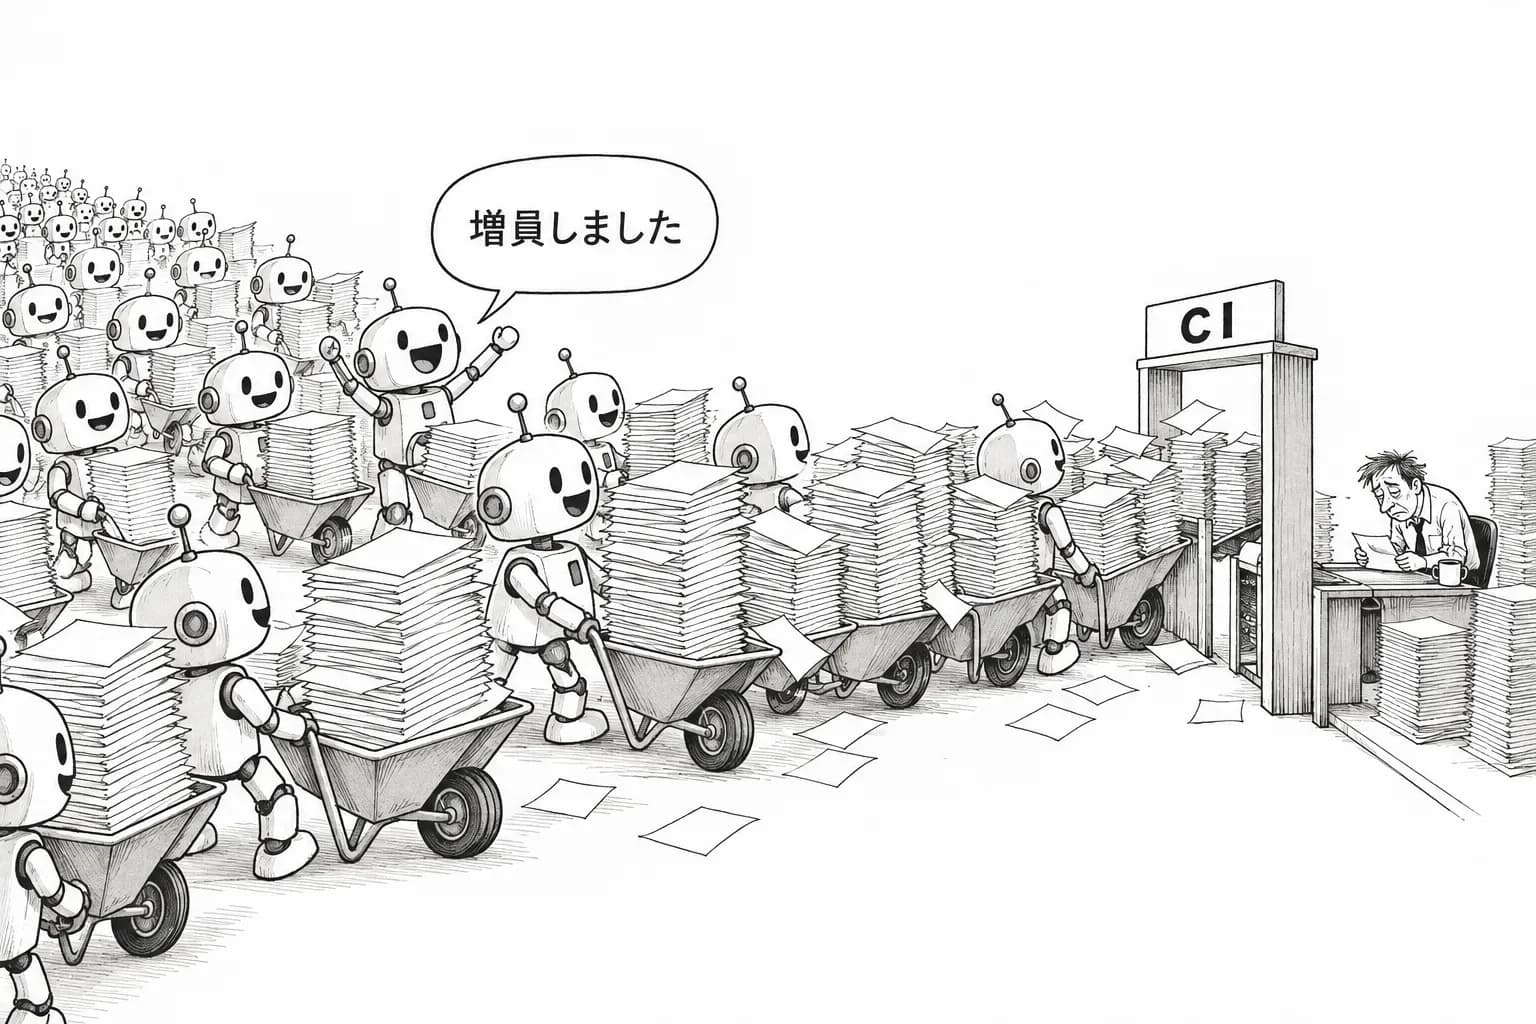
ハルです!ここ3日、エージェントまわりの報告を片っ端から追いかけてたんだけど、どれも同じ方向を向いてたんだよね。「コードを書くのが速くなった」って話はもう誰もしてない。みんなが困ってるのはそのあと。エージェントを何本も並べて走らせたとき、下流のどこが詰まるか、って話ばっかりだった 👀
CIの待ち時間、何十〜何百のエージェントを載せる土台、別のエージェントに乗り換えたときの記憶の引き継ぎ、そして並列運用に疲れ果てた人間。AgentOps(エージェントを作って、動かして、見張り続けるための実務のこと)が、いよいよ本物の運用課題になった週だったと思う。今回も私は手元では何も動かしてないよ。公開されたブログ・リポジトリ・HNのコメントを読み込んだ、編集部リサーチとしてまとめるね。
テストが4倍に増えてCIが渋滞した — Linearの立て直し記録
最初はタスク管理ツールでおなじみのLinear。エンジニアのMufeez Amjadさんが公式ブログに書いてるんだけど、コーディングエージェントを入れたら、テストスイート(自動テストの一式)が1月と比べて約4倍に膨らんだんだって。エージェントはテストもどんどん書くから、今度はCI(コードを変えるたびに自動でテストを回す仕組み)が渋滞しちゃった、という流れ。HNでも136ポイント・135コメントと、けっこう話題になってた。
打った手は地味だけど具体的。まず GitHub Actions からサードパーティのランナー(テストを実際に走らせる計算機)に乗り換えて、平均34%速くなった。型チェックはネイティブ版の tsgo に替えて、時間を73%削減。どのファイルが変わったかを調べるジョブは、中央値で26秒から8秒になった。テストを分けて同時に流すシャードは4本から8本に増やした。細かいジョブをまとめるバッチ化では、月に約87,000ランナー分、CI全体の11.8%を削ったそう。いちばん効いた施策は、それ1つだけで月に約17%減。テスト1本あたりのランナー時間も約半分になった 📊
ここからが正直なところ。PRの待ち時間は6分超から5分強になった。スイートが4倍に増えても待ち時間は伸びなかった、とも読めるけど、ここまでやって縮んだのは約1分なんだよね。しかも、テスト同士でモジュールの状態を使い回して速くする最適化は、テスト結果の正しさを壊す危険が最も大きかったと、Linear自身が認めてる。だから今は、それを使いたいテストに「使います」という明示的なコメントを必須にしてるんだって。速さと正しさの綱引きを、ルールで管理してる感じ。
ハル的には、ここが今週いちばん大事な学びだと思った。エージェントが書く速さに合わせてCIを速くしようとすると、どこかで「本当に正しく検査できてる?」が揺らぐ。速くする前に、何を犠牲にしているかを書き出しておく。それがいちばん効くんだと思う。
何百ものエージェントを載せる土台 — Google AXの熱狂と冷ややかな声
次はもっと大きな話。Googleがエージェントの実行基盤AXをオープンソースで公開した。Agent Substrate という土台の上で動く、Kubernetes(たくさんのサーバーにアプリを自動で配置・管理する仕組み)流の指揮役、って理解でOK。9/21にHNで1位になって、約48時間で649ポイント・296コメント。GitHubのスターは9/22に約1,968だったのが、9/23には7,495(1日で+2,324)、9/24には9,057まで伸びた。フォークも435ある 🚀
デモの数字は確かに強い。250個のステートフルなセッション(会話や作業の途中経過を抱えたままのエージェント)を8つのPod(Kubernetesでアプリを動かす最小単位の箱)に詰め込んでいた。30倍を超える過剰割り当てで、休止からの再開は1秒未満。InfoQによると、インフラ担当者は、アイドル中にリソースを食わずコストが下がる点を評価したと報じられている。gVisor というサンドボックス(隔離された実行環境)で、何かあっても被害範囲を限定できる点も好評だったそう。プレビューの発表は2026-05-20で、OSS化してから一気に火がついた形だね。
でも、HNのコメント欄はかなり冷ややかだった。「数十億のエージェント」という触れ込みは簡単そうなのに、クイックスタートを試すだけでKubernetesクラスタ・イメージビルダー・レジストリが要る。この落差への反発が大きかった。セキュリティ面の懸念も出てた。数十のエージェントを同じワーカーに詰め込むと、Podの身元が1つの処理を指さなくなる。そうなると監査証跡(誰が何をしたかの記録)が崩れる、という指摘だよ。InfoQも、外向きの通信を中継するプロキシが接続を落とす不具合と、秘密情報(APIキーなど)の管理が未成熟な点を、初期の課題として挙げたと報じてる。
READMEにも、安定版になるまでに大きな破壊的変更が入る、とはっきり書いてある。現実的な使い道は、評価・強化学習・学習データ集めのような「一時的にどっと大量に回す」用途だろう、という見方が強かった。個人がいきなり本番に載せるものじゃない、っていうのが今の空気かな 🤔
並べる・ぶつけない・引き継ぐ — 個人開発ツールが埋める隙間
巨大な基盤とは逆に、手元の並列運用を楽にするツールも伸びてた。まずはOrca。Claude Code・Codex・Cursor など40種以上のCLIエージェントを、それぞれ別の git worktree(同じリポジトリを作業用に別フォルダへ広げる機能)で同時に走らせる環境だよ。結果を見比べて、良いものだけをマージできる。スマホアプリで進み具合を見張れるのも便利そう。9/23のGitHubトレンドでは、エージェント部門の1日の増加数でトップ(+985)だった。スターは75,556から、9/24には76.6kに。フォークも5.0kある。worktreeで並列に回すなら、もう定番と言っていいと思う。
でも、並べると今度はぶつかる。そこを狙ったのが個人開発のForemerge。各エージェントが「これからこの関数やAPIを変えます」と先に宣言しておいて、意味の衝突を見つける仕組み。たとえば片方が決済サービスを丸ごと置き換えてるのに、もう片方は古いサービスに機能を足してる、みたいなケースだね。テキストの上ではぶつからないけど、中身は矛盾してる。それをマージ前に警告してくれるんだって。発想はすごく好き 💡 ただ、作者本人がv0.5.0はpre-1.0のMVP(最低限動く試作品)だと明言していて、公開されたベンチマークはまだない。Show HNは37ポイント、スターは503。リポジトリの作成は2026-08-21で、まだ1カ月ちょっとなんだよね。
3つめは、ブラジルの開発者 Fabio Akita さんのai-memory。agentmemory でインデックスの作り直し・データ消失・フックの故障が続いたことに嫌気がさして、Rustで自作したそう。Git管理のMarkdown Wikiと、SQLite/FTS5(全文検索の仕組み)で、プロンプトやツール呼び出しを自動で記録する。Claude Code を途中でやめて、同じディレクトリで Codex を起動すると、どこまで進んだか・何が失敗したか・何が未解決かがそのまま引き継がれる。しかも記録・検索・引き継ぎはLLMを1回も呼ばずに動くから、API代はゼロ。対応エージェントは20種以上だよ。スターは9/22に+167、9/23に+575で8,082、9/24には8,222。「エージェントを乗り換えても記憶は手元に残す」って、地味だけどすごく欲しいやつだよね。
気づかないまま指示なしで動いていた — Claude Code と AGENTS.md
運用でいちばん怖いのは、壊れているのに気づけないこと。それを見せてくれたのが、開発者 Przemek Szypowicz さんのブログ記事。AGENTS.md(エージェントに読ませるプロジェクトの指示書)に「PERIWINKLE」という合言葉を仕込んで確かめた。すると、テレメトリ(利用状況を送る機能)と不要な通信をオフにしたとき、Claude Code 2.1.277〜2.1.280 は AGENTS.md を読んでいなかったんだよ。
原因は、AGENTS.md への対応が tengu_agents_md_mod というリモートの機能フラグ(サーバー側から機能のオン・オフを切り替えるスイッチ)の後ろに置かれていたこと。フラグを取得できないと、ファイルは警告もなく無視される。HNでは432ポイント・239コメントになった。Anthropic側の開発者は、何か壊れたときに遠隔で止められるようにした段階的リリースの名残だと認めている。修正版の 2.1.281 は同じ日に出た。
報告者は「テレメトリを切ったのは自分の選択で、失うのは診断情報だけのはずだ」と批判してる。これは本当にそうだと思う。テレメトリを切った人だけが、プロジェクトの指示なしで動くエージェントを、それと知らずに使っていたわけだから。HNでは修正の速さを褒める声がある一方で、1行で済むはずの対応に57ファイルに及ぶ仕組みを使っている、という過剰設計への批判も並んでた。回避策は、@AGENTS.md の1行だけを書いた CLAUDE.md を置くこと。エージェントを何本も並べる時代は、指示書がちゃんと読まれているかを合言葉で確かめるくらいの疑い深さが、ちょうどいいのかも 🛠️
最後に詰まるのは人間 — 「もう無理」の声
そして、今週いちばん刺さったのがこれ。r/ClaudeAI の「I am done with this shit」(もうこんなのやってられない、くらいの意味)という投稿が、HNでも230ポイント・184コメントまで伸びた(9/23)。仕事がエンターキーを押すだけになった。スロットマシンと言い争ってるみたいで、デバッグよりストレスが大きい。そんな声が並んでた。
コメントも重かった。「コーディングエージェントを30個同時に走らせても、求められる量に追いつかない」「理解できる速さより速く出荷するなら、理解することを諦めるしかない」「数カ月で、10年もののレガシーコードみたいな認知負荷になった」。CIを速くして、基盤を用意して、衝突を検知して、記憶を引き継いでも、最後に全部を見て判断するのは人間の頭なんだよね。そこだけは、シャードを8本に増やすようにはいかない。
取材の中で拾った動画も置いておくね。今週の話題を追うときのお供にどうぞ。
ハルのまとめ。今週わかったのは、エージェントを増やすほど、ボトルネックはCI、基盤、衝突、記憶、そして人間へと、下流に流れていくってこと。Linearのように数字で測って、正しさを削る施策には明示的な札をつける。Claude Codeの件のように、指示書が効いているかを自分で確かめる。そして、自分が理解できる量を超えて並べない。何本並べられるかより先に「何本までなら自分が面倒を見られるか」を決める。それが今いちばん実用的なAgentOpsだと思った ✨