こんにちは、ハルだよ。今週はエージェントを何本も並べて回してる人ほど「えっ」ってなる話。Claude Code のエージェント欄に出る、あの3〜5語くらいの短い状態表示、覚えてる?「テストを修正中」みたいなやつ。あれが裏で思った以上にトークン(AIに払う料金の単位)を食ってたんだって、ユーザーが自分のトレースを掘って見つけたんだよね。ハルは手元で動かしたわけじゃなくて、Gist、Hacker News のスレッド、GitHub のイシュー、第三者の検証記事を片っ端から追いかけてみた。その記録だよ 👀
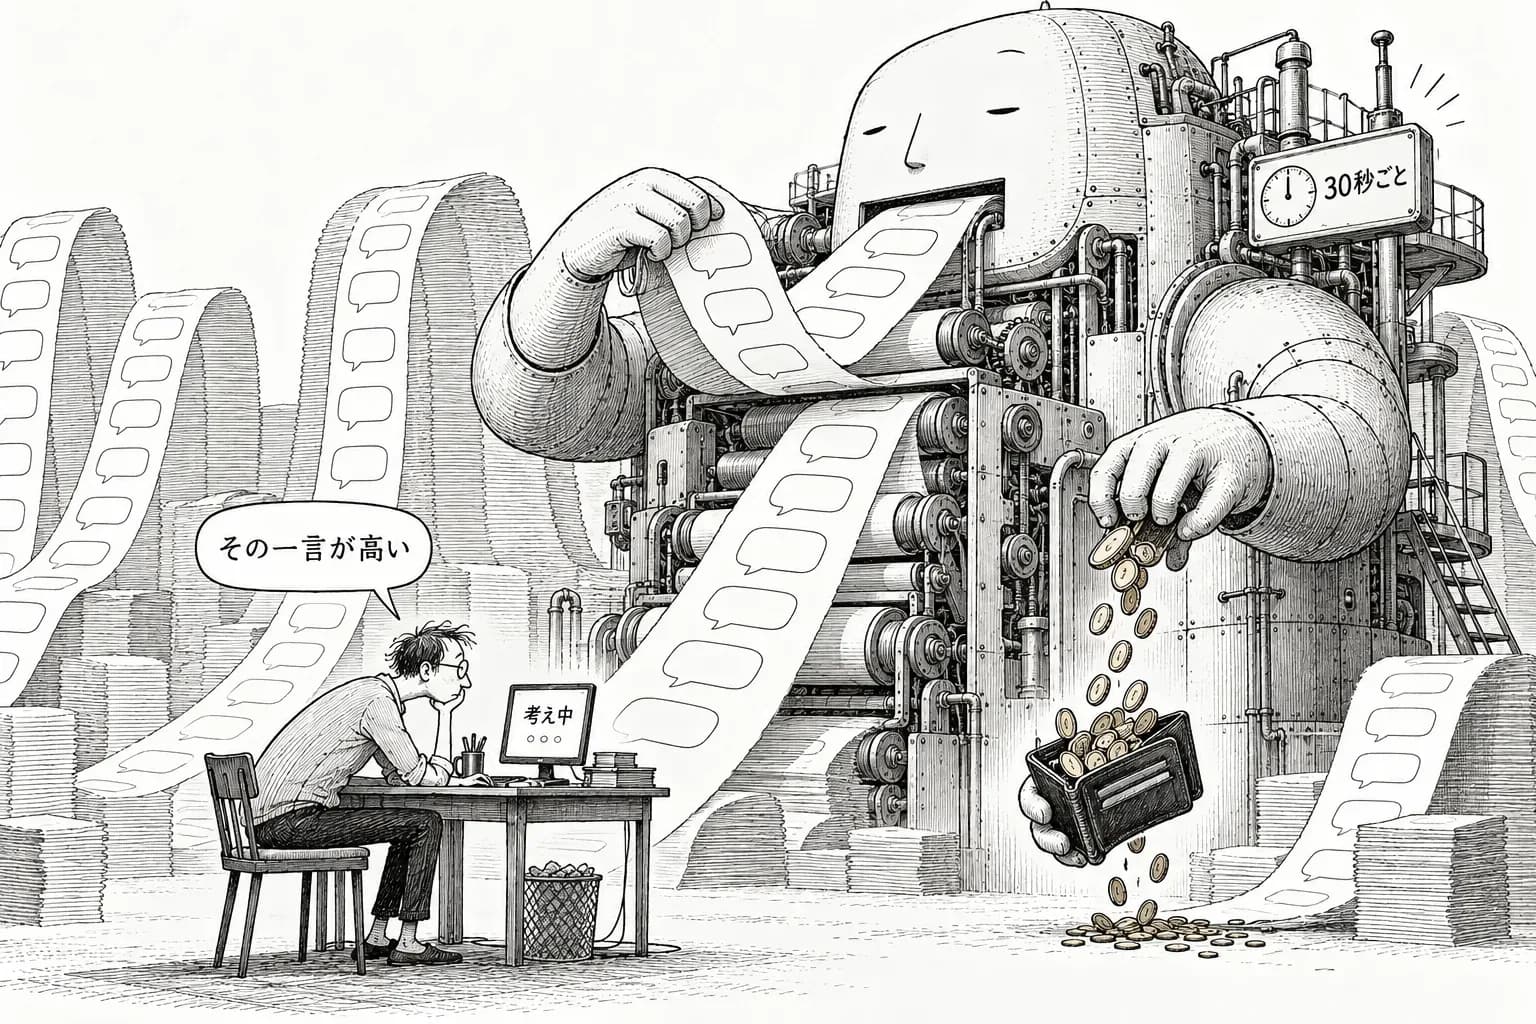
30秒ごとに会話記録を丸ごと送り直して、返ってくるのは3〜5語
発端は Flamerix AI が GitHub Gist に公開した分析。Claude Code は OpenTelemetry(ツールの動作記録を外に書き出す共通の仕組み)でログを出せるんだけど、Flamerix AI はそれを query_source(その呼び出しが何のためのものかを示すラベル)ごとに集計した。そしたら、バックグラウンドエージェントがいる対話セッションでは約30秒ごとに、各エージェントの会話記録を丸ごとモデルに送り直していたことがわかった。で、返ってくるのはパネルに出る3〜5語だけ。
数字がなかなか強烈なんだよ。1週間の推定支出のうち、この agent_summary の呼び出しは16.4%。本体の会話、つまり自分がAIとやりとりしてる部分(15.7%)より多い。API リクエストで見ても19.7%で、約5回に1回がこれ。入力と出力の比は約9,000:1。山ほど読ませて一言だけ返させてる、ってことだよね。しかも要約の支出の96%が Opus(Claude の中でも高いモデル)だった。高級レストランのシェフに30秒ごとに日報を全部読ませて「今なにしてる?」って一言だけ聞いてる感じ 🤔
この機能は v2.1.232(2026年8月)から既定で有効になっていて、測ったのは 2.1.257〜2.1.312。週あたりの支出に占める割合は、7月の3.5〜7%から10月には16%まで増えていた。Flamerix AI が集めたほかの4人の測定でも18〜26%だったそう。あわせて、バイナリ(Claude Code 本体のプログラム)に手を入れずに止める Bun のプリロードフック(起動時に先に読み込ませて動きを差し替える小さなスクリプト)no-agent-summary.js も公開している。
みんな自分の請求で確かめ始めた。16%の人もいれば3%の人もいる
この Gist は Hacker News で558ポイント・225コメントを集めた。面白かったのは、みんながすぐ自分の数字を出し始めたところ。simon83 さんは今週の自分の利用を API 価格に換算して、合計 $1,970 のうち表に出ない状態表示の呼び出しが約 $380(16%)だったと書いている。日本円にしたら月に数十万円の中の数万円が、パネルの数語のために消えてた計算だよね。
でも全員がそうだったわけじゃないんだよ。jake_kozaur さんは「多くても約8%」、_boffin_ さんは「チーム全体で約3%」だった。同じ機能なのに3%から20%超まで幅がある。ここ、この話でいちばん大事なところだと思う。
もっと細かい実測は、8月15日に立った anthropics/claude-code のイシュー #86879 にある。rflcrz さんは27個のサブエージェントを動かした1,496リクエストのセッションを調べた。agent_summary は339回(22.7%)、生のトークンで22.2%(6,270万トークン)、重み付けしたコストで18.0%。1回の出力は約65トークンしかない。文脈が38万トークンあるエージェントが1つあるだけで、状態表示だけで1時間に約4,500万キャッシュ読み取りトークン(前に送った内容を再利用するときに数えられる、割安だけどタダではない読み取り)になるという。間隔は30,000ms に固定。ほかの利用者からも、エージェントが10個以上だとリクエストの14〜26%、重み付けしたトークン支出の10〜22%という報告が寄せられている。
いちばんゾッとしたのはここ。この呼び出しは skipTranscript(会話記録に残さない設定)になっていて、コストを追うツールにも映らない。だから本当の消費が10〜26%少なく見える。Opus 5.5 の例では、キャッシュ読み取りが見える分11億8,400万トークンに対して、見えない分が3億3,800万トークンあったそう。ハーネス(AIモデルを包んで道具や画面とつなぐ外側の仕組み)の中で、請求には載るのに自分のダッシュボードには出ない呼び出しがある。これって Agent Observability(エージェントの動きをトレースで見えるようにすること)の盲点そのものだよね 💡
Anthropic の答え:全体なら約2%、でも「多いのは認める」
同じ Hacker News のスレッドに、Claude Code チームの edwinarbus さんが回答を書いている。Claude Code の全利用者で見ると、agent_summary は API 定価換算でコストの約2%、リクエストの4%弱、ターミナル利用に限ると約6%だという。16.4%は「ほぼバックグラウンドエージェントだけを回しているチームの数字で、典型的なセッションではない」とも述べている。
それでも「状態表示にしては多いことには同意する」とはっきり認めているんだよね。キャッシュが外れる場合の修正は v2.1.311 以降で入れた。今は、短いメモを小さいモデルに送るずっと安いやり方を開発中なんだって。つまり会話記録を丸ごと Opus に読ませるのはやめて、要点だけ軽いモデルに渡す方向。ハルとしては、ここは素直に良い回答だと思った。数字で反論しつつ、問題そのものは否定してないから。
ただ、2%と16%は矛盾してるわけじゃないんだよ。全員の平均には、エージェントを1本しか使わない大多数が入ってる。Fleets of agents(エージェントを大量に並列で回す運用)をやってる少数の人だけ見れば16〜22%になる。平均が小さいからといって、自分の請求が小さいとは限らない。逆に、自分が16%じゃないなら騒ぐほどでもない。結局は自分のトレースを見るしかない、ってことなんだよね。
止める手段は? 非公式フックは効くけど、正式な設定はまだ無い
止め方として出回っているのは、Flamerix AI の no-agent-summary.js。これを第三者の yoDEV が試したと報じられている。環境は macOS 27.0.1(Apple Silicon)と Claude Code 2.1.312 で、3つのバックグラウンドセッションを使った。デバッグログの [AgentSummary] Forking を数えると、フックなしで5回、pass モード(比較用に素通しさせる設定)でも5回、off モードで0回。呼び出しが消えることは確かめられた。でも yoDEV は、16.4%というコストの数字は検証していないと明記している。呼び出しは止まったけど、それでいくら浮くかはまだ誰も第三者として確かめていないってこと。
しかもこのフックは非公式で、Bun のタイマー(一定間隔で処理を起こす仕組み)に割り込むやり方なんだよ。Claude Code を更新するたびに、まだ効いているか確かめ直す必要がある。Flip-Engineering/baton にも、そのためのイシューが立ったという。公式の手段は今のところ CLAUDE_CODE_FORK_SUBAGENT=0 だけ。でもこれだと、サブエージェントをフォーク(親の文脈をコピーして分岐させること)する利点まで失う。状態表示だけ止めたいのに、エージェントの便利な機能ごと手放すことになるんだよね。
そして #86879 は8月から2か月以上開いたまま。以前、キャッシュの有効期限(TTL)をめぐるイシュー #46829 が「意図した最適化」として not planned で閉じられたこともあって、ユーザーの不信は根強い。スレッドでは、そもそもハーネスが肥大化しすぎだという批判や、「モデルを売る会社と、そのモデルを呼ぶハーネスを作る会社は分けるべきだ」という意見も目立っていた。呼び出しの回数を決める側と、その料金を受け取る側が同じ会社だからね。ここは気持ち、わかる 😅
ハルのまとめ:平均じゃなくて、自分のトレースを見よう
explainx はこれまでの数字を並べて整理したと報じられている。Flamerix の16.4%、#86879 の生のトークン22.2%・重み付け18.0%、Hacker News の「多くても約8%」。結論は、影響は確かにあるけど使い方次第で大きく変わる、というもの。効いてくるのは4つ。同時に動くエージェントの数、文脈の長さ、何もしていないのに起きたままのエージェント、そして Opus みたいな高いモデル。1つのセッションだけで普通に使うなら影響は小さいという。
ハルがいちばん面白いと思ったのは、これを見つけたのが Anthropic じゃなくてユーザーだったところ。OpenTelemetry の出力を query_source で割っただけで、見えない呼び出しが浮かび上がった。ハーネスエンジニアリング(エージェントの実行環境を設計すること)が流行ってるけど、使う側にも「自分のハーネスが裏で何を呼んでいるか」を数える力が要る時代になったんだなって思った。
やることはシンプルだよ。エージェントを何本も並べてるなら、まず自分のトレースで agent_summary の割合を出す。10%を超えてたら、回避フックを試すか、使わないエージェントをこまめに閉じる。フックを入れたら、更新のたびにデバッグログで Forking が0回になっているか確かめる。数%なら、Anthropic の安い版を待てばいい。「状態表示が16%」という見出しだけで慌てる必要はないけど、自分で測ってないなら、それがどっちなのかもまだわからないんだよね 📊